加权仲裁器验证:权重配比统计、饿死检测与动态改权
更新时间:2026-09-29。轮询仲裁器的验证方法(授权唯一性、公平性窗口)在 轮询仲裁器验证:公平性断言与覆盖率收口 已经讲过,仲裁器本身的公平性原理见 Round-Robin 仲裁器公平性:从指针到无饿死证明。加权仲裁器(Weighted Round-Robin,WRR)在这之上多了一个维度:授权不仅要「轮得到」,还要「按配比率轮」。这一篇只讲加权带来的三个新验证点——配比统计、饿死检测、动态改权。
本文要回答的问题
- 「权重 5:3:2」这种配比,用断言逐拍检查为什么不可行,正确的统计检查怎么做?
- 配比覆盖率模型该覆盖哪些 bins,怎么才算收口?
- 低权重端口的「饿死」窗口上界怎么算、怎么断言?
- 运行时改权重(软件写配置寄存器)为什么是最容易漏测的场景,怎么补?
一、为什么逐拍断言查不了配比
轮询仲裁器的公平性可以用一条「任意端口请求后 N 拍内必获授权」的 SVA 干净地表达。加权仲裁器不行:权重 5:3:2 描述的是长期统计比例,不是任何有限窗口内的确定行为。一个完全正确的 WRR 实现,连续 20 拍全授给权重 5 的端口都是合法的(比如该端口独占请求,或调度序列恰好走到它的高权重段)。
所以第一条纪律:配比是统计属性,归覆盖率和 scoreboard 管,不归即时断言管。断言只管那些有确定上界的性质——授权唯一性、授权必给请求者、以及后面讲的饿死上界。
配比统计的经典做法是 scoreboard 里维护两个计数器数组:
// scoreboard 片段:按端口统计请求数与授权数
int unsigned req_cnt [NPORT];
int unsigned gnt_cnt [NPORT];

always @(posedge clk) begin
  for (int i = 0; i < NPORT; i++) begin
    if (req[i]) req_cnt[i]++;
    if (gnt[i]) gnt_cnt[i]++;
  end
end

// 检查窗口结束时比对:授权占比应逼近权重占比
function void check_ratio();
  real expect[NPORT], actual[NPORT];
  int  total_gnt = gnt_cnt.sum();
  int  total_w   = weight.sum();
  foreach (gnt_cnt[i]) begin
    expect[i] = real'(weight[i]) / real'(total_w);
    actual[i] = real'(gnt_cnt[i]) / real'(total_gnt);
    if (abs(actual[i] - expect[i]) > TOLERANCE)
      `uvm_error("RATIO", $sformatf(
        "port %0d: expect %.3f actual %.3f", i, expect[i], actual[i]))
  end
endfunction这里有两个工程细节决定检查是否有意义。第一,必须在满负荷(all-requesting)激励下统计:只有所有端口都在抢,配比才由权重唯一决定;稀疏流量下配比由流量形状决定,查不出设计 bug。第二,容差要随窗口长度收紧:统计涨落按 1/sqrt(N) 收敛,10 万拍窗口下 5:3:2 的配比偏差应压到 1% 以内;窗口只有 1000 拍时放到 5% 是合理的。把 TOLERANCE 写成窗口长度的函数,比拍脑袋定一个固定值少很多误报。
二、配比覆盖率模型:bins 怎么划
统计检查回答「这一次回归的比例对不对」,覆盖率回答「我们试过多少种比例组合」。WRR 的配比空间是巨大的(N 个端口各自权重 0~W_MAX),不可能穷举,coverage 模型的价值在于把空间切成有语义的格点。
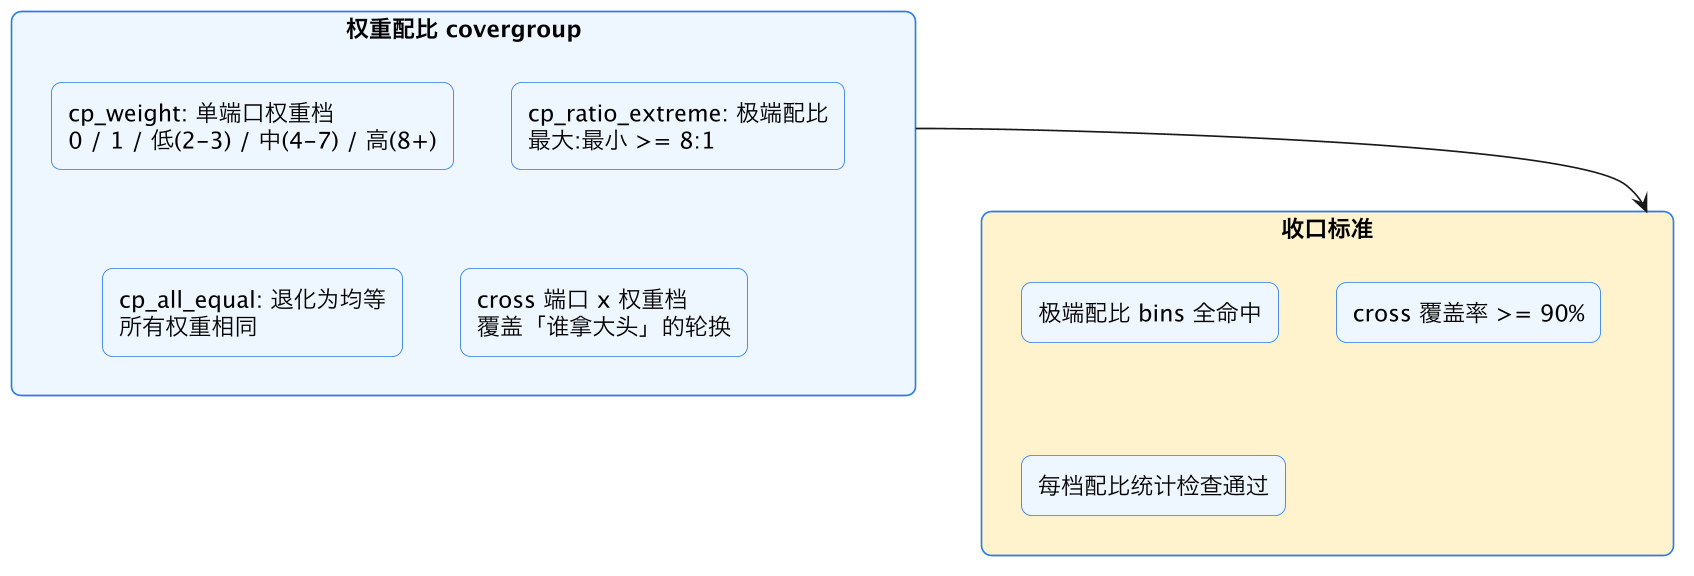
这张图是配比覆盖率模型的骨架。三个 coverpoint 各有明确指向:cp_weight 按档位而不是逐值覆盖单端口权重,因为权重 5 和权重 6 的行为差异没有验证价值,0、1、饱和值才是边界;cp_ratio_extreme 专盯极端悬殊配比——这是实现里最容易出错的地方(内部计数器位宽、取整方式在 8:1 时会现形);cp_all_equal 覆盖退化为普通轮询的场景,保证加权逻辑没有破坏均等语义。cross 则回答「高权重落在每个端口上都试过吗」。右侧收口标准里最关键的一条是极端配比 bins 必须全命中——它是 allowed bins,不是 nice-to-have;收不齐说明约束随机激励的权重分布太「温和」,要去改激励而不是降 goal。
配套激励侧的建议:权重不要均匀随机,用分层分布——三成用例跑极端配比(一端 8~15,其余 1),三成跑全等,四成跑中庸混合。极端配比比中庸配比出 bug 的概率高一个量级,激励分布要反映这一点。
三、饿死检测:把「公平」翻译成有上界的等待
加权仲裁器允许低权重端口等得久,但不允许永远等不到。「等得久」的上界可以算出来:经典 WRR 一个完整调度周期内授权总数是 sum(weight),期间每个有请求的端口恰好拿到 weight[i] 次授权。因此端口 i 连续两次授权之间的最大间隔上界正比于 sum(weight) / weight[i] 个「有竞争的拍」。这给了我们一条有确定上界的断言:
// STARVE_BOUND = ceil(sum(w)/w[i]) * C,C 为实现相关常数
ap_no_starve: assert property (
  @(posedge clk) disable iff (!rst_n)
  req[2] && !gnt[2] |-> ##[1:STARVE_BOUND] gnt[2]
);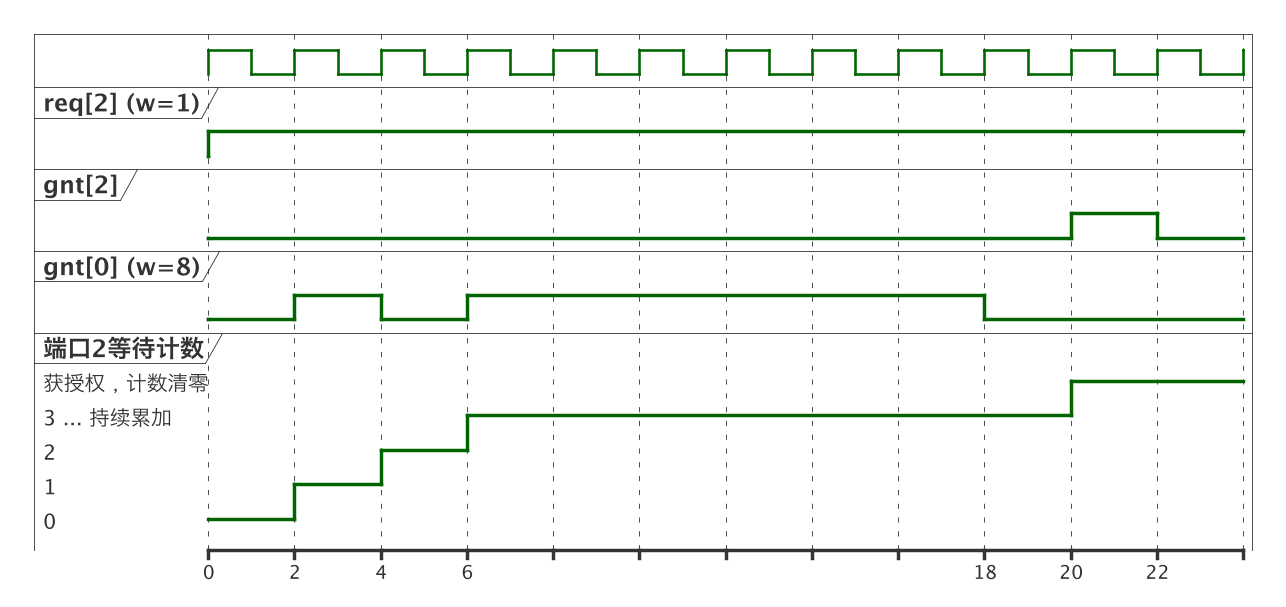
波形图里权重 8 的端口 0 连续拿走授权,权重 1 的端口 2 等待计数一路累加,直到第 20 拍才轮到——这是合法行为,STARVE_BOUND 必须放得比这个最大合法间隔更宽,否则断言会对正确实现报假失败;但又不能放到无穷大,否则失去检测力。实用口径:上界取理论最坏值的 1.5~2 倍,既容忍实现细节(信用预取、流水气泡),又能抓住「低权重端口被遗忘」的真 bug——比如更新指针时跳过了权重未耗尽的端口。回归里可以再加一条 directed 用例:把某端口权重配到 1、其余配到 15,满负荷跑,专看它是不是每次都在上界内拿到授权。
四、动态改权:最容易漏测的场景
前三节都是静态权重下的验证。真实芯片里权重多半挂在配置寄存器上,软件运行时随时会改——而 WRR 的内部状态(各端口剩余信用计数)是按旧权重累积的,改权瞬间的状态处理是 bug 重灾区:有的实现直接清信用导致正在亏空的端口白等,有的不清导致新权重要滞后一个周期才生效,规格书往往还没写清哪种是对的。
验证动作分三步。第一,激励侧把改权事件做成 sequence:在满负荷流量中段随机改写权重寄存器,改完继续打流,一个用例里改多次。第二,检查侧对改权前后分段统计:改权前的窗口按旧权重验配比,稳定若干拍后的新窗口按新权重验配比,中间的过渡期单独标记、不参与配比断言,但要查过渡期有上界——改权后 N 拍内配比必须收敛到新比例。第三,覆盖率加一个 cross:改权方向(升权/降权/平移)× 改权时刻该端口的信用状态(富余/亏空)。「降权恰好砸在信用亏空的端口上」这个 bin 是最阴的,实现的取整和饱和逻辑在这里最容易翻车,必须命中。
如果规格允许「权重写 0 = 屏蔽该端口」,还要补一条断言:权重为 0 的端口永远不得获授权,即使它在请求。这一条在静态验证里常被 assume 掉,动态改权场景下必须显式查。
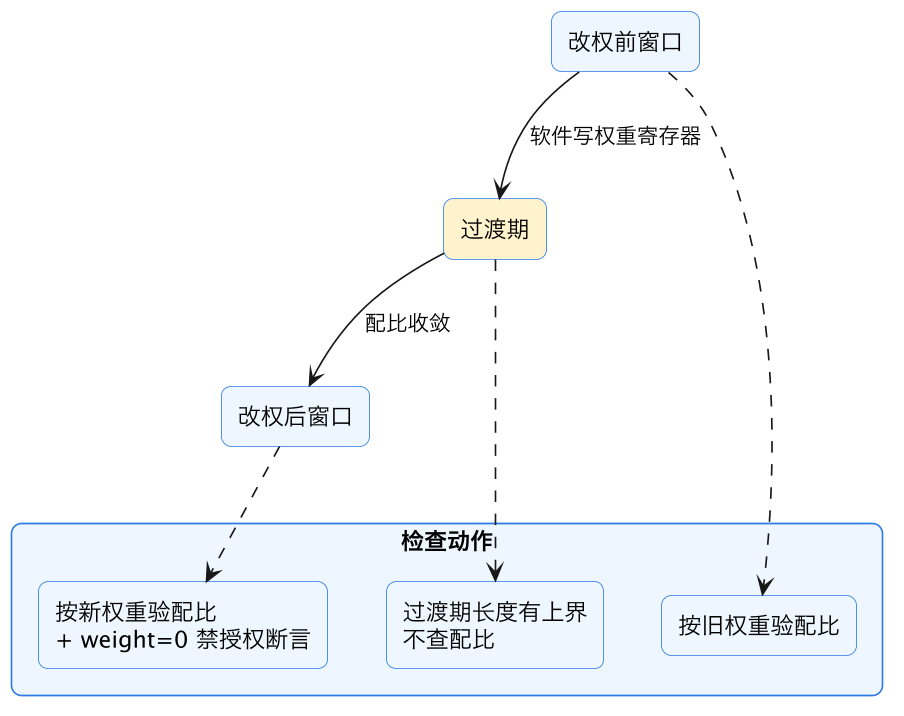
上图把改权用例切成三段窗口,每段挂不同的检查。关键是中间的过渡期:不对它做配比断言(统计上必然不满足任何一组权重),但对它的长度做上界断言——「改权永远不生效」这种 bug 只有这一条能抓住。三段合起来,动态改权从「顺手测过」变成「每一段有明确判据」。
这一篇在知识体系里的位置
- 前导:轮询仲裁器验证:公平性断言与覆盖率收口 建立了授权唯一性、公平性窗口的通用打法,本篇在其上加权。
- 原理:Round-Robin 仲裁器公平性:从指针到无饿死证明 解释了饿死上界的来源,本篇 STARVE_BOUND 的理论依据在此。
- 工具:配比分档与 cross 设计的通用方法见 覆盖率模型:covergroup 与 bins 设计;统计检查的激励框架见 UVM sequence、driver 与 scoreboard。
总结
加权仲裁器验证的要义是把「比例」和「公平」分开治理:配比是统计属性,交给满负荷激励下的 scoreboard 计数加容差比对,用分档 covergroup 和极端配比 bins 收口;饿死是有时序上界的属性,按 sum(w)/w[i] 推出 STARVE_BOUND 写断言;动态改权是最易漏的场景,要切「改权前-过渡期-改权后」三段窗口分别挂检查,并补「权重为 0 端口永不授权」的显式断言——静态配比绿、饿死上界绿、改权过渡有界,WRR 才算验完。