MoE 容量因子:token drop、溢出与延迟-质量权衡的完整账本
更新时间:2026-10-03。前面 MoE 路由机制 讲过 gate 怎么给 token 选专家、auxiliary loss 怎么把路由拉均衡;MoE 专家并行 serving 讲过专家怎么切到多张卡上、all-to-all 怎么换数据。这两篇解决的是「token 去哪」和「专家放哪」,但中间还卡着一个更现实的问题:每个专家的缓冲区就那么深,路由分给它的 token 塞不下怎么办? 答案就是 capacity factor(容量因子)——一个看似不起眼的超参数,直接决定 token drop(丢 token)率、显存占用和尾延迟三条曲线。本篇把这个数的定义、它在哪里咬人、以及推理和训练两侧怎么分别定值讲透。
本文要回答的问题
- capacity factor 的准确定义是什么,它和 expert capacity 是什么关系?
- token drop 到底发生在哪里,被丢的 token 走了什么路径,对质量伤害多大?
- 为什么推理侧的容量压力比训练侧更难预料,prefill 和 decode 的口径差在哪?
- 容量因子调大调小各自付出什么代价,延迟-质量权衡曲线长什么样?
- 工程上有什么替代方案(溢出重路由、无 drop 路由)可以绕开硬丢?
一、定义:capacity 是按「平均值」放大出来的缓冲深度
先建立符号。一个 MoE 层里:批次内 token 总数为 T,专家数为 E,每个 token 路由到 top-k 个专家(常见 k=1 或 k=2)。那么全部路由决策产生的「token-专家配对」总数是 T×k,平均每个专家分到 T×k/E 个 token。
如果路由绝对均衡,每个专家正好收 T×k/E 个。但路由是学出来的,真实分布永远歪斜:热门专家收到均值的两三倍不稀奇。工程上不可能按「最倒霉的专家」来分配内存——那样显存预算直接爆炸。于是引入容量因子:
expert capacity = ceil(capacity factor × T×k / E)
即先算平均负载,再乘一个放大系数 CF(capacity factor),结果向上取整,就是每个专家的缓冲区深度。CF = 1.0 意味着「按平均值配缓冲」,任何超出均值的倾斜都会溢出;CF = 2.0 则允许最热的专家吃到平均负载的两倍才开始丢。

上图的关键点是:capacity 是在 kernel 启动前就定死的静态值。MoE 层的专家计算通常按分组 GEMM(grouped GEMM)组织,所有专家的输入被拼成定长块并行算,块的大小就按 capacity 分配。这意味着即使某个专家这轮只收到 3 个 token,它照样占着 capacity 那么大的缓冲和算力名额;而收到 3 倍均值的专家,超出的 token 进不了缓冲,只能走「溢出路径」——最常见的溢出路径就是直接丢弃。
二、token drop:被丢的 token 并没有消失,只是「跳过了专家」
丢 token 听起来吓人,实际机制要温和一些。以 Switch Transformer(k=1)的经典实现为例:token 被路由到专家 e,但专家 e 的缓冲已满时,这个 token 在这一层不经过任何专家计算,它的表示直接通过残差连接(residual connection)原样传到下一层。也就是说 token 的「主流」还在,只是少了一次专家加工。
伤害来自两点。其一,MoE 模型的能力恰恰存储在专家权重里,跳过一次专家约等于这一层对这个 token「失能」,多层叠加后该 token 的表示质量明显下降。其二,drop 不是均匀的:被丢的往往是路由分数(router score)排不进去的那批——实现上通常按分数从高到低填缓冲,分低的先被丢。而低分 token 恰恰是 router 自己都「拿不准」的 token,它们可能正是最需要专家处理的难样本。这是个隐性的负选择。
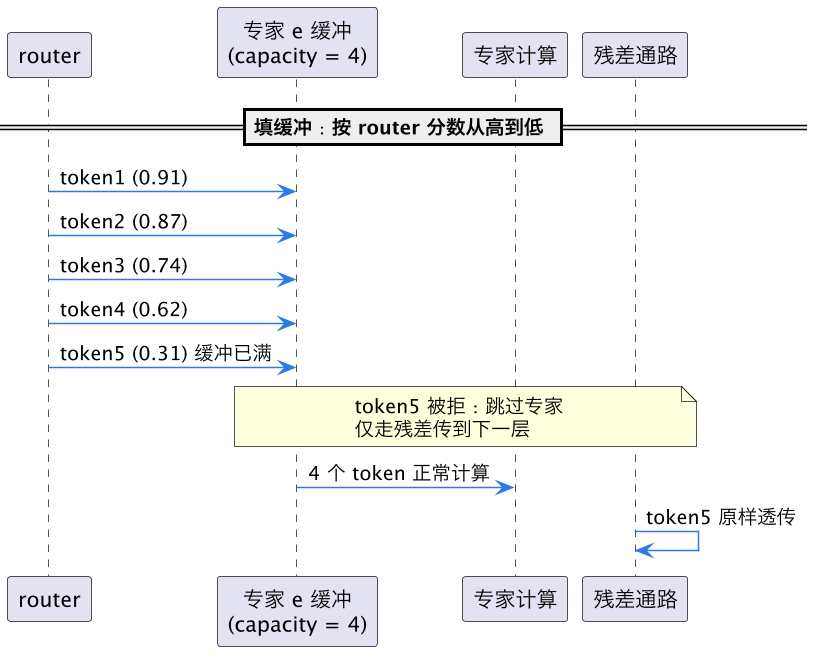
图中展示的「按分数排序填充」是主流框架的做法,它保证留下的都是 router 最有信心的配对。推理时另一个细节:k=2(每个 token 选两个专家)的模型里,常见策略是只保证第一专家,第二专家溢出就丢——因为第一专家分数更高、贡献更大。GShard 当年就是这么做的,这个惯例沿用至今。
drop 对质量的影响有实测数据:Switch 论文报告 CF 从 1.0 提到 1.5,训练 loss 有可见改善;推理侧社区经验是 drop 率超过 1% 后下游任务分数开始可测地下滑,超过 5% 则明显劣化。1% 听起来宽松,但注意它是全层全 token 的平均,热点专家局部 drop 率可能是平均值的几十倍。
还有一个容易被忽略的连锁反应:drop 会反过来污染 KV cache。被跳层的 token 带着「半成品」表示进入注意力,它产出的 K、V 也被写进 cache,后续所有 token 对它的注意力都建立在这个受损表示上。decode 阶段这个效应会跨步累积——第 t 步被丢的 token,在第 t+10 步还在向全序列广播它的低质量 K/V。这也是为什么在线服务对 drop 率的容忍度比离线评测更紧:离线评测一条样本丢几个 token 只是这条样本分数差一点,在线长对话里丢的 token 会持续污染上下文。
三、推理侧为什么更疼:负载分布不可控且不可平均
训练侧定 CF 相对从容:auxiliary load-balancing loss(负载均衡辅助损失)长期压着路由往均摊方向走,batch 是自己采的、长度固定,负载分布平稳,CF=1.0~1.25 就够。推理侧完全是另一个世界,压力来自三个不可控。
第一个不可控是输入分布漂移。线上流量里突然出现一大批代码请求,而代码 token 集中涌向少数几个「代码专家」——auxiliary loss 管的是训练期平均,管不了今晚的流量倾斜。第二个是batch 组成随调度器变化:continuous batching(连续批处理,见 continuous batching 调度器)下每轮的 token 数是动态的,突发大 batch 时 T 暴涨,而 capacity 是 T 的函数,实现里要么按最大 batch 预分配(浪费显存),要么按当前 batch 动态算(capacity 跟着抖)。第三个是 prefill 与 decode 的不对称:prefill 一次处理成百上千 token,T 大、均值缓冲深,相对好配;decode 每轮每请求只产 1 个 token,T 小,capacity = ceil(CF×T×k/E) 的取整效应和离散性都被放大——比如 T×k/E = 7.3,ceil 到 8,再来一个热点专家收 9 个就丢,波动容差极小。

上图总结了三种场景的容量压力差异。工程结论:推理部署的 CF 通常要高于训练,社区实践中 decode 阶段 CF 给到 1.5~3 不罕见,或者干脆改用后面第五节讲的无 drop 方案。
具体看一个 decode 小样本的数感例子。假设模型 64 个专家、top-8(DeepSeek-V3 的规格),decode 一轮有 32 个请求在跑:配对总数是 32×8 = 256,平均每专家 4 个 token。capacity = ceil(CF×4),CF=1.5 时每专家只有 6 个坑位。64 个专家分 256 个配对,在真实 router(带偏置但远非完美均衡)下,最热专家收到 8~12 个配对是常态——CF=1.5 意味着这一轮必然丢,CF=2.5(10 个坑位)才勉强兜住。而同样的模型在 prefill 阶段,一轮 4096 token,平均每专家 512 个配对,路由分布的大数定律开始起作用,最热专家通常不超均值的 1.3 倍,CF=1.25 就相当从容。同一层在两个阶段需要差近一倍的 CF,这就是「prefill/decode 分离部署」在 MoE 时代多出来的理由。
四、权衡账本:CF 每加一档,显存和尾延迟都在付账
CF 调大看起来是万能药,但账本上每一笔都有代价。
显存代价最直接:专家输入缓冲、激活、分组 GEMM 的 workspace 全按 capacity 分配,CF 翻倍这部分显存就近乎翻倍。对 KV cache 推理显存 已经吃紧的 serving 系统,MoE 缓冲和 KV cache 在抢同一块显存。
延迟代价更隐蔽。MoE 专家层的耗时由最重的那个专家的 capacity 决定——分组 GEMM 是同步发起的,所有专家一起开算、一起等齐。更要命的是专家并行(EP,expert parallelism)下还有 all-to-all:每张卡把本地 token 按目标专家换出去,通信量同样按 capacity 对齐补齐(padding)。于是 CF 调大,每轮 all-to-all 的通信量和每个专家的计算量都按「最大可能负载」付账,而实际负载往往远低于此——你为用不到的缓冲付了延迟。尾延迟尤其敏感:P99 那几轮恰好是大 batch 加热门专家,CF 小了 drop 爆掉,CF 大了每轮都变慢。

实务上的定值流程是:拿线上或仿真的真实流量,跑一遍 router 统计每层每专家的负载分布,取 P99(甚至 P999)负载与均值的比值作为 CF 下限,再在压测里验证这个 CF 下 P99 延迟达标。DeepSeek-V3 的部署实践还加了一层:prefill 和 decode 分开部署、分别定 CF,正是第三节那个不对称性的直接应对。
| 维度 | CF 偏小(1.0 上下) | CF 偏大(2.0 以上) |
|---|---|---|
| token drop 率 | 高,热点专家局部可达两位数百分比 | 接近 0 |
| 显存占用 | 省 | 缓冲与 workspace 近翻倍 |
| 单轮延迟 | 低 | GEMM 与 all-to-all 按最大负载付账 |
| 尾延迟 P99 | 质量尾差(drop 爆) | 时延尾差(轮轮变慢) |
| 适用 | 训练、离线吞吐型推理 | 在线质量敏感推理 |
五、绕开硬丢的三条路:溢出重路由、无 drop 路由、动态容量
如果不想在「丢」和「贵」之间二选一,社区给出了三条替代路线。
第一条是溢出重路由(overflow rerouting):第一专家满了,就把 token 塞给它的第二、第三选择,还不行才丢。这把 drop 变成「降级」——token 仍被某个专家处理,只是不是最优那个。代价是路由逻辑变复杂,且次优专家本身也可能是热点。
第二条更激进:无 drop 路由。代表是 Expert Choice(让专家挑 token,每个专家固定收 capacity 个它最想要的 token,天然无溢出)和各类 token-choosing 变体;推理框架侧的做法是干脆不截断,按实际负载动态 padding 到本轮最大值,配合 tensor parallel 通信重叠 把波动摊掉。DeepSeek-V3 系搭配的无辅助损失均衡策略(给 router 加可学习的偏置项动态调节)也属于这条路——从源头把分布调平,让缓冲永远够用,而不是事后处理溢出。
第三条是动态容量:容量不再静态,而是每轮根据实际路由结果分配。难点在 grouped GEMM 需要定长块,动态意味着每轮重排输入、变长 kernel,工程复杂度高;vLLM 等框架的做法是折中——按 batch 规模分几档预设 capacity,运行时选档。
三条路不是互斥的。一个务实的在线 serving 配置常常是:偏置均衡把分布调平(源头治理)+ 适中 CF(比如 1.25~1.5)兜底 + 溢出重路由处理残余尖峰。纯靠堆 CF 是最贵的解法。
最后补一个监控口径的建议:CF 定完不是一劳永逸,线上要持续盯三个指标——每层的全局 drop 率(红线 1%)、每层最热专家的实际负载与 capacity 的比值(长期贴着 1.0 说明 CF 偏紧,长期低于 0.5 说明白配了缓冲)、以及 P99 轮时延中 MoE 层的占比(占比上升说明 padding 付账变多)。流量主题会随业务漂移,三个月前测的路由分布今天未必成立,CF 应该像 KV cache 水位一样纳入容量管理的常规巡检。
这一篇在知识体系里的位置
本篇是 MoE 系列的负载均衡深水区:上游是 MoE 路由机制(gate 与辅助损失怎么让 token 均摊——CF 问题的前提)和 MoE 专家并行 serving(all-to-all 与 EP 切分——CF 代价的放大器);同层对照 continuous batching 调度器(动态 batch 如何搅动容量计算)、KV cache 推理显存(与 MoE 缓冲争抢显存的另一方)和 batch 延迟吞吐曲线(尾延迟分析的通用框架);下游延伸是 Expert Choice 等无 drop 路由算法的专题。
对读者来说,落地顺序建议是:先想清楚自己的场景吃不吃得起 drop(离线批处理可以吃,在线对话尽量不吃),再决定走「调 CF」还是「换路由方案」的路线,最后用真实流量数据说话,不要拿训练默认配置直接上线。
总结
MoE 容量因子是「按平均负载放大多少倍配专家缓冲」的杠杆:调小了,超出缓冲的 token 被按分数从低到高丢弃、靠残差裸传,热点专家局部 drop 率爆表伤质量;调大了,显存、分组 GEMM 和 all-to-all 全按最大可能负载白付账,轮轮变慢——训练侧靠 auxiliary loss 压均衡,CF 1.0~1.25 即可,推理侧流量不可控、decode 小 batch 取整效应放大波动,需按线上路由分布的 P99 定值(常见 1.5~3)或改用溢出重路由、偏置均衡、动态容量等无 drop 方案,把「丢 token」和「白付延迟」这两笔账同时压下去。