clocking block 竞争:#1step/#1ns 输入输出偏斜如何消除 testbench 与 DUT 的 race
更新时间:2026-10-01。在 clocking block 与 testbench 同步 里我们说过:clocking block 存在的全部意义,就是给 testbench 和 DUT 之间划一条「谁先看、谁后动」的时间线。这一篇往下钻一层,专讲那条时间线背后的 race(竞争)问题——为什么不用 clocking block 直接驱动接口会偶发翻车、
#1step和#1ns这两个偏斜参数各自把动作挪到了仿真调度器的哪个 region、以及 region 语义懂了之后怎么一眼看穿残余的竞争 bug。关于 clocking block 本身的语法骨架,可对照 SV interface 与 clocking block;program block 调度见 SV program 与 final 调度。
本文要回答的问题
- testbench 和 DUT 在同一个时钟沿读写同一根信号,race 到底是怎么发生的?
- SystemVerilog 的 region 调度(Active/Reactive/NBA 等)和 race 是什么关系?
#1step输入偏斜到底采样的是「哪个时刻」的值,为什么它天然安全?#1ns之类的输出偏斜为什么能消除驱动竞争,单位用 time 还是 cycle 怎么选?- 加了 clocking block 之后还有哪些残余 race 场景,怎么排查?
一、竞争从哪里来:同一个沿上的读和写
先看没有 clocking block 时的经典事故现场。testbench 里写:
always @(posedge clk) begin
  req  <= 1;
  data <= payload;
end
DUT 里也写:
always @(posedge clk) begin
  if (req) latch <= data;
end
两边都堵在 @(posedge clk) 上。仿真器在同一个时间槽里要唤醒两个进程:一个写 req,一个读 req。谁先跑?SystemVerilog 标准说:同一个 region 里进程的执行顺序不确定——仿真器可以任意排序,今天 VCS 先跑 testbench,明天 Xcelium 先跑 DUT,甚至同一家仿真器换个版本、换个编译优化选项,顺序就变。后果是 DUT 读到的 req 可能是旧值也可能是新值,行为「有时候对有时候错」,最典型的 race 症状:同一个种子同一套代码,批回归里偶发 fail,本地重跑又过。
更阴险的是非阻塞赋值(NBA)混进来的情况。DUT 用 <= 写内部状态,testbench 在同一沿用阻塞赋值 = 采样 DUT 输出——testbench 在 Active region 读到的是 NBA 更新之前的旧值,看起来「晚了一拍」。很多人把这种错当成「环境时序 bug」去调激励,越调越乱,其实根子是调度语义没对齐。
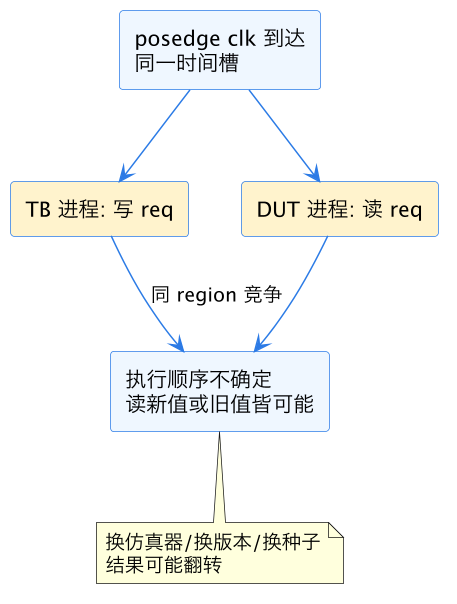
上图是 race 的最小模型:不是谁的代码错了,而是「同一时间槽里两个进程的顺序未被定义」。消除 race 的本质不是赌顺序,而是把读和写搬进不同的 region,让调度规则替你保证先后。
二、region 语义:race 的裁判规则
SystemVerilog 把一个时间槽切成一串依次执行的 region,和本话题最相关的四个:
| region | 干什么 | 谁在这活动 |
|---|---|---|
| Preponed | 采样断言用的值,一切赋值之前 | SVA 采样、$sampled |
| Active | 执行阻塞赋值、always 主体 | DUT 的 RTL、TB 裸代码 |
| NBA | 非阻塞赋值真正生效 | <= 的右值落地 |
| Observed/Reactive | 断言求值、property 触发 | SVA 检查 |
| Reinactive/Postponed | $monitor、$strobe 收尾打印 | 观测型系统任务 |
(上表按时间槽内执行先后排列,Reactive 区域是 program block 的底盘,详见 SV program 与 final 调度。)
DUT 的 RTL 活动在 Active/NBA;如果 testbench 也用裸 @(posedge clk),它同样落在 Active——两个 Active 进程挤在一起,就是上一节的 race。clocking block 的全部魔法,就是用输入/输出偏斜把 TB 的采样提前到 Preponed 时刻的语义等价点、把 TB 的驱动推迟到 NBA 之后,从 region 层面把两边错开。
三、#1step 输入偏斜:采样上一拍末的稳定值
输入偏斜决定「clocking block 读 DUT 信号时,读的是哪一刻的值」。input #1step 的语义是:在时钟沿到来之前一个 time step(当前时间精度下的最小单位) 采样——也就是上一个时间槽彻底稳定之后的值,等效于 Preponed 采样。
clocking cb @(posedge clk);
  default input #1step output #1ns;
  input  req, data;      // 沿前 1step 采样
  output grant;          // 沿后 1ns 驱动
endclocking
为什么 #1step 天然安全?因为它采样的时刻严格早于当前沿的任何 Active/NBA 活动。DUT 在这一沿要更新的输出还没来得及动,TB 读到的是「上一拍结束时的确定值」——这正是同步设计的语义:一拍之内信号视为常量。对比之下,如果写成 input #0,采样落在 Active region,又回到赌顺序的老路;#0 是 clocking block 最常见的误用,见到就该打回。
monitor 里的用法随之定型:@cb; sample(cb.req, cb.data);——等沿、读值,拿到的永远是干净的一拍。这也是 scoreboard 时序能对齐的前提,对齐方法见 UVM scoreboard trace 对齐。
四、#1ns 输出偏斜:把驱动推到 NBA 之后
输出偏斜决定「TB 写 DUT 信号的动作落在沿后多远」。output #1ns 表示时钟沿之后 1ns 才驱动。到那一刻,DUT 在这个沿上的 Active 采样(if (req) 那次读)早已结束——DUT 读到的是沿之前的旧值,TB 的新值从下一拍起才被看到。读写被 1ns 的物理间隔彻底隔开,顺序再无悬念。
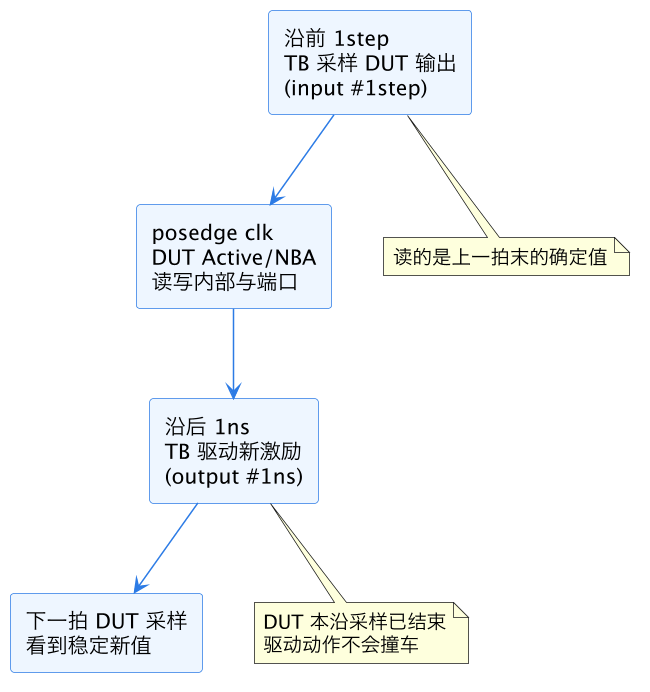
上图把两个偏斜画成了一条时间轴:#1step 守在沿的左侧负责读,#1ns 守在沿的右侧负责写,DUT 的全部沿上活动被夹在中间,三方永不碰头。这就是「clocking block 竞争」问题的标准答案。
选偏斜数值时两条经验:一是 #1step 不要改成具体的 #1ps——#1step 跟随时间精度自适应,写死小数值在换 timescale 的工程里会翻车;二是输出偏斜的单位既可以用绝对时间(#1ns)也可以用周期分数(部分团队用 #0.1 配合 `timescale 控制),原则是「显著大于 0、显著小于半个周期」,且远小于 DUT 内部任何门级延迟——门级仿真带 SDF 时尤其要确认偏斜不会被真实时序淹没,相关背景见 门级仿真 SDF 与 X 传播。另外别忘了用 modport 约束方向,让 TB 侧只能通过 clocking block 访问信号,写法见 SV interface 与 modport。
五、残余 race 与排查清单
挂上 clocking block 不等于一劳永逸,残余 race 几乎都出在「绕过 clocking block」的地方:
- TB 里有人直接
@(posedge clk)裸读写接口信号,绕过 cb,回到 Active 赌顺序。排查:grep 全环境对同一 interface 信号的引用,凡是不带cb.前缀的都可疑。 - 复位信号不走 clocking block。异步复位的释放沿如果和时钟沿撞车,DUT 内部寄存器对复位释放的采样同样 race。做法:复位释放也经 cb 同步驱动。
- 同一个信号被两个进程驱动(driver 和 fault-injection 的 force 并存),波形上看 drivers 视图立现。
input #0或漏写 default skew,部分信号回退成零偏斜。- 时钟分频/门控场景下 cb 的时钟表达式写错,采样沿和 DUT 实际工作沿错位,表现为「隔拍错」而非经典 race,更隐蔽。
多时钟域环境还要再加一条:每个时钟域一个独立 clocking block,跨域信号(如异步 FIFO 的格雷码指针)不要塞进任何一个 cb 里裸采样——跨域信号本身没有「沿前稳定值」可言,正确做法是先经两级同步器进本域,再进 clocking block。把跨域信号当同步信号采样,会产生比 race 更隐蔽的亚稳态假值。
排查动作三板斧:波形 drivers 视图看多驱动;把 TB 与 DUT 对同一信号的读写时刻都打印出来对齐时间戳;检查环境里所有 @(posedge 是否都应换成 @cb。团队级预防则靠 lint 规则:禁止 TB 代码绕过 clocking block 直接读写 interface 信号,禁止 input #0,这两条做成 CI 门禁后,race 类缺陷基本绝迹。顺带一提,race 产生的 X 若沿数据通路蔓延,判读规则可对照 SV 2 态 4 态与 X/Z 传播。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下的长尾深文,向上承接 clocking block 与 testbench 同步 的同步语义与 SV interface 与 clocking block 的语法骨架,横向与 SV program 与 final 调度 共享 region 调度视角,门级语境下的延伸见 门级仿真 SDF 与 X 传播,数据对齐落地看 UVM scoreboard trace 对齐。
总结
clocking block 竞争的根因是 testbench 与 DUT 在同一时钟沿的同一 region 里赌执行顺序;input #1step 把 TB 采样锚定在沿前一个 step 的稳定值,output #1ns 把 TB 驱动推到沿后 DUT 采样结束之后,读写被 region 语义物理隔开;残余 race 几乎都来自绕过 clocking block 的裸访问、复位不同步和 #0 偏斜,按 drivers 视图与时间戳对齐逐个清剿即可。