投机解码:draft/verify 两段式、接受率与加速比上限
更新时间:2026-09-29。在推理引擎 运行时调度里我们讲过:LLM 的 decode 阶段每生成一个 token 都要完整跑一遍大模型前向,batch=1 时这是纯粹的访存带宽瓶颈——几百 GB 的权重从 HBM 搬进来,只为算一个 token,算力大量闲置。投机解码(speculative decoding)就是冲着这个闲置算力来的:既然一次前向的算力绰绰有余,那就让它一次「顺便」验证好几个 token。理解本篇需要的前置是注意力与 KV cache 的机制(见 Transformer 注意力 kernel),以及量化对草稿模型成本的影响(见 INT8/INT4 量化与校准)。
本文要回答的问题
- 投机解码的 draft/verify 两段式到底怎么跑?为什么验证阶段可以一次前向检查多个 token?
- 为什么投机解码是「无损」加速——输出分布和逐 token 生成完全一致?
- 接受率由什么决定?加速比的数学上限怎么从接受率推出来?
- 工程上草稿模型怎么选?Medusa、EAGLE 这类「自起草」方案省了哪一步?
一、decode 阶段的瓶颈:带宽闲着算力,投机就是把它用起来
先回忆 decode 的算术强度。假设模型权重 70B 参数、FP16 存储,一次前向要读约 140 GB 权重。在 HBM 带宽 3 TB/s 的卡上,光是搬权重就要约 47 ms,而 batch=1 时计算量只有 2×70B×1 ≈ 140 GFLOP,在算力 1000 TFLOPS 的卡上只需 0.14 ms。访存时间占 99% 以上,算力几乎全程空转。
关键观察是:权重已经搬进片上存储了,一次前向算 1 个 token 和算 8 个 token 的代价几乎一样——多出来的 7 个 token 只是让矩阵乘的 batch 维从 1 变成 8,计算时间从 0.14 ms 涨到约 1 ms,但总时间仍被 47 ms 的访存主导。这就是投机解码的立足点:用大模型一次前向的闲置算力,并行验证多个候选 token。
候选从哪来?从一个小得多的草稿模型(draft model)来。小模型跑得快(比如 1B 模型一次前向只要 2 ms),让它先自回归地猜 k 个 token,再交给大模型一次性验证。猜中的部分免费到手,猜错了从错的地方重新来。
二、draft/verify 两段式:一次前向验证一整串草稿
完整的一轮投机解码分四步走:
- 起草(draft):草稿模型基于当前上下文自回归生成 k 个候选 token,比如 k=5,得到
t1 t2 t3 t4 t5,同时记录每个位置上草稿分布q(x)。 - 验证(verify):把
context + t1..t5拼成一段,大模型只做一次前向。因为注意力是因果掩码的,位置 i 的输出只依赖它前面的 token,所以这次前向能同时给出 5 个位置的目标分布p(x)——等价于并行回答了「如果前缀是 t1,大模型下一个想说什么」「如果前缀是 t1t2,大模型想说什么」…… - 逐个判定接受:从 t1 开始,用拒绝采样判定每个草稿 token 是否可接受:以概率
min(1, p(t)/q(t))接受。一旦某个位置被拒绝,后面所有草稿作废。 - 补一个修正 token:如果前 j 个都接受、第 j+1 个被拒,就在第 j+1 个位置按修正分布
norm(max(0, p - q))采一个新 token。全部接受时,额外再白拿大模型在第 6 个位置的采样。
第三步的拒绝采样是「无损」的数学保证:可以证明这套接受/修正规则下,最终每个 token 的分布严格等于大模型自己的分布 p(x),投机解码只改变生成速度,不改变生成内容(在同一种子下甚至逐 token 相同)。
下面这张时序图把一轮 draft/verify 在 GPU 上的占用画出来,注意 verify 阶段大模型只做一次前向:
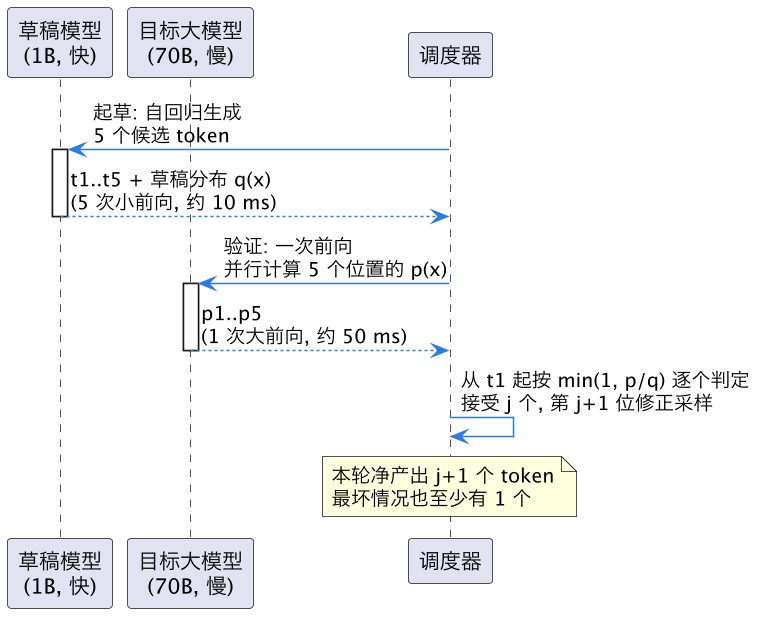
图里最值得盯住的是时间账:一轮总耗时约 60 ms,期望产出 j+1 个 token。对比朴素 decode 每 47 ms 才出 1 个 token,只要平均接受数超过 1.3 左右就开始赚。接受得越多赚得越多——这正是下一节要算的账。
三、接受率与加速比上限:一笔简单的期望账
设每个草稿 token 的独立接受概率为 α(接受率),一次起草 k 个,则一轮期望接受的 token 数近似为几何级数:
E[接受数] = (1 - α^(k+1)) / (1 - α) - 修正项 ≈ (1 - α^(k+1)) / (1 - α)α=0.8、k=5 时,期望接受约 3.4 个,加上修正 token,一轮净产出约 4.4 个 token。而一轮的代价是「1 次大前向 + k 次小前向」。设草稿模型单次前向成本是大模型的 c 倍(c ≈ 小模型参数量/大模型参数量,比如 1B/70B ≈ 0.015,再算上小模型 KV cache 和调度开销实际约 0.05),则加速比:
Speedup ≈ E[每轮产出] / (1 + k·c)代入 α=0.8、k=5、c=0.05:约 4.4 / 1.25 ≈ 3.5 倍。把 α 和 k 扫一遍可以得到这样一张决策表:
| 接受率 α | k=3 | k=5 | k=8 | 说明 |
|---|---|---|---|---|
| 0.5 | 1.7x | 1.7x | 1.6x | 低接受率下 k 越大越浪费 |
| 0.7 | 2.4x | 2.6x | 2.7x | 常见对话场景的典型区间 |
| 0.8 | 2.8x | 3.5x | 4.0x | 代码补全、模板化输出 |
| 0.9 | 3.2x | 4.4x | 5.9x | 检索复读、长引用场景 |
表里的规律有两条。其一,接受率是命脉:α 从 0.7 提到 0.9,k=8 的加速比从 2.7 跳到 5.9,所以工程上的大量努力都花在让草稿「猜得更准」上。其二,k 不是越大越好:接受率低时,后面几个草稿大概率被丢弃,白白多花小模型前向和大模型验证序列变长的开销,α=0.5 时 k=8 反而比 k=3 慢。实践中 k 常取 3~7,或者按上下文动态调整。
接受率由什么决定?本质上是草稿分布和目标分布的接近程度。投机解码的理论分析给出 α = 1 - E[D_TV(p, q)],即两分布的总变差距离越小接受率越高。落到工程上就是三个变量:草稿模型的能力(同系列小模型通常最对齐,因为词表、训练数据一致)、生成内容的可预测性(代码、格式化文本、复述检索内容 α 高;开放创作、数学推理 α 低)、以及采样温度(低温下 p 和 q 都尖锐,小模型的 top-1 更容易命中大模型的 top-1,接受率显著上升;temperature=0 时近似退化为「逐 token 比对一致就接受」)。
四、工程取舍:草稿模型怎么来,开销藏在哪里
草稿来源大体三条路线,各有代价:

三条路线的共同目标是推高上一节的 α 同时压低 c。独立小模型路线最直白:Llama-3-70B 配 Llama-3-8B 甚至 1B,词表一致、行为相似,α 天然高;代价是显存里要多住一个模型和它自己的 KV cache,小模型的 k 次串行前向也直接加在每轮延迟里。Medusa 的思路是干脆不要第二个模型:在大模型最后一层上接 k 个轻量预测头,第 i 个头预测「未来第 i 个 token」,一次大前向同时出草稿和验证——c 几乎为零,但头和大模型分布的对齐度稍逊,且需要用蒸馏数据训头。EAGLE 更进一步,用一个极小的自回归模块在大模型的特征层(而不是 token 层)起草,借助大模型自己的隐状态信息,α 做到三条路线里最高,代价是要训练这个模块并处理特征对齐的工程细节。
还有几个不显眼的开销值得记账:验证阶段序列变长 k,注意力的 KV cache 读写和 softmax 都随之变大,k 过大时这部分能吃掉几个百分点收益;被拒绝的草稿 token 占过的 KV cache 槽位要回收(vLLM 的 PagedAttention 按 block 回收即可,见推理引擎 运行时调度的显存分页一节);batch 较大时 decode 本身已接近算力饱和,验证 k 个位置的额外算力不再免费,投机解码在超大 batch 下收益收窄甚至为负——它本质是低 batch、低延迟场景的武器,服务端高吞吐场景要靠 continuous batching 而不是投机。
这一篇在知识体系里的位置
本篇属于 chip-design/intermediate 的 LLM 推理优化线:前接推理引擎 运行时调度(prefill/decode 两阶段与显存管理是投机的运行底座)与 INT8/INT4 量化与校准(草稿模型几乎必配量化压成本);底层机制见 Transformer 注意力 kernel(因果掩码为什么让一次前向能并行验证);显存带宽瓶颈的硬件背景见 GPU 显存:HBM 与 GDDR。
总结
投机解码用「小模型猜一串、大模型一次前向并行验」把 decode 阶段闲置的算力换成吞吐,拒绝采样保证输出分布无损,加速比上限由接受率 α 和草稿成本 c 决定——α 越高、k 越匹配,越接近 3~5 倍的实测收益,但它是低 batch 低延迟场景的工具,batch 打满后让位给 continuous batching。