FPGA 专家 30:算法-硬件协同设计——算法为电路让步,电路为算法定制
本文是
fpga/专家层第 33 篇。通用性能模型见 专家 31,HLS 手段见 专家 19,AI 量化特例见 专家 34。
一、总体流程:双模型并行迭代
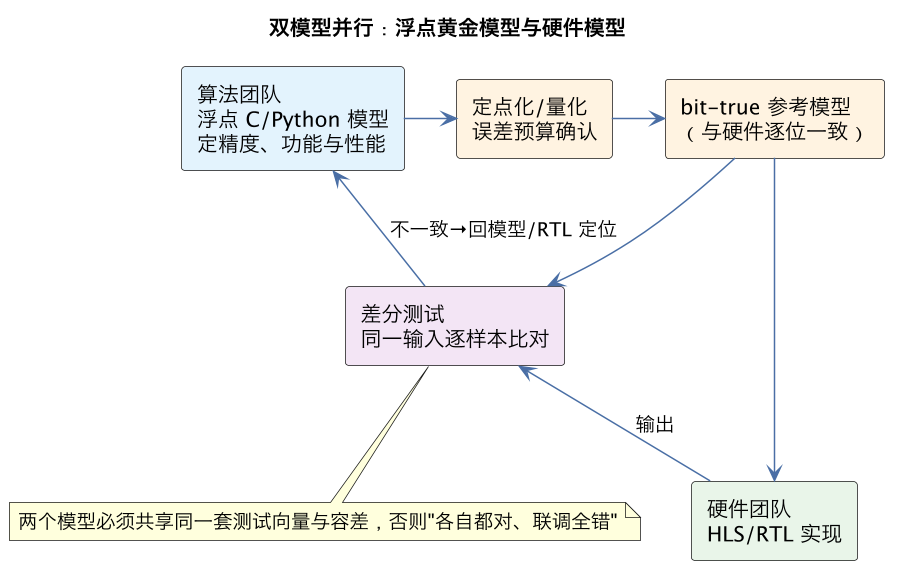
浮点 golden 模型(C/Python) ──profile范围/热算子──► 算法改写(查表面/Winograd/剪枝)
        │ 测试向量+阈值                                    │
        ▼                                                    ▼
位宽/误差预算(Q格式/块浮点) ──扫描──► 定点 golden ──bit-true对拍──► HLS/RTL
                                                                    │
                                                    上板回放 ◄── 同一批向量
二、定点化三问
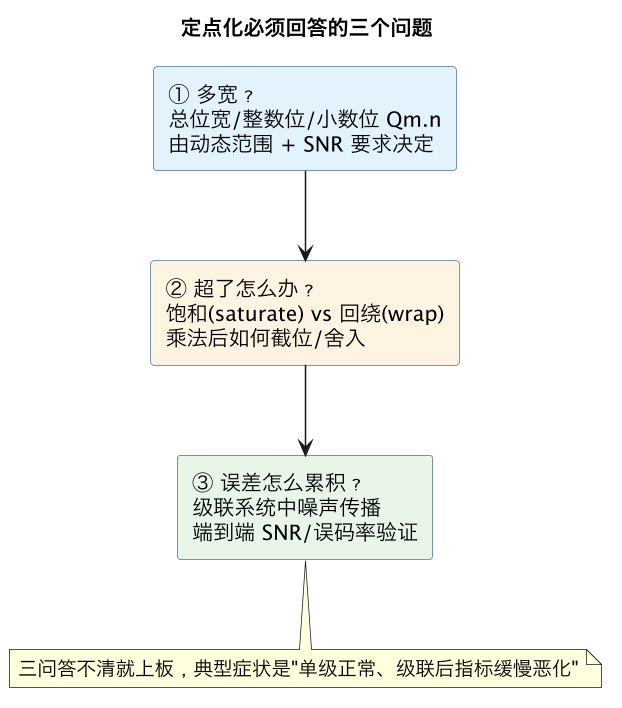
| 问题 | 方法 |
|---|---|
| 会不会溢出? | 真实数据 profile 范围,整数位 + guard bit,饱和优于回绕 |
| 精度够不够? | 系统指标反推每层噪声预算,q²/12 估算舍入噪声,逐层对拍 |
| 位宽多少? | 用 ap_fixed 等快速扫描,取"达标最窄"拐点;大动态范围用块浮点 |
三、并行度 × 存储层级联合调
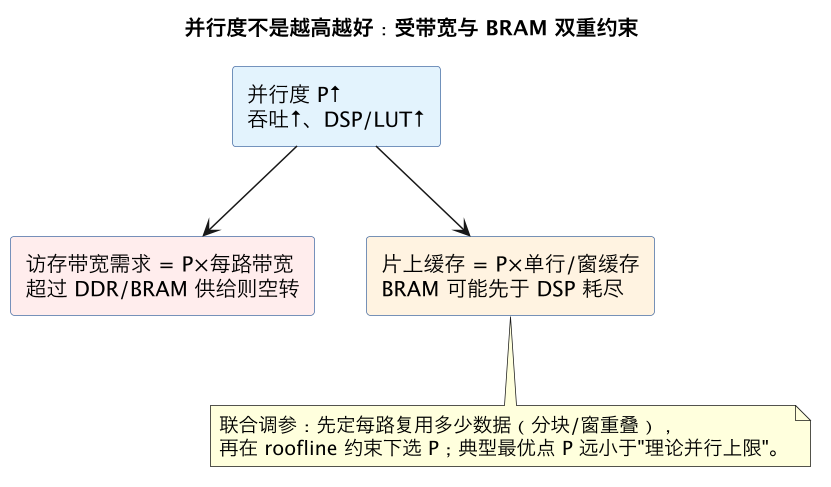
- 先 roofline 定位:供数受限就先分块/复用,别急着加算子;
- loop reorder + tiling:内层工作集压进 BRAM;
- bank/多端口设计消除访存冲突,乒乓让搬运与计算重叠;
- dataflow 级联生产者-消费者,省掉大中间缓存;
- 最后扫并行度,找算力/带宽/频率/资源的平衡点。
四、算法侧的"硬件友好换法"
移位代除法、查表面代超越函数、Winograd/FFT 化卷积、低秩与剪枝、固定迭代次数、规则化访存——每步在 golden 中量化损失后才固化。
五、bit-true 验证链
测试向量(含边界)→ 定点参考中间结果 → 模块级对拍 → 综合后后仿真 → 上板回放;模型/位宽表/RTL/比特流/向量五者版本绑定。
六、定点化的系统工程:误差预算、饱和与量化噪声传播
定点化不是“把 double 改成 int16 试试”,而是一条贯穿算法、微架构、验证的系统工程。真正决定成败的,是先建立误差预算(error budget):终端指标(检测概率、误码率、分类准确率、控制稳态误差)允许算法实现相对浮点参考偏离多少?把这个总预算像时序预算一样自上而下分配到链路各模块——前端预处理损失多少、每个滤波器级损失多少、检波/判决损失多少,留出工程裕量后,才知道每一级能用多窄的位宽、在哪里必须保宽。没有预算、逐模块拍脑袋定 Q 格式,常见结局是单模块误差都“看着不大”,级联累积后终端指标垮掉,只能回头全加宽,面积和时序白省。
量化噪声的级联传播要用信号处理的眼光分析。一次截位/舍入引入的量化误差可建模为加性白噪声,其功率与该级信号电平、保留位数有关;在增益级、积分器、IIR 反馈环里,噪声会被放大或累积(反馈环中的量化误差等效于在环内注入噪声,可能被极点放大),因此反馈通路、累加器通常要比前向数据通路保留更多保护位(guard bits)。设计直觉是:在增益和累加处保宽,在确定无信息损失的下采样/衰减后再截位,让每一次宽度收窄都发生在信噪比冗余最大的位置。对数字通信/雷达这类相干处理链路,相位/字长不够还会引起副瓣抬升、星座点旋转等结构性误差,比单纯加性噪声更致命,需要单独用动态范围和 EVM/SNR 指标验证。
溢出与饱和(saturation)策略决定了强信号下的行为是“可用的限幅”还是“灾难”。二进制定点加法溢出会回绕(wrap-around),正数突变负、幅度巨大,在反馈环里可能直接锁死或发散;因此累加器要有保护位、关键加法要做饱和逻辑(检测溢出并钳到最大正值/负值)。饱和本身也是非线性失真,要评估其在最坏输入幅度下的概率和影响,并在输入端用 AGC/归一化把信号控制在设计动态范围内。与之配套的是直流偏移与舍入模式:截位(truncation)引入直流偏置,大量级联会累积成明显基线漂移;舍入到最近值(round-to-nearest,硬件上即加一个偏移再截)可把偏置清零,代价是少量逻辑。这些选择在浮点原型里完全看不见,却是定点实现稳定可靠的基本功。
动态范围与字长的联合优化有一套可操作的流程:先用浮点/高精度仿真收集每个节点信号的统计分布(最大值、分位数、均方根、是否有偶发尖峰),据此确定整数位宽(覆盖到足够大的分位数,罕见尖峰交给饱和);再按误差预算和信噪比确定小数位宽;累加器按“最大可能累加值 + guard bits”反推宽度;最后用真实数据集做位宽扫描(word-length sweep)——从宽到窄逐位收窄并跑终端指标,找到“再降一位指标就掉出预算”的拐点。这个拐点往往比工程师凭经验给的位宽窄不少,是面积/功耗的直接节省。定点化因此是数据驱动的优化,而不是保守地全用宽字。
还要警惕几类与数值无关的定点语义 bug:有符号/无符号混用、Q 格式在乘法后小数点位置算错、不同模块对同一信号的 Q 点理解不一致、右移做除法时对负数的算术/逻辑移位混淆、跨时钟或截位时符号位扩展错误。这些在仿真对比中表现为“数值莫名其妙差一个固定倍数/符号”,应靠统一的定点类型约定(每个信号在文档和头文件里明确 Qm.n、有符号性)和集中封装的定点运算库来防。把 Q 格式当作模块接口契约的一部分评审,能消除大量后期 debug。综合起来,定点化的专业形态是:误差预算驱动、统计定标、保护位与饱和保底、数据驱动扫宽、统一 Q 契约,而不是凭勇气把浮点替换成整数。
七、并行化的算法约束:依赖、递归与 Amdahl 的边界
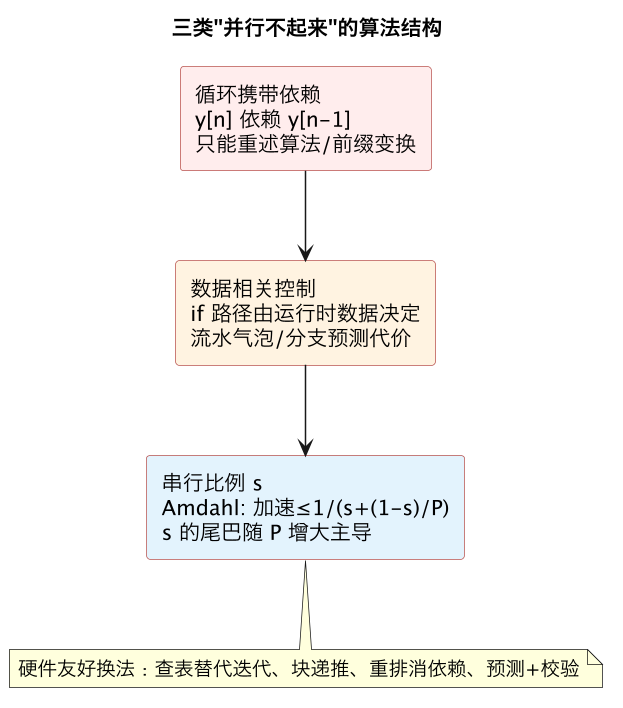
把算法搬上 FPGA,直觉反应是“并行就快了”,但哪些部分能并行、能并行到什么程度,严格由数据依赖图决定,并行化的第一步永远是算法结构分析而不是写 RTL。循环间依赖(loop-carried dependency)是最硬的约束:如果第 n+1 次迭代的输入依赖第 n 次的输出,这个循环无法直接展开并行,必须一次一次顺序算,II(启动间隔)至少为依赖延迟。IIR 滤波、递推求和、带反馈的状态更新都属此类;而 FIR、卷积、矩阵乘、独立样本处理没有循环间依赖,理论上可以充分展开。架构师的价值,很大程度体现在识别并重构依赖上。
Amdahl 定律给出加速上限:整体加速比受限于不可并行部分。即使把占 90% 的数据并行内核做成无限快,剩下 10% 的串行控制/标量部分仍把总加速限制在 10 倍。因此并行化投入要按 profile 分配到占比大的部分,且不能忽视串行尾巴、初始化、数据搬运、控制开销——这些在主内核被加速几百倍后会成为新瓶颈。与之配套的是问题规模与效率:并行 N 路只有在有足够独立工作量喂满时才有效,规模太小则启动/排空和控制开销主导,FPGA 反而不如 CPU/GPU;这要求算法批量足够大,或把多个独立小请求聚合成大批次。
面对真正的递归依赖,并非束手无策,有一整套算法变换手段,很多变换牺牲一点数值特性换并行度,是算法-硬件协同设计的精华。其一是重关联/重排:浮点加法不满足结合律,顺序累加无法直接分块并行;定点/可重结合的运算可以把长累加重组成树(树形归约把延迟从 O(n) 降到 O(log n)),或分块求和再合并,浮点则要接受或补偿重结合误差。其二是重新表述递推:把 IIR 的部分分式展开成并行二阶节、用块递归/并行前缀(scan/prefix-sum)把顺序递推转化为可流水的前缀网络、用查表近似反馈项(如用函数分段线性化消除数据依赖)。其三是改变算法:用 FFT 做卷积替代逐点卷积(复杂度从 O(n²) 到 O(n log n),结构规则适合流水)、用迭代求解换直接矩阵求逆、用 CORDIC 替代查表或乘除(只靠移位加减,硬件极省且天然流水)。这些变换往往比 RTL 技巧带来数量级的结构收益,也正是正文“算法侧硬件友好换法”的深化。
流水化(pipelining)与并行(parallelism)是两个正交武器,要分别使用。流水化让同一处理单元每个周期启动一个新任务(II=1),提高吞吐但不减少单个任务延迟,适合无循环间依赖或依赖可在一级内闭合的计算;并行复制是实例化多个单元同时处理不同数据,提吞吐也加面积。实践中常用“先把单路流水做到 II=1,再按 roofline 需要的吞吐复制若干份并配给相应带宽/存储”。HLS 工具通过 pipeline/unroll/dataflow 把这些变换半自动化,但工具无法替你消除根本依赖:当 HLS 报告 II 大于 1(因为反馈、访存冲突、端口限制),必须回到算法层改结构或改存储分 bank,而不是反复调 pragma 碰运气。能读懂 HLS 综合报告里的 II、延迟、瓶颈(memory dependency、port width)和读懂时序报告同等重要。
最后,并行度要与存储和带宽联合定标(与 专家 31 的 roofline 闭环)。N 路并行需要每周期供给 N 份操作数,存储必须分成足够多 bank、数据在片上的排布要消除冲突(必要时在编译期做数据布局/重排,如把矩阵按分块交错存放),否则 PE 会因取数冲突空转,纸面并行度落不到吞吐。一个完整的并行化方法论是:画依赖图找硬约束→用算法变换削/绕依赖→Amdahl 定投入优先级→单路流水 II=1→按 roofline 复制并匹配存储带宽→用真实数据测有效利用率。跳过依赖分析直接堆并行单元,是 FPGA 加速最常见、也最浪费的错误。
八、双模型验证链的工业化:黄金模型、差分测试与回归
算法硬件化最大的风险,是“硬件跑得很快但算得不对”,而数值类错误(位宽、舍入、顺序、时序)极难靠看波形逐个发现。因此必须从第一天就建设一条双模型(floating golden + fixed-point/RTL)自动对齐的验证链,让任何偏差立刻暴露、自动定位,而不是等系统联调时怀疑“是算法问题还是 RTL 问题”。
黄金模型(golden/reference model)是单一事实来源,通常用 C++/Python/MATLAB 以浮点或高精度实现算法,它既定义功能,又产生测试向量和期望输出。关键纪律是同一份测试向量同时驱动多个抽象层级:浮点参考、可综合的定点 C/C++(HLS 或 bit-true 模型)、RTL 仿真、乃至上板后的硬件。向量库要分层:小而手构的 corner case(全零、全一、最大值、符号翻转、单脉冲、边界频率)、覆盖分布的随机向量(带固定 seed,可复现)、以及真实采集的数据集(决定终端指标)。每一层都和上一层或黄金模型做比对,形成逐级收敛的信任链。
bit-true(位真)比对是定点阶段的核心。定点 C 模型必须精确模拟硬件的每一位行为:相同字长、相同舍入/饱和、相同溢出回绕、相同运算顺序(哪怕只是中间结果截位先后不同,都可能导致 LSB 级差异)。当定点 C 模型与 RTL 对同一向量逐样本、逐端口输出完全相同(或在明确容差内),就证明 RTL 正确实现了已被算法团队认可的定点算法——验证问题被分解成两个更简单的问题(定点 vs 浮点看精度损失,RTL vs 定点看实现正确性),而不是让 RTL 直接对浮点、面对数值和实现两类错误的叠加。HLS 流程天然共享 C 模型,手写 RTL 时则需要专门维护一份 bit-true 参考,这份投入在整个生命周期里会被反复摊薄。
容差与指标要分层定义,不能简单要求“逐位相等”。实现正确性层(RTL vs 定点模型)应严格 bit-true;精度层(定点 vs 浮点)用统计容差:逐样本误差(绝对/相对)、信噪比/PSNR、残差分布、以及最重要的终端任务指标(BER/BLER、检测概率/虚警、分类准确率、控制超调)。终端指标是最终裁判——某些 LSB 级差异对任务毫无影响,某些看似微小的偏差却打垮判决,只有端到端指标能区分。比对脚本应自动产出这些指标与阈值判定,失败时给出第一个失配点、误差谱和对应输入,把人工定位时间从小时级压到分钟级。
差分测试与覆盖率导向补洞让验证自动化闭环。用脚本大规模随机生成输入(覆盖动态范围、频率、相关/不相关、异常帧),同时喂给模型和 RTL 自动 diff;结合功能覆盖率(哪些 Q 格式区间、饱和路径、分支、状态被触发过)发现没测到的角落,定向补向量。协同时代还应加入实现非理想性的对比:RTL 反标时序或在高压/降频下运行、引入量化 + 饱和 + 偶发反压,确认终端指标在最坏情况下仍在预算内。形式方法可用于定点运算单元的边界证明(如“任意合法输入下加法器不产生错误回绕”)。这套方法与 专家 39 的自动化回归是同一思想在算法域的落地:黄金模型 + bit-true + 差分 + 覆盖率 + 端到端指标,全部进 CI。
工程组织上有几个决定成败的约定:算法和硬件团队共享同一套向量和容差定义,接口数据的 Q 格式/打包方式由双方签字的接口文档固定;黄金模型和 RTL 在同一版本库里联动管理,算法一改,向量和期望自动更新并触发 RTL 回归;上板后保留一条“硬件在环比对”能力——把真实输入旁路一份给板上黄金模型(或离线回放),持续监测硬件输出与参考的偏差,作为现场健康检查和 errata 发现手段。这样,验证链不是交付前的一次性活动,而是贯穿设计、联调、量产、运维的持续资产。
九、典型坑与协同设计评审清单
把算法-硬件协同设计中的高频失败模式和评审检查点汇总,供项目关口使用。
直接搬浮点/照搬串行算法:把 CPU 上的递归式、指针追逐、动态内存、double 精度代码原样 HLS/手写,结果 II 差、资源爆、指标差。正解是先做依赖分析和算法变换(重结合、分块、FFT/CORDIC 替换),为硬件重写算法形态。
无误差预算的定点化:各模块自定位宽,级联累积误差拖垮终端指标,或过度保守全宽浪费资源。正解是自上而下分配误差预算、统计定标、保护位/饱和、数据驱动扫宽、用终端指标验收。
忽略反馈环量化噪声:IIR/环路内截位使噪声被极点放大甚至极限环振荡。正解是环路内保 guard bits、用舍入消偏、做稳定性和极限环分析。
只验证合法/平均输入:不测饱和、溢出、畸形、极端动态范围,现场强信号下回绕锁死。正解是 corner + 随机 + 真实数据三层向量,覆盖饱和/溢出路径并验证优雅降级。
双模型脱节:算法模型、定点模型、RTL 各自演化,向量不共享,联调时无法判断错在哪层。正解是单一黄金模型、向量同源、bit-true 逐级比对、版本联动、进 CI 自动回归。
并行不匹配存储带宽:堆了大量 PE 但 bank 冲突/端口不足导致空转。正解是依赖图→变换→单路流水 II=1→按 roofline 复制并联合分 bank/布局。
把加速比当平均/峰值纸面值:没算数据搬运、初始化、串行尾巴、反压。正解是端到端实测(含 host/PCIe/DDR),报告有效吞吐与最坏延迟,用 Amdahl 核对串行占比。
接口 Q 格式混乱:有符号/Q 点/移位语义在模块间不一致,产生固定倍数或符号错误。正解是 Qm.n 与有符号性写入接口契约、集中封装定点运算、评审逐项核对。
协同设计评审清单:①算法依赖图已画,硬递归已识别并有变换方案;②Amdahl 分析过,加速目标与串行占比自洽;③误差预算分配到模块,定点字长有数据依据;④反馈/累加有 guard bits,饱和与舍入策略明确且经极端输入验证;⑤黄金模型 + 同源向量驱动浮点/定点/RTL,bit-true 通过、终端指标达标;⑥覆盖率导向的差分测试进 CI,含 corner/随机/真实数据;⑦并行度与 bank/带宽/频率联合定标,实测利用率达标;⑧端到端(含搬运)性能与最坏延迟有实测;⑨Q 格式接口契约完整;⑩有上板硬件在环比对/健康监测的预留。把这十项作为设计冻结前的硬门槛,能把“算法对、芯片快、但系统不对”这一最昂贵的失败挡在流片或发布之前。
十、存储结构的算法级改造:从数组到硬件友好的数据布局
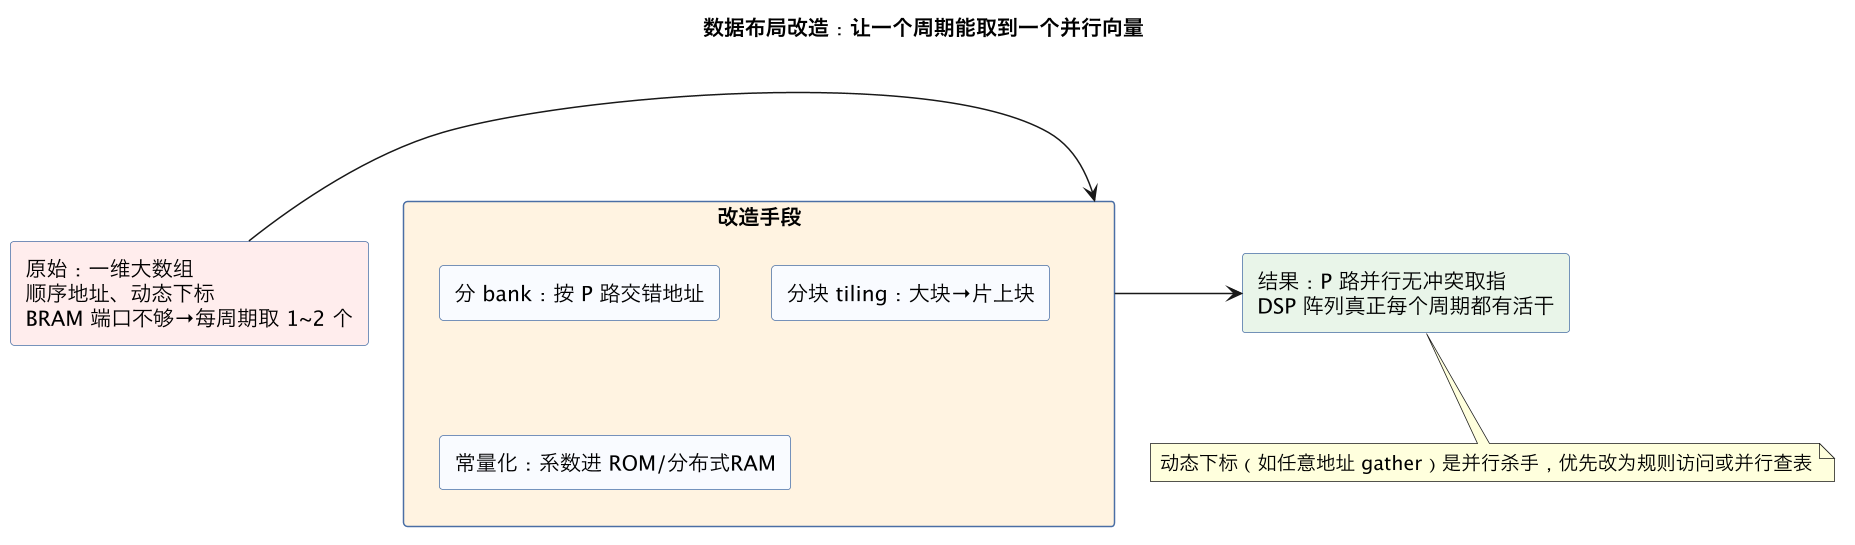
算法与硬件的接缝,很多不在算子本身,而在数据结构和访存模式上。软件为可读性设计的数据结构——指针链表、哈希表、动态数组、按对象聚簇的结构体——直接综合往往给出极差的硬件:随机访存、依赖链长、位宽不均、边界动态。协同设计要求算法工程师在不改功能的前提下,把数据重排成“顺序、对齐、分块、静态可定界”的形态,这是比换算子更常见、收益更大的改造。
顺序化是第一原则。链表和树的指针追逐每次访存都依赖上一次结果,延迟无法隐藏;改造手段包括把频繁遍历的结构数组化(顺序存储 + 索引)、用查表替代搜索、遍历重排成可预取的顺序流、把稀疏结构紧凑化成连续块加侧表。对动态增长的集合,硬件友好的做法是预分配固定容量的块并以容量参数化,“满”是正常的可处理状态而非异常。对齐与打包是第二原则:字段按硬件位宽对齐(哪怕浪费比特)、相关字段打包进同一个字、避免跨行/跨突发边界的字段,能显著简化读写逻辑;软件结构里为了省几个字节的位域压缩,到了硬件上常需要额外的移位和掩码,得不偿失。
分块与交错(interleave/tiling)是第三原则,目标是消除 bank 冲突。并行 PE 每周期要访问 N 个操作数,数据就应按 N 路交错存储(地址按 N 取模分布到 N 个 bank),让并行访问落在不同 bank;矩阵按分块存而不是按行存,使一个小窗口内的数据能并行取出。这种布局通常在软件参考模型里就提供一个“硬件布局”版本(带打包/解包函数),并在双模型链路上验证布局变换本身的正确性——很多 bug 不在算法而在重排的索引计算。第四原则是让控制流数据化:软件里的函数指针、虚分派、变长分支,硬件上尽量改成 opcode 驱动的固定处理单元加小分派表;把“决定做什么”的信息在预处理阶段算好,随数据一起流下去,而不是在数据通路里临时判断。
这些改造有共同的方法论:保留一份清晰的软件参考实现(解释意图),维护一份硬件友好的等价实现(解释布局),用随机差分测试证明两者功能等价、用性能模型证明收益。判断改造是否到位的标准很朴素:理想情况下数据通路里没有“等待内存”的气泡,也没有“处理不了就回退软件”的特殊长度——边界全部被规整成统一处理。做到这一步,综合出来的电路结构和软件原型已经不像同一个程序,但它们共享同一份规格和同一套测试。
十一、HLS 工程化:把 C 模型变成高质量硬件的纪律
高层综合是算法-硬件协同最常用的桥梁,但它有一个广为流传的误解:会写 C 就能出好硬件。实际上 HLS 产出的质量几乎完全取决于设计者是否按硬件思维组织代码,把“算法对的 C”改写成“有明确吞吐、带宽、存储结构意图的 C++”。工程化使用 HLS 需要建立几条纪律。
第一,接口先行。每个顶层函数的综合接口要显式设计:数据用流式接口还是内存映射(AXI-Stream vs AXI-Lite/AXI master)、数组是综合成 BRAM/URAM 还是外存端口、突发能力如何。默认综合往往给出寄存器级的低效接口;接口方式定错,内部优化全无意义。接口协议要和系统集成方约定(valid/ready、last、位宽、突发长度),并在测试台上用真实反压验证,而不是只喂理想数据。
第二,用综合报告而不是仿真波形做主要决策依据。重点读:启动间隔(II)及未达到目标的原因(依赖、存储端口、访存延迟)、延迟、资源(尤其 BRAM 和 DSP)、循环是否被流水展开、数组映射到了什么存储。II 大于 1 时先看瓶颈类型:循环携带依赖要改算法或拆循环;存储端口不够要分 bank 或复制数组;访存延迟未隐藏要加预取或分块。反复调 pragma 而不动结构,是 HLS 新手最常见的原地打转。第三,存储显式化:数组分区(array partition)的维度和方式、双缓冲、行缓冲窗口都应明确写出,让数据复用发生在片上;依赖编译器“自动优化存储层次”基本不可指望。
第四,控制与数据分离、函数层级对应模块层级:把顶层写成清晰的数据流网络(dataflow),每个函数对应一个有明确 FIFO 连接的处理阶段,而不是一个巨型函数里塞满条件分支。dataflow 的吞吐取决于最慢的阶段和 FIFO 是否会因速率波动而停顿,因此阶段间 FIFO 深度要按突发估算。第五,复用验证资产:C 测试台与 RTL 仿真用同一批向量,C 侧的定点模型就是 bit-true 参考(见正文验证链);综合后的 RTL 必须重新跑全量随机回归,因为综合本身可能引入边界 bug(数组越界、有符号性、位宽截断),“C 仿真过了”不代表综合网表对。
HLS 的合理定位是迭代速度工具:在架构探索、算子多变、软件团队主导算法的阶段,它把“改个并行度试试”的成本从天压到小时;而当某条路径成为确定的瓶颈且对面积/频率有极致要求时,该路径的 HLS 结果可以作为规格,再用手写 RTL 重写并逐事务对拍。HLS 与手写 RTL 不是信仰之争,而是按成熟度和收益分阶段选择的两种实现手段。
十二、跨团队协作与接口契约:协同设计真正的瓶颈
算法-硬件协同项目失败,技术原因之外最常见的是协作失败:算法团队在浮点环境里迭代到冻结才“扔给”硬件,硬件团队按误解的指标做出电路,集成时才发现定点掉指标、数据格式不兼容、真实数据分布和假设完全不同。把协同做成工程,需要用契约、节奏和共同指标把两边焊在一起。
接口契约要在项目早期冻结并进入版本库:每个跨团队的数据块定义——字段、定点格式(Qm.n/有符号性)、打包顺序、对齐、合法范围、无效值表示、块大小和边界规则;每个功能块的行为契约——输入输出关系、延迟与吞吐目标、反压语义、错误/溢出行为、状态复位要求。契约用机器可校验的形式维护(头文件/IDL/自动生成文档),算法侧的打包函数和硬件侧的解包逻辑从同一来源生成,从根上消灭“两边各自理解”。契约变更走评审,因为它同时影响参考模型、RTL、测试台和驱动。
共同节奏的有效形式是双周可运行集成:哪怕功能不全,算法的最新模型能产出向量、硬件的当前 RTL 能吃这些向量、scoreboard 自动出差异报告。集成频率越高,误解存活时间越短;三个月一次的“大集成”几乎必然爆出量级庞大的不一致。指标也要共同拥有:定点后的终端任务指标(而不是信噪比)、端到端延迟和吞吐(含搬运,而不是核内)、资源预算,写成同一张双方签字的验收表,避免“硬件说我按时钟跑到了、算法说结果不能用”的各说各话。
真实数据是仲裁者。定点位宽、饱和策略、异常输入比例,都应由真实采集数据的统计决定,而不是算法用合成数据、硬件用另一份测试图案。建立一套共享的代表性数据集(覆盖典型、边界、罕见、故障态)并版本化,所有层级在同一数据上报告指标。现场数据要能回流为新的回归向量(验证连续性思想见 05 原型到硅后衔接 pre/post-silicon 协同/errata)。
最后是人员与语言:高效团队通常有能同时读懂浮点模型和时序报告的“桥梁工程师”,或者让算法和硬件工程师结对共写定点模型和测试;评审会议上既看算法曲线也看综合报告,让两边理解彼此的约束——算法知道一级乘法的面积和一个反馈环的代价,硬件知道这个指标为什么不能再降一个比特。协同设计的深度,最终是由这种相互理解的密度决定的,工具只放大它、不能替代它。
总结
协同设计是"定精度、改算法、定并行、理存储"四件事联动:用 golden 模型和误差预算管住定点化,用 roofline 决定先复用还是先并行,用算法换法降低问题本身的硬件代价,并用 bit-true 对拍链保证快速迭代不翻车。