FPGA 专家 10:Zynq 数据交互深水区——HP、一致性、地址
本文是
fpga/专家层第 13 篇。基本用法见进阶 Zynq 数据交互(HP 口/AXI DMA/VDMA),软硬分工见 Zynq PS/PL 协同,DDR 带宽见 DDR 深水区。
一、PS↔PL 端口体系
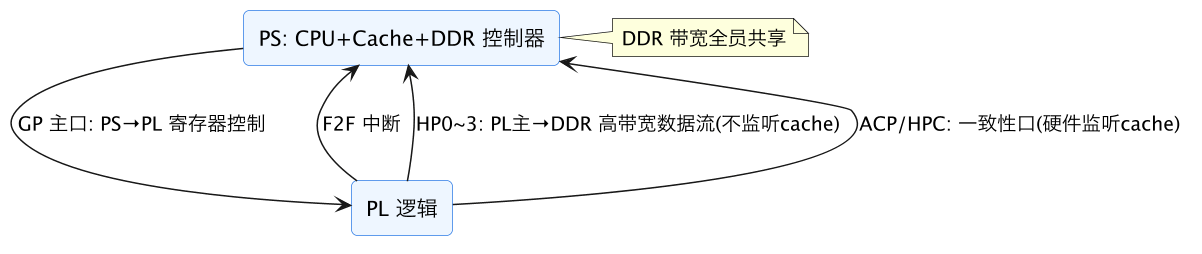
| 口 | 用途 | 一致性 |
|---|---|---|
| HP0~3 | PL 大块读写 DDR | 否(软件管理) |
| ACP / HPC | 紧耦合同享小数据 | 硬件 cache 一致 |
| GP(主) | PS 配置 PL 寄存器 | — |
| VDMA | 视频帧多缓冲 | 按内存属性 |
二、缓存一致性对照
| 场景 | 问题 | 解决 |
|---|---|---|
| CPU 写 → PL 读 | 数据卡在 cache | flush/clean 回写,或非缓存内存 |
| PL 写 → CPU 读 | CPU cache 旧副本 | invalidate 失效,或非缓存 |
| 都要自动一致 | 手动同步麻烦 | ACP/HPC 口(省 cache 带宽则用 HP+非缓存) |
经验:控制结构/描述符用 dma_alloc_coherent(小、一致);大帧/数据流用非缓存或显式 sync(省 cache、高带宽)。
三、地址域
用户虚拟地址 (malloc/mmap, MMU 翻译)
   ↕ dma_alloc_coherent / dma_map_sg
内核虚拟地址 (驱动用)  +  dma_handle / bus 物理地址
                                 ↓ 写进 DMA 描述符
PL 经 HP 口访问的 DDR 物理地址
描述符填 bus/物理地址,不是指针;物理地址必须由 dma 接口分配,不能硬编码(裸机可 linker 预留)。
四、跑满带宽
- DDR 总带宽全员共享,按总量核算;
- HP 口靠长突发 INCR + 高 outstanding + 持续供给填满内部 FIFO;
- 64bit 配置、PL AXI 时钟匹配;
- VDMA 视频多缓冲防撕裂,通用流用 AXI DMA SG;
- 看吞吐计数器/FIFO 水位区分"喂不饱/到顶"。
五、端口体系深论:HP、HPC、ACP、GP 的真实能力
要把数据通路设计对,必须脱离“端口名字”理解每条口的真实微结构。Zynq-7000 的 HP 口是 PL 主设备到 PS 内存子系统的宽 AXI 从口(在 PS 内部),内部带命令和数据 FIFO、可配 32/64 位、支持较长突发,直连 DDR 控制器/SCU 侧路径;它不接 snoop 逻辑,从 HP 进来的读写不检查 CPU 缓存,因此“快但不自动一致”。四个 HP 口共享 DDR 控制器总带宽,且与 CPU、GPU(若有)竞争,端口手册给的峰值是“其它全部空闲、最优突发模式”下的理论值,系统设计必须按 专家 06 的保证带宽打折。ACP 是另一类入口:它把 PL 事务接入 SCU 的一致性互连,读可填 CPU 缓存、写触发 snoop/分配,因此与 CPU 共享的数据自动保持一致,代价是事务经过一致性逻辑、单位带宽更低且延迟依赖缓存状态——它为“小数据、紧耦合、控制结构”设计,不是给视频帧流用的。MPSoC 的 HPC 口在高性能基础上可启用 coherency(CCI 路径),相当于“可切换一致性的 HP”,但开启后同样要按一致性流量核算。
GP 口则完全不同:GP 主口是 PS CPU 经 OCM/SCU 域访问 PL 的窄口,路径上经过更多转换,适合寄存器和低频控制;GP 从口允许 PL 主访问 PS 的部分资源但带宽有限,不应承担数据面。EMIO 不是数据口,只是把 PS 外设的引脚复用到 PL 内部逻辑(I2C/SPI/UART 的电气与协议仍由 PS 控制器实现,PL 里相当于接线)。规划端口时要同时想方向和并发模型:典型视频系统是“PS 经 GP0 配置采集/VDMA 寄存器;采集流经 VDMA/HP1 写 DDR;显示侧 VDMA 经 HP0 读 DDR;中断经 F2F”,控制和数据在物理端口上就分开。还要记住端口内部 FIFO 深度、支持的 ID 数和突发长度都有上限,设计前查器件技术手册的“Maximum Frequencies / HP Interface Width”表,并把 PL 侧 AXI 时钟频率、位宽与端口配置匹配——时钟跑不上去时,64 位口的实测带宽可能只有理论的一半。每个端口在集成时都应挂一组性能计数器(事务数、字节数、忙周期、FIFO 满次数),没有这些计数器,端口级性能争论永远无法收敛。
六、缓存一致性工程:四种正确模式与同步点
缓存一致性是 Zynq 数据通路 bug 的头号来源,因为它在功能测试中常常“恰好正确”,却在负载、内存布局、内核版本变化后偶发失败。根本原因:CPU 的加载/存储命中私有 L1/共享 L2,PL 经 HP 的访问绕过缓存直达 DDR;两个视角对同一地址各有副本。工程上只有四种正确模式,不要在它们之外自创。模式一,非缓存共享内存:把共享区映射为 device/normal-noncacheable(Linux 用 memreserve 加设备树属性、驱动 ioremap/writecombine 或 dma_alloc 的一致变体),所有访问都到 DDR,最简单、性能对小数据够用、对大流量可预测;缺点是 CPU 访问无缓存加速。模式二,coherent 分配:dma_alloc_coherent 得到的内存保证双方一致(平台上通常通过非缓存映射或 snoop 机制实现),适合描述符、控制块、小队列。模式三,流式映射+显式同步:普通缓存内存只在数据交接的边界做操作——CPU 写完交给 PL 前 clean/flush(把脏行写回 DDR),PL 写完 CPU 读前 invalidate(丢弃 CPU 旧行);大帧缓冲的默认选择,性能最好但同步点必须精确,且要覆盖整个数据范围而不只是头部。
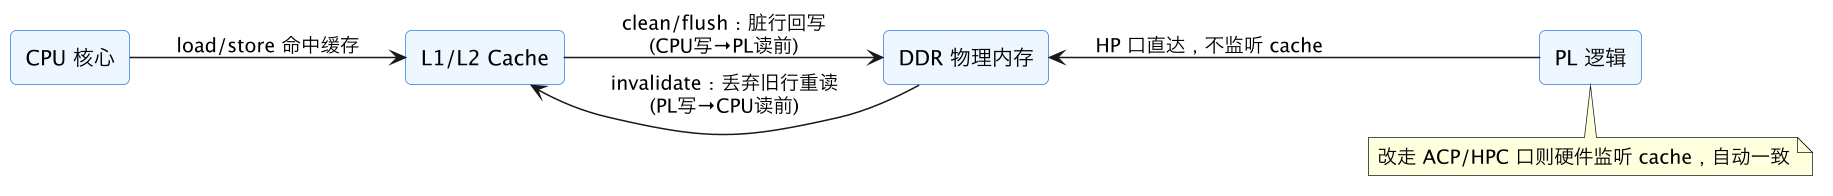
上图把两个视角画在一起:CPU 的读写经过 L1/L2,PL 经 HP 口绕过缓存直达 DDR,于是同一块数据在交接边界必须插入一次 clean 或 invalidate;图中两条竖线箭头的方向,正是两种交接场景各自需要的同步操作。
模式四,一致性端口:ACP/HPC(开 coherency)承担共享访问,硬件维持一致,软件最省心,适合低延迟控制结构,不适合无差别大流量。无论哪种模式,都要遵守单所有权原则:每块数据在任一时刻只有一个所有者,交接通过明确的同步原语(描述符状态字、门铃、中断)完成;不能双方同时无协调地读写同一区域。同步操作本身要注意顺序:clean 必须在“敲门铃/置 ready”之前完成,且中间有屏障,否则设备可能看到 DDR 里的旧数据——这与 PCIe DMA 的屏障纪律(专家 08 第六节)完全同源。调试一致性问题有一个高效的判别实验:把可疑缓冲区改成全非缓存重测,若故障消失,问题域立即锁定为缓存同步;若仍在,则查地址、字节序、跨时钟域。代码评审中应能对每个共享区回答三个问题:内存属性是什么、谁在什么时刻拥有、clean/invalidate 在哪一行代码。把这三问写进驱动 checklist,能消除绝大部分“数据偶尔不对”的 Zynq 缺陷。
七、地址域与 DMA 编程模型:从虚拟地址到 HP 口事务
Zynq 上至少存在三个地址空间,初学者把它们混为一谈就会制造最难排查的 DMA bug。CPU 虚拟地址是进程看到的指针,经 MMU 翻译;CPU 物理地址/bus 地址是总线上的真实地址(Zynq 上一般 1:1,但仍应通过 DMA API 获取而不是假设);PL 侧地址是 AXI 事务上的 AxADDR,对于经 HP 口访问 DDR 的 DMA 必须是 bus/物理地址。内核驱动用 dma_alloc_coherent 同时拿到内核虚拟地址(CPU 用)和 dma_handle(写进硬件描述符),dma_map_sg 则给出分散物理页的 bus 地址数组;把内核或用户指针直接强转写进描述符,是 Zynq DMA 的经典事故——虚拟地址经 HP 口发出后命中完全无关的物理页,表现为随机内存踩踏或 DECERR。用户态缓冲区要先 pin 住并 map(mlock + VFIO/UIO 或驱动 dma_map_sg),否则页面可能被换出或迁移。裸机场景没有 MMU 干扰,可在链接脚本预留物理段并直接使用物理地址,但要和 Linux 场景分别处理,不能让同一驱动逻辑假设两种世界。
DMA 编程模型上,简单模式(一个 buffer、固定地址长度)只适合固定流;生产代码应用 SG 环形描述符:内存中环形队列,每项含 bus 地址、长度、状态/拥有者位、(视频)行列信息,PL 与 CPU 分别维护生产/消费索引,靠门铃寄存器和帧级中断推进;它解耦了生产消费速率、支持散布的物理页、允许双方批量推进(与 PCIe SG 同构,见 专家 08 第五节)。描述符环本身放 coherent 内存,数据缓冲走流式映射。几个易错细节:环满/空判断要留一个槽位或用计数,避免索引相等的歧义;长度按端口突发宽度对齐,减少短突发;PL 读描述符也要经 HP/DMA 路径,描述符访问与数据访问争用同一 DDR 口时,小描述符的随机访问模式会显著降低 DDR row 命中率(专家 06 第六节),可把环放 OCM 或让 PL 缓存描述符;MPSoC 上物理地址超过 32 位时 DMA 地址宽度要配够。每次启动/复位都要重建环并让 PL 清空内部缓存的描述符,防止热重启后执行陈旧地址。把“地址从哪来、谁负责 pin/unmap、环如何重置”写成驱动与 RTL 的联合时序图,是这一层最重要的交付物。
八、带宽核算与性能调优:从 HP 口峰值到系统保证值
端口手册上的峰值带宽在系统里几乎不可见,正确的工程流程是逐层扣减。以 64 位 HP 口、PL AXI 时钟 150/200MHz 为例,先按公式(数据宽度×时钟×有效率)算端口上限,再扣除:DDR 子系统的整体效率(60%~85%,专家 06 第七节);多主竞争(CPU 刷新屏幕、文件系统、其它 HP 口);突发效率(短突发、4KB 拆包、读改写);PL 供给气泡(源接口断续、FIFO 欠载);一致性流量(若用 HPC coherency)。结果写成“每方向平均/峰值/保证带宽”三列,再让每条业务流的峰值不超过保证值,短时超出靠 FIFO 吸收,深度按超额速率×持续时间计算。多流系统应做组合工况测试(所有摄像头同时采集 + 显示 + CPU 负载 + 网络存储),只测单流会得到无法交付的结论。
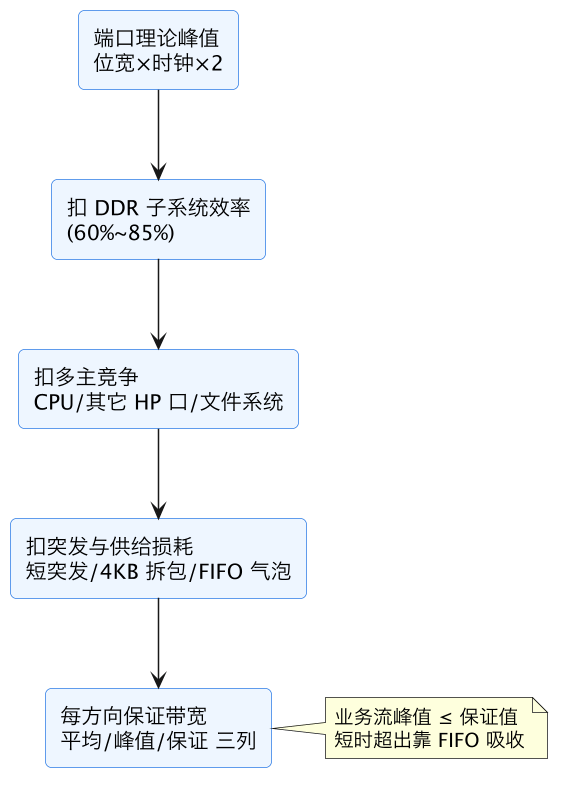
这张扣减链对应上面的核算流程:手册峰值只是起点,每一级扣减都要有实测或经验依据,最后落到最下方的保证带宽;只有让每条业务流的峰值不超过这个保证值,带宽核算才算闭环。
调优按
调优按“先供给、再组织、后仲裁”的顺序。供给:AXI 主口保持长 INCR 突发、足够 outstanding(按往返延迟×目标带宽÷突发字节估算,专家 10 第八节)、入口 FIFO 不被上游饿死或被下游堵死;用计数器量化 valid/ready 握手占比。组织:像素流按行/帧连续映射(VDMA 默认就是跨步线性化),通用 DMA 聚合大块;共享缓冲对齐到缓存行(32/64 字节)和突发边界,避免部分行同步;描述符访问与数据访问分离(OCM/缓存)。仲裁:PS 侧 DDR 仲裁给实时流设权重或带宽配额,控制事务保留独立通道(GP);同一 HP 口被多个 IP 共享时,在互联层做带老化的仲裁防止显示/采集互饿。实测工具链:HP/VDMA 内置性能计数、PL 自定义周期计数器、PS 侧 perf/带宽测量、以及 FIFO 水位轨迹。一个高频误区是看到吞吐低就“把时钟再调高”,其时序/功耗代价大且往往根因是短突发和 DDR row miss——先用计数器证明瓶颈位置。最终交付应有一张在指定温度/负载下的实测带宽表和最坏延迟数字,而不是只给理论值。
九、VDMA、SG DMA 与帧同步:视频数据通路专题
帧类数据(视频、图像、二维矩阵)与普通字节流的区别在于二维地址跨步和显示/采集的时序同步,VDMA 正是为这两点设计的。每个方向(MM2S/S2MM)维护多帧缓冲寄存器组(通常三缓冲),硬件自动在帧结束时切换到下一帧地址并可循环回绕;寄存器设置行字节跨度(stride,允许行对齐 padding)和帧高度,内部把二维帧线性化为 DDR 的连续(或等跨步)突发序列。配套的是同步机制:park/genlock 模式让主从通道锁定同一帧节奏,软件通过 frame 同步寄存器(tail/park 指针)提交新缓冲,硬件在帧边界生效,避免半帧写入被显示读出(撕裂)。工程惯例是三缓冲:PL 写 A、显示读 B、软件处理 C,轮换使用;双缓冲在处理延迟波动时容易抖动,单缓冲必然撕裂。
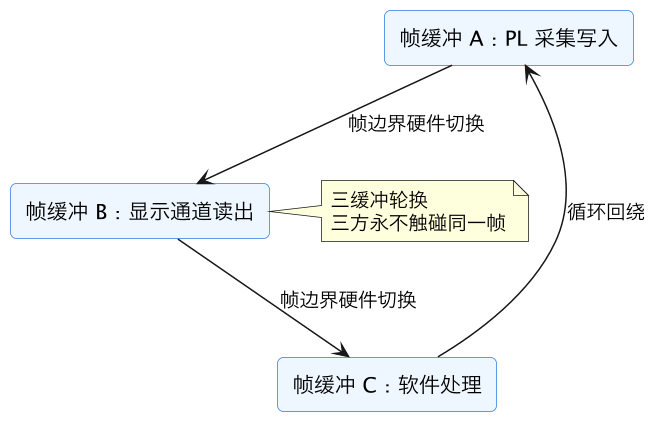
图中三个缓冲各有固定角色、沿帧边界单向轮换并循环回绕,这正是三缓冲防撕裂的机制:写入、显示、处理在任何时刻都落在不同帧上,半帧写入被显示读出的情况在结构上就不可能发生。
软件流程为:配置方向/分辨率/stride/帧地址数组→启动→每收到帧完成中断先确认状态/错误位再提交下一缓冲(tail pointer);关闭时先停源再停 VDMA 并等停机确认。
通用 AXI DMA(SG)适合一维网络包/采集流,配合环形描述符即可;CDMAC 用于内存到内存搬运用加速软件大块拷贝,不能接 stream。选型时还要考虑中断节奏:VDMA 帧中断是天然的批处理边界(60fps 即每秒 60 次,CPU 毫无压力),逐行中断或逐包中断则要在 PL 聚合。同步问题排查:画面撕裂查缓冲数和软件提交时机;整帧偏移查 stride 与实际行宽(含 padding);滚动错位查帧地址回绕和缓存同步(显示缓冲被 CPU map 后忘记 invalidate/clean);偶发花屏查 HP 带宽余量、FIFO 溢出计数和复位时序。带视觉处理的链路(采集→DDR→PL 处理→显示/编码)应让各环节共享同一帧序号,软件日志、VDMA 寄存器、PL 计数器都带帧号,跨模块问题就能按帧回放。视频时钟与 AXI/内存时钟异步,VDMA 内部和接口 FIFO 是跨时钟域边界,验证时要随机相位长稳运行(通用 CDC 纪律见 intermediate/42)。
十、系统模式与联合验证:典型架构与长稳测试
把前述内容综合成三种可复用架构。架构一,采集记录:传感器→PL 预处理→VDMA/S2MM 经 HP 写 DDR→PS 打包存盘/上传;控制走 GP,帧缓冲三块轮转非缓存或显式同步;带宽按像素率×格式核算到 DDR 保证线以内。架构二,采集直出/处理:采集流在 PL 内完成处理后经 AXI-Stream 直接送显示/网络/PCIe,不落 DDR(或只落旁路录制),延迟最低、对 DDR 零占用,是高实时场景首选;需要 CPU 看结果时只搬元数据和小图。架构三,协同计算:CPU 准备参数与工作队列(coherent/ACP),PL 加速器经 HP 大块读入、写回结果,完成中断批量通知——控制紧耦合走一致性口、数据走高带宽非一致路径,两者各得其所。设计取舍的通用原则仍是数据面绕开 CPU 和缓存一致性流量,控制面集中在小的共享结构。
联合验证要覆盖单接口测试覆盖不到的系统行为。启动与配置:冷启动/看门狗复位/PS 重启 PL 三种路径下,比特流版本、时钟、复位、DMA 环都能重建;长稳:满带宽连续 72 小时,记录 FIFO 溢出、帧丢失、HP 错误、ECC、温度,无任何计数增长;负载组合:CPU 100%、网络流量、界面操作与数据流并发,检查最坏帧周期和丢帧;内存正确性:用带校验的已知图案(行走位、PRBS、帧号水印)端到端比对,专门覆盖 cache 同步边界(首末缓存行、跨页缓冲);异常:DDR ECC、HP DECERR/SLVERR、源设备断流、PS 主动 cancel DMA,确认 PL 停机可被软件确认且无在途写;升级:FSBL/比特流/驱动/设备树组合升级与回滚。所有测试自动化并输出通过/失败与计数器快照(CI 化思路见 专家 46)。PS-PL 系统的缺陷几乎都在“边界”:缓存边界、地址边界、时钟边界、帧边界、生命周期边界;把验证预算投在这些接缝处,远比对两边内部重复测试有效。
十一、中断设计与软件协作:从 F2F 到事件驱动架构
PL 到 PS 的中断是控制面的关键通道,错误的中断粒度会让最强的硬件也败给软件开销。Zynq 的 F2F 中断数量有限(7000 有 16 根专用 PL 中断),多事件源必须在 PL 内做聚合:一个标准中断控制器 IP(或自研)提供 status(写一清零)、mask、unmask、一组原始事件计数;一个中断线可承载几十个事件源,ISR 读一次 status 循环处理所有挂起位。设计语义时要区分电平/脉冲、ISR 中的“写一清零”与“处理完再清”的时序,避免清除后硬件同拍又置位导致丢事件——RTL 应实现“清除与置位同拍时新事件保留”。频率纪律:数据面事件在硬件聚合为帧/块/水位/错误四类,正常稳态中断率应保持在每秒数千以内(60fps 视频即 60 次),逐数据、逐描述符中断在任何高性能路径上都不可接受;必要时实现“完成队列+阈值+超时”三重通知(攒够 N 块或等待 T 微秒必通知),兼顾吞吐与延迟。
软件侧的配套模式:ISR 只做状态读取和下半部调度,不做 cache 同步和大块数据拷贝;事件处理线程/工作队列按环形队列消费;必须维护“软件最后处理序号 vs 硬件当前序号”,ISR 漏一次(或被合并)也能通过序号差恢复,而不是死等某号事件;提供中断风暴保护(硬件可配置节流,软件统计异常频率)。Linux 驱动还要正确实现中断与电源管理(suspend 时屏蔽、resume 后重新握手)。调试时把中断频率、ISR 耗时、事件合并数做成计数器,性能问题往往一眼定位为“90% CPU 在内核态处理中断”。好的中断架构让 CPU 绝大多数时间可以睡眠或处理业务,只在硬件真正需要决策时被唤醒——这与 DMA 描述符环共同构成了“硬件自主运行、软件批量介入”的标准范式。
十二、低延迟 PS↔PL 通路与实时 Linux 策略
并非所有 Zynq 应用都追求带宽,控制类应用的痛点是往返延迟:CPU 写寄存器→PL 动作→读状态的单次时间。经 Linux 用户态的标准路径(系统调用→驱动→GP 口→AXI-Lite→PL→中断→调度→用户态)常见几微秒到几十微秒且抖动大。压缩延迟的手段按代价递进:用户态直访,UIO/VFIO mmap 寄存器,轮询状态位代替中断,可压到亚微秒到一两微秒(GP 口本身数十纳秒级);缓存与内存策略,控制结构放 OCM(片上内存,免 DDR 不确定性)或 ACP/coherent 小缓冲,避免 cache miss;线程与 CPU 固定,isolcpus+nohz_full+实时调度策略+mlockall,关闭深度 C-state;PREEMPT_RT,把内核大部分自旋锁改为可抢占,改善全局抖动但仍有底线;把闭环移出 Linux,R5/裸机(MPSoC)或 PL 本地完成控制律,Linux 只下发设定值,这是唯一能硬保证周期的方案。
PL 侧配合:寄存器读路径组合尽量短(GP 事务到状态数据不超过一到两个时钟周期等待),需要多周期读取的状态先在本地寄存器更新、AXI 从口只采样;避免 AXI 从口被其它总线流量阻塞(给控制口独立互联或最高仲裁);时间戳在 PL 硬件打。延迟必须用统计方法测量:百万次 GPIO 翻转/软件时间戳混合测量,给 p50/p99/p999/max,在负载注入(网络、磁盘、全 DDR 带宽)前后对比。常见误判是拿平均延迟当实时能力——均值 2μs 但 p999 50μs 的系统不能做控制环。最终架构选择应回到需求:毫秒级 HMI 控制用普通 Linux 足矣;十微秒级、可偶尔抖动的用 RT 内核+用户态;微秒级硬周期必须离开 Linux,这正是 MPSoC 引入 R5、7000 时代靠 PL 状态机的根本原因。
十三、PS/PL 数据通路交付清单与常见现场问题
把数据交互子系统的验收要点收为一张清单。硬件配置:HP/HPC/GP/ACP 端口方向与位宽、AXI 时钟频率、ID 宽度(互联前缀)、FIFO 深度按带宽延迟公式计算;DDR 分区/保留内存与 Linux 内存映射一致;跨时钟域全部经 FIFO。DMA 与缓冲:描述符格式版本化、地址全部来自 dma API、环的满空/回绕/重置时序明确;缓冲对齐缓存行与突发边界;cache 操作覆盖完整范围且在门铃之前;VDMA 三缓冲、stride 正确、帧序号贯通。中断:聚合器 status/mask/ack 完备,通知策略(阈值/超时)可调,软件有序号恢复。控制面:版本握手、复位可控、时钟/电源状态可读、AXI 从口永有响应。可观测:各口吞吐计数、FIFO 水位与溢出、帧/描述符丢弃、错误响应、cache 同步点可追踪(至少计数)。验证:非缓存对照实验(快速隔离一致性问题)、72 小时满速、DDR 拥塞注入、PS 重启 PL 保活/重配、升级回滚。
现场高频问题速查:数据全错先查地址(虚拟/bus 混用)和字节序;偶发旧数据查 cache 同步点与屏障顺序;高负载丢帧查 HP 口计数器和 FIFO 水位定位供给/带宽;VDMA 撕裂查缓冲数和软件提交节奏;启动早期访问挂死查比特流就绪与 AXI 时钟使能;Linux 升级后 DMA 异常查内核 DMA API/设备树内存保留策略变化。建议把这张速查表和“先做非缓存复测、再查地址、再看计数器”的三步法写入团队 onboarding 文档——Zynq 数据问题 80% 都落在这三个已知坑里,系统化的排查顺序比个人经验更可靠。
十四、案例串讲:一个多路采集系统的数据面决策过程
用一个完整案例把端口、一致性、缓冲和带宽串起来。需求:8 路传感器,每路 200MB/s 聚合 1.6GB/s,数据实时进 PL 做滤波和帧封装,结果一路送显示、一路存 SSD/网络,PS 负责配置、Web 界面和文件系统,偶发的小批量参数表需要 CPU 与 PL 共享。第一步算总账:DDR4 保证带宽按 70% 估算后必须高于聚合速率,1.6GB/s 数据若“写一次再读一次”需要 3.2GB/s,接近端口舒适区上限——因此决定原始流不落盘,只在 PL 内处理;落盘的是压缩后的约 400MB/s 结果流,显示流 300MB/s,DDR 总占用可控。第二步选端口:结果流经一个 64 位 HP 口写 DDR(非缓存大块、S2MM),显示经另一个 HP/VDMA 读,物理端口分离减少争用;参数表走一小块 coherent 内存(ACP),控制寄存器走 GP0。第三步设计内存:大缓冲 2MB 对齐、设备树预留或 dma 分配、流式 map/unmap 精确同步;参数结构用 dma_alloc_coherent,CPU 写完置门铃(屏障后),PL 消费后清位。第四步中断:帧级中断每 10ms 一次,FIFO 水位错误单独事件,8 路丢失/错误计数全部可读。
验证时先打垂直切片:一路传感器→处理→DDR→PS 读回校验,第二周就跑通;随后逐步加到 8 路并注入 DDR 竞争(同时跑显示和文件写入),用计数器发现 PS 文件系统突发流量在某固件版本下会使 VDMA 一帧延迟抖动,通过在互联仲裁给显示口老化优先级解决。72 小时 soak 期间发现两次温度升高后的 ECC 可纠正位,按 专家 21 的健康策略记录趋势并确认在器件规格内。复盘时最有价值的不是“跑通了”,而是每个决策都有量化依据:端口选择来自带宽矩阵,缓冲策略来自一致性模型,仲裁权重来自实测 FIFO 水位。Zynq 数据通路的深水区没有玄学,只有把端口微结构、缓存协议、DDR 调度和软件 DMA 语义四件事算到同一张账上。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 共享内存走 cache 不同步 | 旧数据/看不见新值 | flush/invalidate 或非缓存 |
| 描述符填虚拟地址 | 访问错误物理地址 | 填 dma_handle/bus 地址 |
| 硬编码物理地址 | 撞内核内存 | dma 接口分配/预留段 |
| 多口都按峰值算 | DDR 总带宽爆 | 按共享总量核算 |
| 发一笔等一笔 | HP FIFO 空转 | 长突发+outstanding |
| 视频用普通 DMA | 撕裂/同步难 | VDMA 多缓冲 gen-lock |
相关与延伸
用法:Zynq 数据交互入门;带宽:DDR 深水区、DMA 搬运。 协同:Zynq PS/PL、视频流水线、MPSoC/Versal。
一句话总结
Zynq 数据通路:PL 经 HP0~3 口作为主设备高带宽直访 PS DDR(不监听 cache),ACP/HPC 口提供硬件 cache 一致性,GP 口只做控制寄存器访问,VDMA 管视频帧多缓冲。最易出 bug 的是缓存一致性:CPU 经 cache、PL 经 HP 直访 DDR 不同步——CPU 写后 PL 读要 flush 回写、PL 写后 CPU 读要 invalidate,或干脆用非缓存/dma_alloc_coherent 内存(控制结构用一致性小内存、大块数据用非缓存显式 sync);要自动一致走 ACP/HPC。第二大坑是地址域:DMA 描述符必须填 dma 接口给出的 bus/物理地址而非指针虚拟地址,且物理内存要由 dma_alloc/dma_map 分配不能硬编码。带宽上 DDR 总容量全员共享、HP 口靠长突发+高 outstanding+持续供给填满内部 FIFO,看吞吐计数器和 FIFO 水位区分"喂不饱"与"总带宽到顶";视频用 VDMA(多缓冲防撕裂 gen-lock),通用流用 AXI DMA SG。