ASIC CI/CD 与 nightly 回归:把「人肉点工具」变成可重复的流水线(G5)
软件式 CI 的执行后端是计算集群与 license,见 G3 LSF;各阶段门禁判据来自 X1 交接契约,产物/基线组织见 X4,指标聚合见 X5 看板,ECO 触发的重跑见 X3 作废链。FPGA 侧 CI 见 FPGA CI/CD。本篇讲整条 ASIC 自动化回归体系怎么分层搭。
一、为什么芯片 CI 比软件 CI 难
| 难点 | 表现 |
|---|---|
| 单次任务极重 | 一次综合/P&R/全回归几小时、几十核、数十 GB 内存(G3),不可能每个 commit 全跑 |
| 受 license 限制 | 并发数由商业令牌决定,CI 并发上限不是机器而是钱 |
| 多级产物有依赖 | RTL→网表→SPEF→签核层层消费,必须版本同源(F10) |
| 通过标准是多维 QoR | 不只是 PASS/FAIL,还有时序/面积/功耗/覆盖率的趋势与预算(C3) |
| 工具版本敏感 | 工具/库/PDK 升级会让 QoR 漂移,环境必须可复现 |
| 长周期 | 一次流片项目数月,基线要长期可追溯、可重放 |
因此 ASIC CI 的核心是按代价分层 + 按节律调度,而不是「每次提交什么都跑」。
二、分层门禁:快的挡住低级错,慢的守住质量
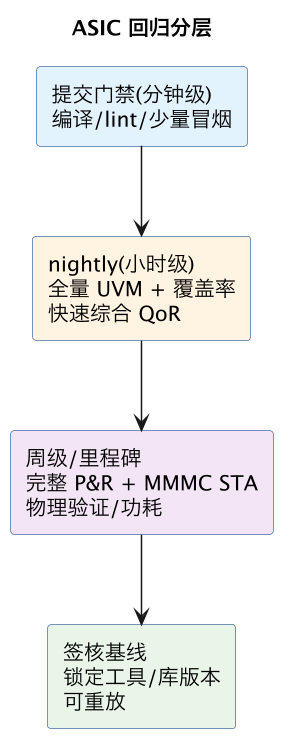
第 1 层:提交门禁(pre-commit / MR gate,分钟级)
开发者提合并请求时跑快、确定性高的检查,低级错误不进主线:
- RTL/UVM 编译能过(A4 build)、filelist 完整;
- Lint/可综合性检查(B1)——零新增违例,waiver 受控;
- CDC/RDC 结构扫描(B2)增量;
- 一小批冒烟仿真(smoke):复位、基本读写、关键用例,保证主线不被低级破坏;
- 文件/编码规范、禁止提交临时文件、检查 clock/reset 约定。
这一层要快(几分钟),否则开发者绕过它;重型工具可只跑增量或用轻量引擎(Verilator 做编译/lint 极快,B1)。
第 2 层:nightly 全量回归(过夜,小时级)
每晚对主线自动跑:
- 全量 UVM 回归(阵列作业撒到 LSF,A2)+ 功能/断言/代码覆盖率合并,看覆盖率只升不降、无新增失败;
- 快速综合 + 估计 STA/面积/功耗(不必完整 P&R),抓「这一改动让时序塌了/面积暴涨」,产出 QoR 趋势;
- 形式验证增量(B3)、功耗感知/低功耗检查;
- 结果早上聚合到看板:哪些用例从绿变红、谁的提交引入、QoR 曲线变化(X5)。
第 3 层:周级 / 里程碑物理与签核(最贵)
完整后端任务按周或在重要节点跑(单次很久、license 贵):
- 完整 P&R + 多角 MMMC STA(D1/E2),看真实 postroute 收敛;
- 物理验证 DRC/LVS/ANT(E3)、功耗/IR/EM(E4);
- DFT 覆盖率(C4)、门级仿真精选(C5);
- 为流片产出可重放的签核基线:固定工具版本、补丁、库/PDK 版本、约束、seed 与命令脚本(F10),保证半年后还能复现同一份 GDS。
三、基线(baseline)与产物管理
CI 必须回答「这次结果是基于什么跑的」:
- 输入基线:RTL commit、约束 SDC 版本、UPF、testbench、库/PDK、工具版本/补丁、宏与 IP 版本统一打 tag(X4);
- 产物按 run id 落盘:网表、SPEF、报告、日志、覆盖率数据库、波形(失败用例才存波形省空间),不可被后续 run 覆盖;
- 比较基线(golden baseline):每次结果与上一已知良好基线 diff——QoR 数字、违例数、覆盖率,任何非预期变化都高亮;
- 网表/SPEF/SVF 等跨阶段产物必须同轮同源,CI 用 manifest 记录并在消费时校验(C5 版本纪律)。
四、结果聚合、flaky 与自动分诊
- 统一退出码/报告解析:各 EDA 工具退出码不可靠(常 0 退出但有 ERROR),CI 要解析日志关键字(
Error/Violating/Fatal)和报告文件而非只看返回码; - 失败自动重试 + 分诊:机时型 flaky(主机坏、license 抖动、共享盘)自动重投;真功能失败保留波形、关联触发提交、@责任人(A3 调试);
- flaky 治理:仿真 flaky(seed 敏感、竞争、未初始化 X、随机 timeout)要建库统计、限期修,否则红灯被无视(UVM seed 多跑、确定性复现,见 A2);
- 趋势比单点重要:时序/面积/功耗/覆盖率画成随提交的曲线,劣化在变红之前就能看出(X5)。
五、与 ECO/变更传播联动
设计后期任何 ECO 都按 X3 作废链 自动确定要作废重跑的下游:改 RTL → 重综合 → 重 LEC → 重提寄生 → 重签 STA/功耗/物理验证。CI 维护「产物依赖图」,ECO 合入时自动投递受影响的最小作业集合,而不是全量重跑或(更糟)漏跑某个签核 corner。
六、落地建议
- 先打通可重复命令化:每个工具 run 都能用一条非交互命令 + 版本文件复现(抛弃 GUI 手工点);
- 先上编译/lint/冒烟门禁拿到快胜,再建 nightly,最后接物理签核;
- 与 LSF 和 license 计量联动,按队列与令牌配额排作业,别让 CI 把白天交互算力吃光;
- 工具/库版本写进流水线配置,升级走专门的「迁基」分支评估 QoR 漂移;
- 看板对所有人可见,把绿灯当主线健康底线,红灯优先修——CI 的价值取决于团队是否真的信任并响应它。
相关与延伸
- 执行后端:G3 LSF/license。
- 数据体系:X1 门禁、X3 ECO 作废、X4 数据管理、X5 看板、F10 版本基线。
- 被自动化的工具:B1 Lint、B2 CDC、A2 UVM、E1 STA、E3 Calibre。
- FPGA 侧:FPGA CI/CD。
总结
芯片 CI 不能照搬软件「每次提交全量跑」,因为综合/P&R/全回归是几小时、几十核、吃数十 GB 内存且并发受 license 令牌硬约束的重任务,正确做法是按代价分三层:分钟级提交门禁用快速编译、lint、CDC 增量和少量冒烟把低级错误挡在主线外,过夜的 nightly 把全量 UVM 回归、覆盖率合并和快速综合 QoR 撒到 LSF 集群、早上用看板告诉你哪条用例变红和时序面积趋势,周级或里程碑再跑完整 P&R 加 MMMC STA、物理验证、IR/EM 与 DFT 并锁定可重放的签核基线;整套体系必须给每次 run 记录 RTL/SDC/库/PDK/工具补丁的统一 tag、按 run id 落产物、与上一 golden 基线做差异比较,解析日志关键字而不信工具退出码,对机时型 flaky 自动重投、对 seed 敏感和 X 初态型仿真 flaky 建档限期修,并维护一张产物依赖图让 ECO 合入时只自动重跑作废链上受影响的下游 corner;落地的前提是先把每个工具 run 变成带版本文件的非交互命令、把工具与库版本纳入流水线配置并对升级做专门的迁基评估——CI 真正的价值不在跑了多少任务,而在团队是否信任并立刻响应那条代表主线健康的绿灯。