FlashAttention-3:Hopper 上的 warp 专业化、TMA 与 FP8 三件套
更新时间:2026-10-02。前面 FlashAttention 显存分块 tiling 讲过 FA1/FA2 的核心思想:用分块加在线 softmax 把注意力的显存访问量从 O(N²) 压到 O(N),让瓶颈从「搬数据」变成「算矩阵」。到了 Hopper(H100)这一代,硬件给了三件新武器——异步拷贝引擎 TMA、warp group 级矩阵指令、FP8 tensor core——但 FA2 的「所有 warp 干一样的活」的老结构用不上它们。FlashAttention-3(FA3)就是围绕这三件武器重写的一次架构升级,在 H100 上把 FP16 注意力打到理论峰值的约 75%,FP8 模式吞吐再接近翻倍。与之配套的 Hopper 编程手法可对照 warp specialization 生产者消费者流水线。
本文要回答的问题
- FA2 在 H100 上为什么只能跑到理论峰值的三四成?瓶颈从显存搬到哪里去了?
- warp specialization 怎么把一个 CTA 里的 warp 分成「搬数据的」和「算矩阵的」两班人马?
- TMA 相比传统的
cp.async省了什么,为什么它是异步流水的前提? - FP8 注意力怎么在精度不崩的前提下把 GEMM 吞吐翻倍?
- 三大特性叠加后的整体流水线长什么样,性能数字从哪来?
一、FA2 在 Hopper 上的天花板:同步流水线喂不饱 tensor core
先回顾 FA2 的打法:每个 thread block(CTA)负责一段 query tile,内层循环沿 K/V 序列逐块前进——把一块 K 搬进 shared memory(SMEM),同步等待,算 QK^T,更新在线 softmax,搬 V,算 PV。这套结构在 A100 上很好使,因为 A100 的 cp.async 能让「搬下一块」与「算这一块」部分重叠,整体能摸到峰值的 60%~70%。
到了 H100,账变了。H100 的 FP16 tensor core 峰值是 989 TFLOPS(稠密),是 A100 的 3 倍多;但 HBM 带宽只从 2 TB/s 涨到 3.35 TB/s。算力涨得比带宽快得多,留给 kernel 的「搬运容错时间」被压缩了。更要命的是 Hopper 的新指令本身就是异步的:WGMMA(warp group matrix multiply-accumulate,一次由 4 个 warp 组成的 warpgroup 发起的矩阵乘)发出后不占着 warp 等待,TMA(Tensor Memory Accelerator,张量内存加速器)搬数据也不需要 warp 逐条发地址。FA2 那种「一个 warpgroup 里每条指令顺序依赖、用 barrier 串起来」的同步写法,把这些异步能力全部浪费了——实测 FA2 在 H100 上只跑到峰值的 35% 左右。
问题本质:FA2 的流水线里,「等待」和「计算」是串行的。barrier 一到,全 CTA 的 warp 一起停;WGMMA 发出后,同一些 warp 又没法同时去发下一批搬运请求。要喂饱 H100,必须把「搬」和「算」拆给不同的人并行推进。

上图是 FA2 内层循环的依赖链:每一站都卡一个全量 barrier,搬运和计算永远无法真正重叠。FA3 的破法不是在这条链上修修补补,而是把链拆开重排。
二、warp specialization:搬数据的和算矩阵的分班作业
FA3 的第一个大招是 warp specialization(warp 专业化):一个 CTA 里不再让所有 warp 齐步走,而是分成两类角色——
- 生产者 warpgroup(producer):专职发 TMA 拷贝指令,把下一块 K、V 从 HBM 搬进 SMEM 的多级缓冲(multi-stage buffer),发完就不管,靠 barrier 信号通知消费者「第 i 级缓冲满了」。
- 消费者 warpgroup(consumer):专职发 WGMMA 和做 softmax 标量运算。它从缓冲里取第 i 级的 K 算 QK^T,同时生产者正在往第 i+1 级搬下一块——搬与算在时间轴上错开重叠。
这套结构的关键配套是 SMEM 多级流水(通常 2~3 级)和 Hopper 的 mbarrier(带事务计数的异步 barrier):TMA 拷贝完成时硬件自动给 mbarrier 记账,消费者 try_wait 到了就直接用,不需要软件轮询。生产者与消费者之间还有一层「乒乓互斥」:消费者用完第 i 级缓冲要发信号还给生产者,生产者才能往里填新数据。
注意上图里消费者被画成了 A、B 两个 warpgroup,这是 FA3 的进一步榨取:softmax 里的 exp、缩放这些标量/向量运算是跑在 CUDA core 上的,WGMMA 跑在 tensor core 上,两者是不同的执行单元。FA3 让一个消费者 warpgroup 在算第 i 块的 softmax 修正时,另一个消费者 warpgroup 的 WGMMA 正在算第 i+1 块的 QK^T——CUDA core 与 tensor core 也重叠起来。这一步把 FA3 从「搬运与计算重叠」推进到「三类单元(TMA、tensor core、CUDA core)全部并行」,是冲上 75% 峰值的关键。
这套分工在 FA3 论文里被细化为两种调度模式。第一种叫「乒乓调度」(pingpong):两个消费者 warpgroup 严格交替,A 做 GEMM 时 B 做 softmax,下一轮交换,靠命名 barrier 互斥,保证任一时刻 tensor core 上总有一家的 WGMMA 在飞。第二种叫「协作调度」(cooperative):两个消费者对同一块 tile 分工,一个算 QK^T 的前半,一个算后半,softmax 也拆开并行——适合 tile 较大、单个 warpgroup 吃不满的场景。论文实测乒乓模式在长序列上更优,因为 softmax 与 GEMM 的耗时比在典型 head dim(64/128)下接近一比二,两家轮流刚好填平。这也解释了为什么 FA3 的 tile 配置表里 head dim 64 与 128 走不同的调度分支:流水线级的耗时配比随 tile 形状变化,调度策略要跟着换。对读者来说,记住「乒乓重叠 GEMM 与 softmax」这一条就够了,具体分支选择交给官方实现。
代价也不是没有:寄存器和 SMEM 预算被两班人马分薄了。每个 warpgroup 可用的寄存器变少,tile 尺寸、缓冲级数都要精打细算,这也是 FA3 只支持 Hopper 的原因之一——它的整个资源账本都是按 H100 的 228 KB SMEM 和大寄存器堆配的。
三、TMA:一条指令搬一个 tile,还把 warp 从寻址里解放出来
第二个武器 TMA 值得单独说,因为它是上面流水线能成立的硬件前提。传统 cp.async(A100 时代)每条指令搬 16 字节,搬一个 64×64 的 FP16 K tile 要 warp 里每个线程各发一条、还要各自算全局地址和 SMEM 地址,地址生成的指令开销不小,还占用发射槽。TMA 的做法是:在 host 或 kernel 开头先建一个「张量描述符」(tensor map),里面写清张量的基址、形状、stride、tile 尺寸;运行时一条 cp.async.bulk.tensor 指令就把整个多维 tile 搬完,越界自动补零,地址边界自动处理,完成时自动给 mbarrier 记账。
带来的收益是双份的。其一,指令数从几百条降到一条,发射压力几乎归零——生产者 warpgroup 只用很少几条指令就能维持整条搬运流水线,这就是为什么一个生产者 warpgroup 就够喂两个消费者。其二,TMA 自带 SMEM 内的 swizzle(交错排布)模式,写进 SMEM 时就按 WGMMA 喜欢的 bank 布局摆好,避免后面读数时的 bank conflict(共享存储体冲突,背景见 shared memory bank 冲突)。在 FA2 里,这套 swizzle 要靠加载指令的地址计算来做;在 FA3 里它是免费的。
TMA 还有一个和注意力特别对口的特性:它搬的是「逻辑张量」而不是「线性地址段」。K、V 在显存里按 [seq, head, dim] 三维摆,FA3 要的 tile 是「某个 head 的一段 seq × 全 dim」,这是一个跨 stride 的二维切片。传统写法要么提前转置出一个连续副本(白付一次全量读写),要么每条加载指令做三维寻址(发射开销大)。TMA 描述符直接声明三维形状和 stride,切片是硬件在搬运途中完成的——逻辑视图和物理布局解耦,这正是异步流水能写干净的工程基础。可以把它理解成 DMA 控制器从「只会顺坡搬连续段」进化到「看懂了张量」,DMA 描述符环设计 里讲的描述符驱动搬运思想,在 GPU 内部被 TMA 推到了多维版本。
| 对比维度 | cp.async(FA2/A100) | TMA(FA3/Hopper) |
|---|---|---|
| 单条指令搬运量 | 16 字节/线程 | 整个多维 tile(一条指令) |
| 地址计算 | 每线程算全局+SMEM 地址 | 描述符一次配置,硬件生成 |
| 越界处理 | 软件 mask | 硬件自动补零 |
| 完成通知 | 软件 commit/wait 组 | mbarrier 事务自动记账 |
| SMEM swizzle | 地址计算实现 | 描述符内置模式 |
| 占用执行资源 | 占用发起 warp 的发射槽 | 独立 DMA 引擎,warp 发完即走 |
四、FP8:把 GEMM 吞吐翻倍,代价是把误差管住
第三个武器是 FP8。H100 的 FP8 tensor core 峰值是 FP16 的两倍(约 1979 TFLOPS),FA3 支持把 Q、K、V 量化到 FP8(E4M3 格式,4 位指数 3 位尾数;格式细节见 FP8 E4M3 与 E5M2 推理)来做两个 GEMM,理论上注意力吞吐直接翻倍。
但 FP8 的尾数只有 3 位,直接量化注意力的输入会踩两个坑。第一个坑:softmax 的输入分布对量化误差的敏感度是不均匀的。QK^T 的分数 S 里,最大值附近的元素决定 softmax 的权重分布,如果大值被量化误差扰动,注意力权重就偏了。FA3 的应对是「按块量化加去量化交织」:Q、K、V 以 tile 为单位各带一个缩放因子(per-block scaling),WGMMA 在 FP8 下算,但累加器保持 FP32,每块算完立刻按缩放因子还原——误差被限制在单块内部,不跨块累积。
第二个坑更隐蔽:V 的布局。FP8 WGMMA 要求第二个操作数的 K 维连续,而 PV 这个 GEMM 里 V 需要转置使用。FA2 在 FP16 下靠 SMEM 里的 ldmatrix 转置读解决,但 FP8 的 WGMMA 指令不接受那种布局。FA3 的办法是借助 TMA 的描述符变换能力,让 V 在 HBM→SMEM 的搬运途中就完成布局调整,同时做 in-kernel transpose 作为补充。这类「为了一条指令的数据布局而改整条数据通路」的权衡,是 FP8 kernel 工程的日常。
误差控制效果:FA3 论文报告 FP8 模式下相比 FP16 的均方误差在 1e-3 量级,下游任务(困惑度、基准分数)基本无损。前提是缩放因子要选好——通常按张量或按块统计绝对值最大值来定,这和 混合精度 FP16/BF16/FP8 里讲的量化校准是同一套思路。
上图画清了 FP8 路径里「量化—计算—去量化」的交织:所有 tensor core 运算在 FP8,所有累加和 softmax 在 FP32,两种精度在每个 tile 边界交接一次。吞吐翻倍的同时把误差摁在块内,这就是 FA3 FP8 模式的全部精髓。
五、合体:三阶段重叠的完整流水线
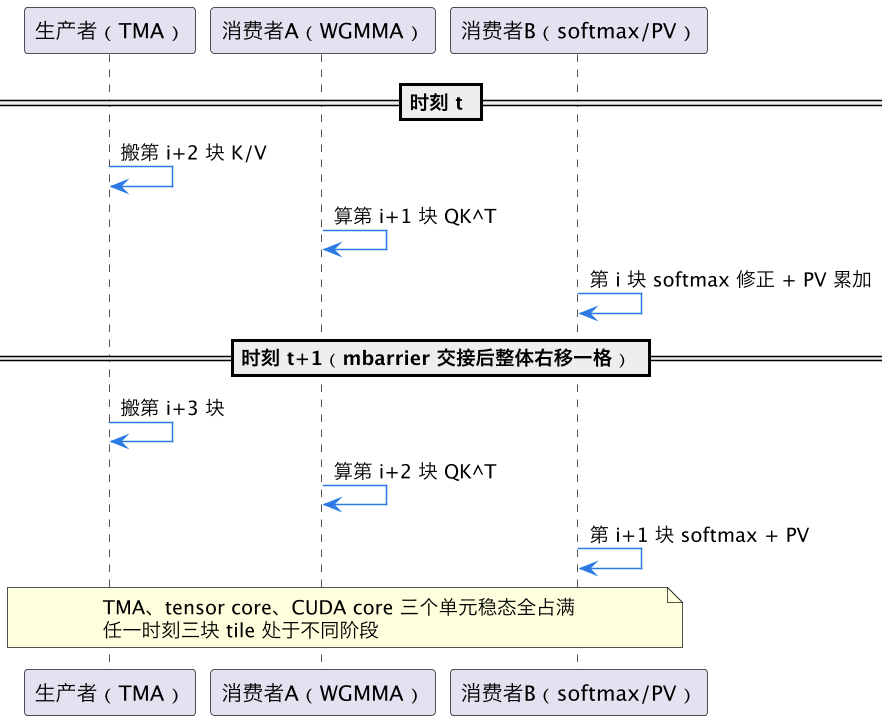
把三件武器合起来看 FA3 一个迭代内的全景:生产者 warpgroup 用 TMA 把第 i+2 块的 K/V 往 SMEM 搬;消费者 A 用 WGMMA 算第 i+1 块的 QK^T;消费者 B 在 CUDA core 上做第 i 块的 softmax 修正并累加 PV。三个硬件单元各干各的,mbarrier 做交接。循环稳态时,tensor core 几乎不停——这就是 75% 峰值的来源(FA2 是 35%,提升约 1.5~2 倍;FP8 模式相对 FP16 再提约 1.5 倍量级)。
实际数字补一组:FA3 论文在 H100 SXM5 上测 FP16 前向,序列 8K、head dim 128 时约 740 TFLOPS,对 989 的峰值正好是 75% 上下;同配置 FA2 约 350 TFLOPS。反向传播因为要重算 S 和 P,流水线更复杂,也能到 60% 左右。另一个常被忽略的点是变长序列(varlen)支持:真实推理批里各请求长度不一,FA3 沿用 cu_seqlens 的打包格式,把整个批次的 Q/K/V 拼成一条长序列,靠 TMA 描述符的边界补零特性,一个 tile 跨请求边界时自动读到零,天然兼容,不需要为变长另写一套 kernel。
这张时序图是对第二节结构图的时间维展开:稳态下任一时刻有三块不同的 tile 分别处在搬运、GEMM1、softmax/GEMM2 三个阶段。用流水线的语言说,FA3 把注意力内层循环拉成了一条三级以上的软件流水,而 FA2 只是一条反复起停的串行链。想从调度视角理解这种「让不同硬件单元同时有活干」的思想,GEMM split-K 与 stream-K 调度 里对波浪量化(wave quantization)空泡的处理是同源问题。
六、适用边界与落地现状
FA3 不是免费午餐,落地前要知道它的边界:
- 只吃 Hopper:TMA、WGMMA、FP8 tensor core 都是 H100/H200 独有,Ampere 及更老卡请继续用 FA2;Blackwell 上 FA3 能跑但没有针对新指令重做。
- 集成路径:FA3 以 CUTLASS/CuTe 写就,已合入 FlashAttention 官方仓库的
hopper/目录,PyTorch 侧通过 flash-attn 包的flash_attn_3接口或 vLLM/SGLang 等引擎调用;配合 PagedAttention 分页 KV 时是引擎侧把分页布局转成连续 tile 再喂 FA3。 - decode 收益有限:decode 阶段每个请求只有 1 个 query,kernel 瓶颈在 KV 带宽而非 GEMM 算力,FA3 的流水线优势主要体现在 prefill 和长序列训练;decode 请看 FlashDecoding 的 split-K 切分。
- FP8 要校准:训练场景直接用 FP8 注意力需要逐层验证误差;推理场景配合 per-block scaling 基本开箱可用。
- 寄存器/SMEM 账本紧:tile 配置是按 H100 的 228 KB SMEM 定制的,移植或改 tile 大小时要重算 occupancy(背景见 occupancy 与寄存器压力)。
| 场景 | 推荐 kernel | 理由 |
|---|---|---|
| H100 prefill / 训练(长序列) | FA3 FP16 | 75% 峰值,明确收益 |
| H100 推理 prefill(可校准) | FA3 FP8 | 吞吐再翻倍,误差可控 |
| H100 decode | FlashDecoding/引擎自带 | 瓶颈在带宽不在算力 |
| A100 及更老 | FA2 | 无 TMA/WGMMA/FP8 硬件 |
这一篇在知识体系里的位置
本篇是「注意力 kernel 优化」线索的 Hopper 一环:上游是 FlashAttention 显存分块 tiling(在线 softmax 与分块的总框架)和 warp specialization 生产者消费者流水线(FA3 用到的通用编程模型);同层可对照 FlashDecoding 的 split-K 切分(decode 阶段的另一条优化路线)、FP8 E4M3 与 E5M2 推理(低精度格式本身)与 GQA/MQA 的 KV 节省(从算法侧减少搬运量);下游延伸是 Blackwell 代际的注意力 kernel 重写与训练侧 FP8 全流程。
总结
FlashAttention-3 把 FA2「全员同步齐步走」的循环拆成 warp 专业化的异步流水线——生产者 warpgroup 用 TMA 一条指令搬一个 tile,消费者 warpgroup 用 WGMMA 算矩阵、CUDA core 做 softmax 修正,三类硬件单元在 mbarrier 交接下稳态全占满,再叠加 FP8 per-block 量化把 GEMM 吞吐翻倍、把误差摁在单块内——最终让注意力在 H100 上从 35% 峰值冲到 75%,证明「算法不变、只重排执行结构」依然能榨出一倍以上的性能。