FPGA 原型验证专题 38:国产与第三方原型平台生态——可用性、工具链差距、供应链约束与迁移成本
更新时间:2026-09-13。本文是模块 A 第三篇。36 商用原型平台版图 HAPS/Protium/第三方能力边界把平台分成三类,第三类"国产/自研体系"本篇展开。这是一个快速变化、市场材料与实际能力差距较大、公开客观信息稀缺的领域,因此本文刻意多讲评估方法和迁移工作量、少给静态厂商排名(排名会过时,方法不会)。文中提到的能力档位是行业一般认知,具体到某个项目必须用 77 篇的"自带设计做 benchmark"方法实测。
一、为什么这条路线必须被严肃评估
过去国产替代多停留在"有就行"的合规表态,但近年三个变化让它成为真实工程选项:国产大容量 FPGA 器件容量和 SerDes 速率持续逼近主流、供应链与出口管制使"下一代器件能否稳定供货"成为不可忽视的风险、以及原型平台本身是内部验证工具(不随芯片出货、不进客户 BOM),在这里试国产器件的风险远低于在产品里用。原型平台因此常成为团队熟悉国产 FPGA 工具链的"练兵场"。但"能跑"和"能支撑一个紧张工期的 SoC 项目"之间差距很大,需要冷静拆解。
二、国产/自研原型生态的四种形态
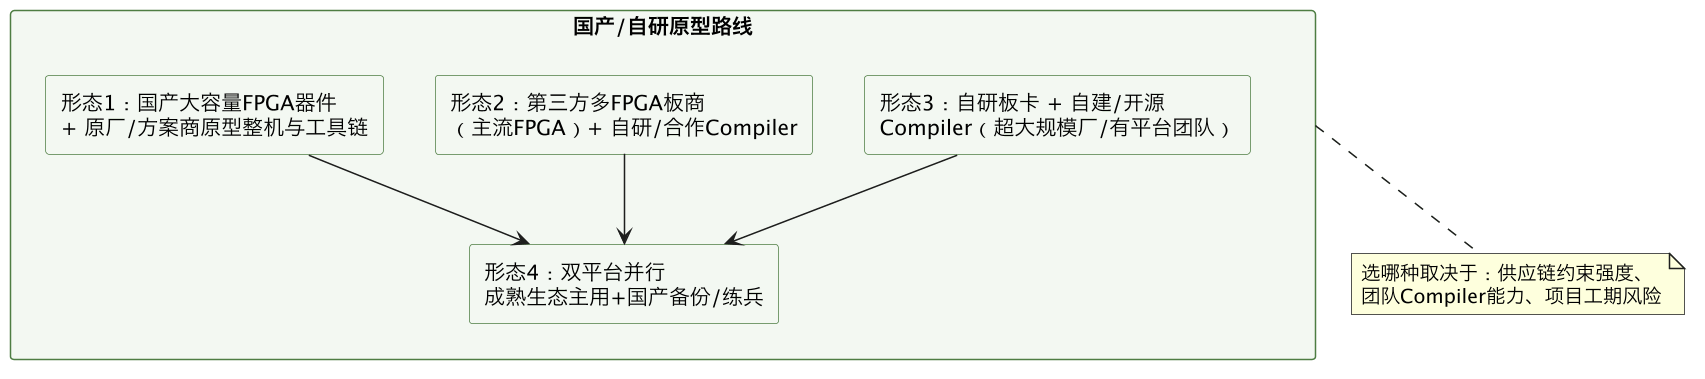
- **形态 1:国产 FPGA 器件 + 原厂整机方案。**采用国产大容量 FPGA,由器件原厂或其方案商提供原型板、Compiler、基础 IP 与现场支持。风险点集中在 EDA 工具链成熟度(综合优化质量、时序收敛、调试器)和高端器件的可得性/良率;优势是供货自主、商务支持力度大。
- **形态 2:第三方板商(仍用主流 FPGA)+ 自研或合作 Compiler。**板卡本身用国际主流 FPGA,规避了器件工具链风险,差异化在板级设计、互联密度、子卡生态和自研 Compiler。供应链风险仍在 FPGA 器件本身,但不受单一 EDA 平台绑定。
- **形态 3:完全自研(自研板 + 自建/基于开源的 Compiler)。**只有具备专门平台团队的超大规模厂或有长期沉淀的公司可行。06 原型验证系统全景与文档地图讲过自研 Compiler 的动机(替换库/ID/回映要与内部流程打通),但成本极高,不适合单个项目临时起意。
- **形态 4:双平台并行。**成熟商业平台承担主力(保工期),国产平台承担部分非关键任务并做能力验证和团队练兵,逐步加量。这是当前风险最可控的过渡策略。
三、用同一把尺子量:五维度上的典型差距
不要用"支持/不支持"的二元口径,而用 36 商用原型平台版图 HAPS/Protium/第三方能力边界同一套维度,评估时按"成熟平台能做到什么"为基准逐项打分:
| 维度 | 成熟平台基准 | 国产/自研路线常见差距(一般认知,需实测) |
|---|---|---|
| 有效容量 | 多片高端 FPGA、单板数十亿门 | 单器件容量/SerDes 数通常低一档,需更多片,放大割边和 TDM 压力 |
| 可达速度 | 相似割边下数 MHz~数十 MHz | 综合优化与时序收敛能力差异直接体现为 DUT 频率更低,软件团队体感最明显 |
| 编译周转 | 成熟分区/增量/并行编译 | 分区自动化和增量能力弱,更依赖手工干预,一轮构建更久 |
| 调试可见性 | 商用深 trace、动态探针免重编(39 商用原型调试 IP 深跟踪/动态探针/可见性预算) | 调试 IP 往往是最大短板:探针浅、跨片触发弱、重编译成本高 |
| 接口生态 | 丰富速率适配子卡(72~75 篇) | 子卡库不全,自研接口桥工作量大;但可用第三方子卡部分补齐 |
| 工具稳定性 | 多代打磨、海量回归 | 工具链偶发崩溃/误报、文档不全、问题定位依赖原厂现场 |
两个要特别核的"隐形维度":一是替换库/IP 模型(11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY)是否覆盖你用到的存储器/PHY/时钟原语——国产 FPGA 的原语体系与主流不同,替换库基本要重建,这是迁移的主要隐性工作量;二是SerDes/硬核 IP(PCIe/DDR/Ethernet 控制器硬核)的完备度和硅验证成熟度,高速接口常常比裸逻辑容量更早成为瓶颈(33 PCIe/SerDes 上原型 硬核/降速子卡/LTSSM)。
四、哪些项目现在就能用、哪些要再等等
现在就比较适合国产/第三方路线的情形:
- 设计规模在国产器件的舒适区(不需要顶到容量极限)、割边数可控;
- 验证以功能、固件、软件为主,对 DUT 绝对频率不敏感(降频补偿做得好,30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算);
- 对调试可见性的要求可以用更多前置仿真/Emulation 来补(把深可见性任务留给成熟引擎);
- 有 FPGA 平台自研能力、能为子卡和替换库投入人力;
- 供应链自主是硬约束,或需要为长期多项目沉淀自有平台能力。
当前仍应让成熟生态担主力的情形:
- 设计顶到单平台容量极限、割边极多、对可达速度要求高;
- 工期紧、第一次做该类芯片、没有平台冗余去吸收工具链问题;
- 强依赖成熟深 trace/动态探针(复杂偶现 bug 多)和大量现成高速子卡;
- 完全没有现场支持可达性,出了时序收敛问题无人兜底。
五、平台迁移到底要重做什么:一张工作量清单
从一个成熟平台迁到另一个(尤其是迁到原语体系不同的国产 FPGA),不是"重新综合一遍"。按工程层逐层列清:
- 原语/替换库层(工作量最大):FPGA 原语、存储模型、时钟单元、I/O、SerDes 硬核全部不同,替换映射和替换库要重建并重验(11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY)。第三方 IP 的黑盒网表往往与器件绑定,需重新拿到目标器件版本。
- 约束与 XDC 层:电平标准、bank、引脚、时序例外全部按新板重写(35 多 FPGA IO 引出与引脚规划 连接器/电平/SI/取舍),dont-touch/探针约束重标。
- 分区与互联层:新板互联拓扑不同,分区约束、割边落点、TDM 通道映射重来(12 多 FPGA 分区算法 割集/容量/图划分);时序收敛预算重算。
- 时钟复位 harness 层:跨片时钟/停插编排、速率适配器重接(31 速率适配器 Speed Adapter 弹性FIFO/两种范式)。
- 接口子卡层:物理子卡和驱动重新适配,等时接口的帧缓冲解耦重做(34 以太网/USB/MIPI 外设接入 子卡生态/等时实时性)。
- 调试层:探针/trace/交叉触发方案按新调试 IP 重搭(39 商用原型调试 IP 深跟踪/动态探针/可见性预算),调试脚本重写。
- 流程与自动化层:构建脚本、版本五件套映射(20 比特流烧录与四方版本一致 manifest/门禁)、回归/农场调度(F2 主题)重新对接。
- 软件 BSP 层:若频率/内存时序/外设枚举时间变了,超时参数、性能校准重做(30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算、42 降频原型架构性能评估 cycle 计数/A-B/伪延迟扣除)。
**迁移成本估算经验:逻辑网表本身几乎不用改,时间主要烧在 1、3、5、6 这四层。**把它当作一次"平台重新 bring-up"排期(通常以月计),而不是一次重新编译。
六、降低风险的双平台并行策略
切换不要"断腕式",推荐并行过渡:
- 选一个非关键但有代表性的子系统先迁(规模适中、含一两个高速接口和典型时钟结构)做完整平台 bring-up,实测五维度和迁移工作量,得到自己的真实数据再决定全面切换节奏。
- 两套平台跑同一批黄金用例做对账:同一 RTL、同一软件镜像,在成熟平台和国产平台上比对结果(41 原型在 SoC 验证矩阵中的定位 用例分配/RACI/证据移交)。结果不一致时先怀疑平台/替换模型——这正是验证新平台可信度的过程。
- 主力保进度、备份练能力:关键路径(流片前软件、性能签核)留在成熟平台,国产平台先承接功能回归和团队培训,随成熟度加量。
- 把平台能力问题反馈给原厂当作商务条件:现场支持响应、替换库补齐、工具缺陷修复时限写进合同。
七、合规与供应链如何进入选型
选型表里除了技术维度,还要单列风险维度(F5 主题会系统讲 license/出口管制):器件与工具的出口管制分类、供货连续性与替代料、license 服务器能否在自有/受限网络运行、RTL/比特流流转是否需要出境或过云、原厂在本地的支持实体。国产/自主路线的价值不仅是性能对标,更是"关键项目不被断供"的风险定价——这部分价值应在 44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本 里作为风险项量化,而不是只比采购价。
八、试点迁移的排期与验收清单
双平台并行不能只喊口号,给一个可落地的试点节奏(以"一个含高速接口的代表子系统"为单位):
| 阶段 | 工作 | 出口标准(达不到不进下一阶段) |
|---|---|---|
| 第 1~2 周 评估 | 用真实网表做五维度 benchmark(77 篇);盘清替换库缺口和绑定器件的第三方 IP | 拿到片数/频率/构建时长的实测数,不是厂商标称 |
| 第 3~6 周 平台 bring-up | 重建替换库与约束、跑通分区与时序、搭时钟复位 harness(68 篇) | 裸设计能下载、时钟稳定、跨片握手自测通过 |
| 第 7~9 周 接口与调试 | 适配 1~2 个真实速率适配子卡(72/75 篇)、搭调试探针和跨片触发(80/81 篇) | 真实外设互通;能用调试 IP 抓一次跨片事件 |
| 第 10~12 周 对账 | 同一 RTL/镜像/黄金用例在新旧平台比对(82 篇) | 结果一致或差异有明确根因(多数应归因替换模型) |
| 第 13 周起 放量决策 | 按实测的人力投入和性能差距,决定加量范围/继续备份/暂缓 | 用真实迁移工时修正全面切换的排期和预算 |
验收时建议设几条一票否决线,避免被局部成功带着走:带探针情况下 DUT 频率低到软件团队无法接受(如启动以小时计);替换库关键缺口原厂承诺的交付时间晚于项目冻结点;跨片调试基本不可用导致每次定位都要回旧平台;工具崩溃频率使每周有效构建次数低于团队需求。命中任何一条,该平台这一代就只配做功能回归和练兵,不进关键路径——这不是否定路线,而是给演进留出正确的时间窗。
九、能力建设视角:把试点变成团队资产
评估国产/第三方平台时,除了"这一代好不好用",还应用三年视角看待它带来的能力沉淀——这往往是比单次采购更重要的产出:
- 原语与替换库资产:为国产 FPGA 建立的原语映射表、替换模型、约束模板(76 篇)在后续每个项目复用,第一次迁移最贵,第二次开始边际成本快速下降;
- 双平台对账方法论:第一批黄金用例、自动比对脚本、平台差异台账(哪些结论两平台一致、哪些受模型影响)沉淀下来,本身就是验证资产,也能用于未来引入任何新平台;
- 人的能力:让两三名工程师完整走过一次平台 bring-up,团队就具备了"不依赖单一厂商现场支持"的独立性,这在供应链紧张时价值极高;
- 对原厂的反向影响力:早期深度用户的需求会进入工具路线图;把替换库缺口、工具缺陷、调试能力诉求以可量化的问题清单持续反馈,比一次性采购谈判更能改变产品;
- 风险对冲价值要记账:在管理层视角,双平台的部分重复投入应明确记为"供应链保险费"而非浪费——它换来的是关键项目不被单一器件/工具断供决定生死(85 篇把这部分风险定价进 TCO)。
反过来也要清醒:能力建设不能成为硬推不成熟平台上关键路径的理由。试点结论不达标就停在备份/练兵角色,等下一代器件和工具成熟再加量,是理性而非失败——平台演进是多年过程,踩准节奏比一次押注重要。
十、信息核查清单:在静态排名之外怎么判断
这个领域变化快、宣传多,做判断时与其找"最新排名",不如向候选方索取并自行核验这几样一手材料:近两代器件的公开规格书与硅产时间线;在与你规模相当的设计上可复现的构建日志(片数、频率、构建时长,而非 PPT 截图);替换库/SerDes IP 的实际交付清单和版本说明;至少两个同行业、可私下联系的参考客户;工具已知问题清单(成熟厂商敢公开,遮掩本身就是信号);现场支持团队的本地规模和升级路径。把这些材料和你自己试点(第八节)得到的数据并排放,静态宣传与工程现实的差距通常一目了然。
十一、常见坑速查
- 看"已支持 XX 亿门"的新闻就上关键项目 → 必须自带设计 benchmark;
- 低估替换库/原语迁移量,以为重综合即可 → 迁移以月计,主烧替换/分区/子卡/调试四层;
- 忽视调试 IP 差距,bring-up 时才发现跨片看不见 → 提前验证深 trace 与交叉触发;
- 断腕式单点切换 → 用代表性子系统双平台并行对账过渡;
- 只比采购价不量化断供风险 → 风险定价进 TCO;
- 把练兵项目选成顶容量极限的硬骨头 → 第一个迁移设计选舒适区。
与系列及现有篇目的链接
- 平台分类与 benchmark 方法:36 商用原型平台版图 HAPS/Protium/第三方能力边界
- 成本与风险定价:44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本
- 迁移四层机制:11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY、12 多 FPGA 分区算法 割集/容量/图划分、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频、39 商用原型调试 IP 深跟踪/动态探针/可见性预算
- 接口与软件影响:33 PCIe/SerDes 上原型 硬核/降速子卡/LTSSM、34 以太网/USB/MIPI 外设接入 子卡生态/等时实时性、35 多 FPGA IO 引出与引脚规划 连接器/电平/SI/取舍、42 降频原型架构性能评估 cycle 计数/A-B/伪延迟扣除
总结
一句话总结:国产与自研原型生态有四种形态——国产大容量 FPGA 加原厂整机方案(供货自主、风险在 EDA 工具链成熟度和高端器件良率)、第三方多 FPGA 板商配自研或合作 Compiler(板用主流器件规避器件风险、差异化在互联和分区工具)、超大规模厂完全自研板加自建/开源 Compiler(成本极高需专门平台团队)、以及当前风险最可控的双平台并行(成熟生态主力保工期、国产平台承接非关键任务并练兵、逐步加量);评估时不要信静态排名和"支持多少亿门"的新闻,而用 77 篇同一把尺子逐项实测——有效容量(国产器件常低一档、需更多片从而放大割边与 TDM 压力)、可达速度(综合优化与时序收敛差距直接变成更低 DUT 频率)、编译周转(分区自动化弱、手工干预多)、调试可见性(深 trace/动态探针/跨片触发往往是最大短板)、接口生态(子卡不全可部分借第三方补齐),外加两个隐形维度即针对不同原语体系基本要重建的替换/IP 模型库(迁移最大隐性工作量)和 PCIe/DDR/以太网硬核 SerDes 的完备度(高速接口常比裸容量先到瓶颈);现在就适合走这条路线的是规模在器件舒适区、以功能固件软件为主、能用前置仿真补足深可见性、有平台自研力且供应链自主是硬约束的项目,而顶容量极限、工期紧、首做该类芯片、强依赖成熟深 trace 和现成高速子卡的项目仍应让成熟生态担主力;迁移不是重新综合而是一次以月计的平台重新 bring-up,网表几乎不用改,时间主要烧在原语替换库、分区互联、接口子卡、调试 IP 四层(约束 XDC、时钟复位 harness、构建/版本/农场自动化、软件 BSP 超时校准也要重做),降低风险要选一个含高速接口和典型时钟结构的非关键代表子系统先迁、用同一 RTL 和软件镜像在两平台跑同一批黄金用例对账(结果不一致先怀疑替换模型与平台)、关键路径留成熟平台国产侧先承接功能回归和培训、把原厂替换库补齐和工具缺陷修复时限写进合同;最后供应链自主的价值是"关键项目不被断供"的风险定价,要连同出口管制、供货连续性、license 与数据流转合规一起进入 TCO,而不是只比采购价。