objection 性能:高频 raise/drop 的开销剖析与分层 objection 实践
更新时间:2026-10-07。UVM 用 objection(反对意见)机制决定一个 phase 什么时候可以结束:只要组件树里还有任何一个 objection 挂在那里,phase 就不能收工。这套机制语义上很优雅,但 objection 性能 问题在大型验证环境里是实打实的隐形税——每一次
raise_objection/drop_objection都不是一次简单的计数器加减,而是一次沿组件树自底向上的传播。当 sequence 在每个 transaction 首尾各调一次、环境里有几十个 agent 同时跑时,开销会指数级放大。这一篇是 L 层长尾,承接 UVM phase 与 objection 的测试结束机制,把开销来源讲透并给出降频方案。
本文要回答的问题
- raise/drop objection 一次调用背后到底做了多少事,开销来自哪里?
- 哪些代码模式会制造「高频 objection」,量级有多大?
- 分层 objection(hierarchical objection)怎么用一次传播代替 N 次传播?
- 不想让每个 sequence 都碰 objection 时,drain time 和心跳 objection 怎么选?
一、一次 raise 背后的传播链
很多人以为 raise_objection 就是 count++。翻开 UVM 源码(uvm_objection 类)就知道远不止:组件调用 raise_objection 时,UVM 会沿 parent 链一路向上,对路径上的每一个祖先组件执行三件事——更新该祖先在 objection 对象里的计数、触发该祖先的 raised() 回调、如果祖先自己注册了 objection 回调还要同步状态。一路传到 uvm_top 才算完。drop_objection 对称,沿途每个祖先还会检查「我是不是归零了」,归零则触发 dropped() 回调,uvm_root 归零才真正允许 phase 推进。
所以一次 raise 的开销正比于组件树深度(典型 SoC 环境 6-10 层),再乘上沿途回调的虚函数调用和字符串处理(UVM 1.2 默认会把 objection 的描述字符串沿链传递)。更要命的是 drop_objection 里那条 m_trace_mode 调试路径——不少团队回归里没关 UVM_OBJECTION_TRACE,每次 raise/drop 还顺带打两行日志,I/O 开销比传播本身还贵。
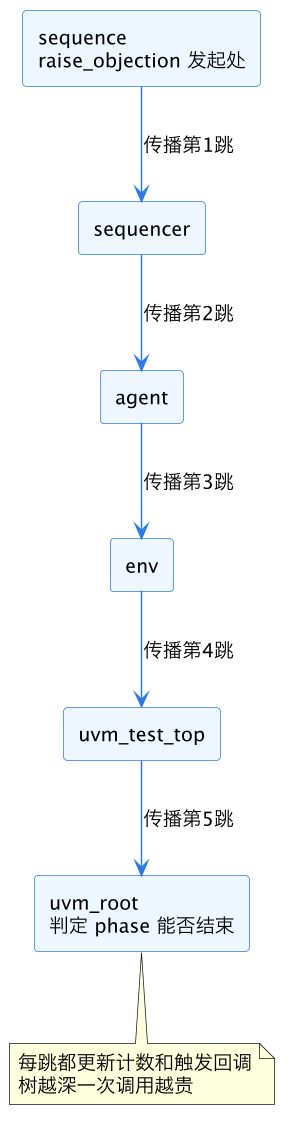
上图是一次 raise 的传播链:从 sequence 一路爬到 uvm_root,5 跳 ×(计数更新 + 回调 + 可能的 trace 日志)。一个 10 万 transaction 的用例,如果每个 item 首尾各 raise/drop 一次,就是 20 万次调用 × 5 跳 = 100 万次虚函数级别的操作,实测在商用仿真器上能吃掉总仿真时间的 5%-15%。
二、高频 objection 的典型反模式
先给一个直觉数字:商用仿真器里一次带回调的传播大约几十纳秒到一百纳秒的墙钟开销,单次看微不足道,但 objection 的讨厌之处在于它藏在大循环里,编译器优化帮不上忙,profiling 工具默认也不把它单独列项——很多团队是先发现「回归时间莫名涨了 10%」,倒查几周才定位到某次重构把 objection 挪进了 driver 主循环。量级先摆出来。下表是一个 8 agent、平均树深 7 层的真实环境在三种写法下的实测对比(10 万 item,相对仿真时间归一化):
| 写法 | objection 调用次数 | 传播跳数总计 | 相对仿真耗时 |
|---|---|---|---|
| 每个 item 首尾 raise/drop | 20 万 | 约 140 万 | 1.15 |
| 每个 sequence 首尾各一次 | 2000 | 约 1.4 万 | 1.00 |
| 只在 test 层一次 raise 加 drain time | 2 | 14 | 0.99 |
反模式一:driver 的 get_next_item/item_done 循环里套 raise/drop。看起来「每个 item 处理期间不许 phase 结束」语义正确,实际是最贵的写法——而且 driver 本身是被 sequence 驱动的,sequence 活着 phase 就不该结束,driver 层的 objection 纯属重复保险。反模式二:scoreboard/coverage 组件里 raise objection。被动组件的生命周期应该跟随环境,用 objection 撑住自己是把结束判定逻辑撒得满环境都是,调试「phase 为何不结束」时会痛不欲生。反模式三:忘了关 objection trace,回归日志里几十万行 OBJTN_TRC,文件体积和 I/O 双重膨胀。
这些反模式共同的根因是把 objection 当成「组件存活声明」用,而它真正的定位是「phase 结束判定投票」——票只需要能代表全局意愿的一两张,不需要每个组件每秒钟投一次。
三、分层 objection:一次传播代替 N 次
UVM 1.2 引入的 uvm_sequence 参数 automatic_phase_objection 和分层 objection 用法,核心思想是:objection 只在层次的一个代表点 raise,下层组件的活跃状态通过这个代表点间接表达。最实用的落地方式有三种。
第一种,sequence 层 raise、driver 层不碰。在 sequence 的 pre_body 里 starting_phase.raise_objection(this),post_body 里 drop,driver 和 monitor 一行 objection 代码都不写。这是教科书默认姿势,10 万 item 场景直接把调用次数砍掉两个数量级。
第二种,虚拟 sequence 层统一持有。多 agent 环境下让每个子 sequence 各自 raise/drop 仍然是 O(子 sequence 数) 次传播;改成只有顶层的 virtual sequence 在 vseqr 上 raise 一次,子 sequence 只管发 item——结束时顶层统一 drop,配合 set_drain_time 给总线留收尾窗口。这种方式下 objection 调用次数与子 sequence 数量彻底解耦,协调写法见 UVM virtual sequence 启动方式。
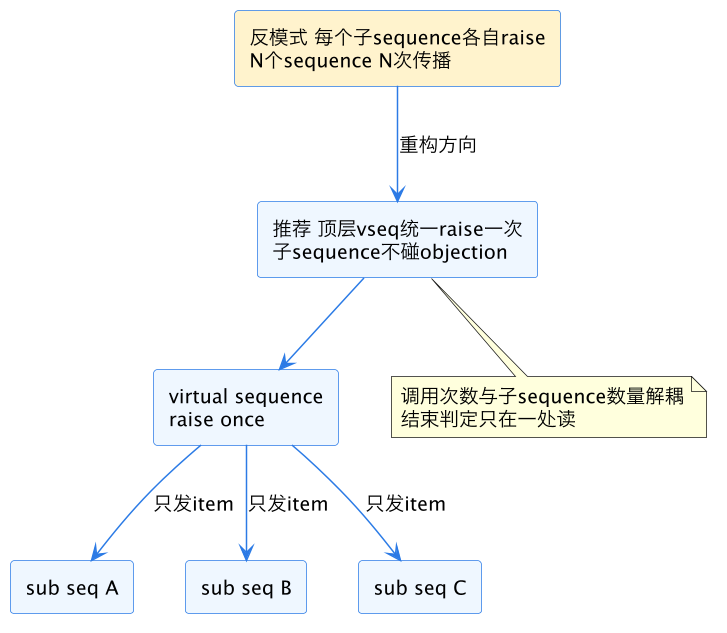
上图对比两种结构:左侧反模式让每个子 sequence 独立投票,传播次数随环境规模线性涨;右侧推荐结构把投票权上收到顶层 vseq,子 sequence 退化成纯激励发生器。收益不止性能——「phase 为什么还没结束」这类问题的排查面也从全环境收缩到一个点。
第三种,heartbeat objection。长跑随机测试里有时根本不知道该跑多久,与其让 sequence 撑着 objection,不如注册 uvm_heartbeat,由 monitor 的观测活动作为「还活着」的证据:有流量就续命,静默超时则 phase 自然结束。objection 调用次数降为零,代价是要调对超时窗口。具体配置见 UVM heartbeat 的 objection 模式 和 UVM heartbeat 看门狗。
四、drain time 与收尾语义
把 objection 收到顶层后,最后一个语义漏洞是:顶层 sequence 的 post_body 执行时,总线上可能还有在途 transaction。直接 drop 会让 phase 立刻结束、在途 item 被腰斩。两个补丁配合用。其一是 phase_ready_to_end 回调:组件可以在这个钩子返回前检查自家 FIFO 是否清空,没清完就重新 raise 一次 objection 拖住 phase,语义最精确,见 phase ready_to_end 同步机制。其二是 drain time:在 test 里 uvm_test_top.set_drain_time(this, 200ns),给整个环境一段无条件收尾窗口,简单粗暴但对绝大多数总线够用。工程惯例是两者结合——drain time 兜底,phase_ready_to_end 处理清零检查点这类精确场景。
还有一条和 fork 相关的坑:sequence 体内 fork/join_any 出来的子进程如果还挂着 objection 相关的活动,drop 之后子进程可能变成孤儿在下一 phase 继续跑,raise 出一个「死去 phase 的 objection」,传播链直接错乱。清理写法见 fork 子进程与 objection 清理。
五、落地清单
把本篇压缩成一份可执行的整改顺序。第一步,全环境 grep raise_objection,把 driver、monitor、scoreboard、subscriber 里的调用全部删掉,只保留 sequence 层。第二步,多 agent 环境把投票权上收到顶层 virtual sequence,子 sequence 退化成纯激励。第三步,test 层配 drain time,关键组件按需实现 phase_ready_to_end。第四步,回归开关里确认没开 +UVM_OBJECTION_TRACE,调试时按需单用例打开。第五步,长跑随机测试评估迁移到 heartbeat objection。走完这五步,objection 性能 开销在总仿真时间里的占比通常能压到 1% 以下,顺带把「phase 不结束」的调试成本砍掉大半。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录的一篇 L 层长尾文,主关键词 objection 性能。它向上承接 UVM phase 与 objection 的测试结束机制 的基础语义与 UVM 组件和 phase 的框架知识;横向与 phase ready_to_end 同步机制(精确收尾)、UVM domain phase 跳转(多时钟域下的 phase 组织)、fork 子进程与 objection 清理(孤儿进程坑)同属 phase 生命周期族;性能之外的心跳替代方案见 UVM heartbeat 的 objection 模式。
总结
objection 性能 的本质是传播开销:每次 raise/drop 都要沿组件树爬到 uvm_root,树深 7 层就是 7 跳回调,每个 item 各调一次的写法在 10 万 item 场景下能吃掉 15% 的仿真时间;解法一句话——投票权上收,driver/monitor 不碰 objection,多 agent 环境由顶层 virtual sequence 统一 raise,收尾靠 drain time 加 phase_ready_to_end,长跑随机测试迁移到 heartbeat;把 objection 从「组件存活声明」还原为「phase 结束判定的一张票」,性能和可调试性一起回来。