FPGA 千兆收发器概念:GTP/GTX/GTH 这些 MGT 能做什么、不能做什么
FPGA 数据手册里那一长串 GTP、GTX、GTH、GTY,新手通常分不清:它们是同一种东西的速率档名字,工程上统称 MGT(Multi-Gigabit Transceiver,多吉比特收发器),简称 GT。本篇只讲 FPGA 千兆收发器概念——片内黑盒里到底有哪些模块、物理上怎么组织、边界在哪里。高速接口的全景浏览见 高速接口总览,动手例化看 高速收发器使用入门,深水区见 收发器 PMA/PCS 与链路裕量。
本文要回答的问题
- 普通差分 IO 也能跑不慢,为什么到了几 Gbps 就非得用专门的收发器硬核?
- GTP/GTX/GTH/GTY 这些名字是什么关系?选型时怎么理解它们的高低档?
- 一条 lane 从用户逻辑的并行字节到引脚上的串行差分比特,中间依次经过哪些片内模块?PMA 和 PCS 各管什么?
- 没有随路时钟,接收端凭什么知道每一位在什么时候采样?参考时钟 MGTREFCLK 又起什么作用?
- 例化了收发器,是不是就「有了 PCIe、SATA」?什么情况下普通 IO 上的 LVDS SerDes 反而更合适?
先用一张概念卡给出全篇骨架:收发器硬核内部做什么、物理上怎么摆、什么事情明确不归它管。
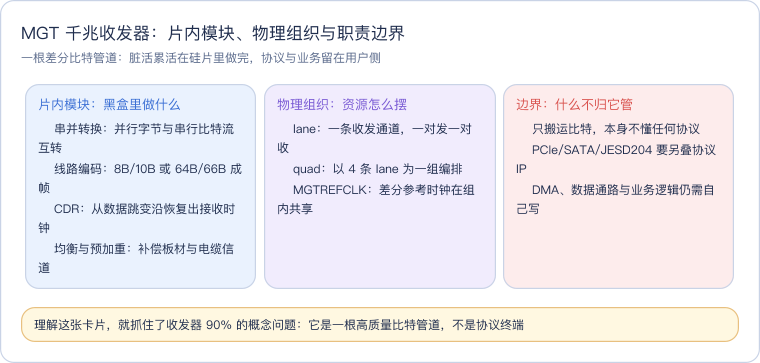
读这张卡片抓住三块:蓝色是「硅片替你做的脏活」,紫色是「这些资源在芯片上的几何组织」,红色是最容易产生错觉的边界——后面所有章节都是在展开这三行。
一、不要会怎样:源同步并行总线撞上三堵墙
要理解 FPGA 千兆收发器概念,先看不用它时的世界。速率在每秒几十到几百兆比特量级时,普通 IO 配 LVDS 电平就够用:数据走若干对差分线,时钟作为一根额外的信号随数据一起发过去,接收端用这路「随路时钟」采样,这就是源同步接口,FPGA 里靠 ISERDES/OSERDES 串并转换单元加延迟校准实现(机制见 LVDS 源同步接口)。
但速率继续往上抬,这套做法连续撞上三堵墙:
第一堵:随路时钟与数据的偏斜(skew)无法再控。 8 位数据加 1 位时钟在 PCB 上即便做等长,各 bit 经过的连接器、过孔、封装路径仍有皮秒级差异。位周期宽到一两百皮秒时,几皮秒偏斜无所谓;位周期缩到几十皮秒,偏斜占掉半个位周期,接收触发器必然踩到边沿。
第二堵:时钟本身比数据还难传。 全速随路时钟在背板和电缆上辐射强、占一对宝贵线,且多条 lane 各跑各的时钟无法对齐。高速串行链路普遍要求「嵌入式时钟」——时钟信息藏在数据流里,线上只有一对差分信号。
第三堵:信道开始「涂抹」比特。 几 Gbps 信号经过板材、连接器、电缆后高频分量衰减,相邻比特互相拖尾(码间干扰),接收端眼睛闭合,这不是约束约束时序就能解决的,必须在模拟域做补偿。
MGT 就是为一次翻过这三堵墙而生的专用硬核:它不用随路时钟(CDR 恢复)、单线串行化(省线、省连接器)、内置模拟均衡与发送预加重(对抗信道)。可以说,普通 IO 上的 LVDS 接口是「数字逻辑 + 小心约束」,MGT 是「一块完整的模拟/混合信号子系统」。
二、GTP/GTX/GTH/GTY 是什么:同一种硬核的速率档
Xilinx/AMD 的命名规律是:同一代工艺下,按器件定位从低到高搭配不同速率档的收发器,速率上限依次抬高:
| 名称 | 典型出现位置 | 定位口径 |
|---|---|---|
| GTP | 低成本系列(如 Artix 档器件) | 同代里速率档最低,满足入门级串行链路 |
| GTX | 中端系列(如 Kintex 档器件) | 速率档居中,性价比最常见 |
| GTH | 高端系列(如 Virtex 档及 UltraScale 部分器件) | 同代里速率档更高 |
| GTY 等 | UltraScale+ 及更新代际 | 更高速率档,面向超高速链路 |
理解这张表只记三点:一是它们架构同族,PMA/PCS 分层、lane/quad 组织、配置接口的概念完全通用,学会一个档再换另一个没有知识断层;二是它们是高低档关系不是种类关系,具体某型号有没有收发器、每 lane 线速率支持到多少,必须查该型号数据手册,不要背具体 Gbps 数字跨系列套用;三是 Intel/Altera 器件里对应物就叫高速收发器(Transceiver,集成在带 GX 后缀的器件中),叫法不同,概念对等。
选型阶段还有一个更硬的事实:收发器数量是定价维度。同系列不同型号的 lane 数差异直接影响价格与封装,引脚也是专用的,不能和普通 IO 互换(专用引脚、独立 bank 与独立模拟电源,供电口径见 FPGA 供电与散热)。板子原理图阶段就必须把 lane 引脚、参考时钟脚规划死,事后没法改。
三、一条 lane 的内部:PMA 与 PCS 分工
收发器内部按功能分两层:**PMA(Physical Media Attachment,物理媒介附着层)**是纯模拟/混合信号部分,贴着引脚;**PCS(Physical Coding Sublayer,物理编码子层)**是数字逻辑部分,贴着用户侧并行总线。先看发送方向(TX)。
读图先抓分层:蓝色节点在 PCS 一侧,处理的是字节、编码这类「数字语义」;橙色节点在 PMA 一侧,处理的是电压、边沿、信道这类「模拟物理」。并行字节在 PCS 编码后进入 PMA,装载进串行器,按线速率的节拍逐位移出发送。
接收方向(RX)是逆过程,但难度完全不同——发送端节奏由自己掌握,接收端却要先「猜」出对方的节拍。
红色节点是整条接收链路的命门:CDR(Clock Data Recovery,时钟数据恢复)。它用片上锁相环跟踪输入比特流的跳变沿,在本地「长」出一个与发送端同频同相的采样时钟,从此不再需要板上那根随路时钟。但 CDR 能锁定的前提是数据里有足够密集的跳变——长时间的全 0 或全 1 会让它失去参照而漂移。这正是线路编码存在的理由。各模块的职责汇总如下。
| 模块 | 所在层 | 解决的问题 |
|---|---|---|
| 串行器 / 解串器 | PMA | 并行字节与高速串行比特流互转 |
| 发送驱动(预加重/去加重) | PMA | 提前抬高高频分量,对抗信道低通衰减 |
| 接收均衡(CTLE/DFE) | PMA | 在接收端把被拖尾糊住的眼图重新撑开 |
| CDR | PMA | 从数据跳变恢复采样时钟,省掉随路时钟 |
| 8B/10B 编解码 | PCS | 直流平衡、保证跳变密度、自带逗号对齐字符 |
| 64B/66B 成帧与加扰 | PCS | 仅约 3% 编码开销,靠加扰维持跳变密度 |
| 字对齐 / 逗号检测 | PCS | 在连续比特流中找到字节边界 |
| 通道绑定、时钟修正(弹性缓冲) | PCS | 多 lane 对齐、吸收两端恢复时钟频差 |
8B/10B 与 64B/66B 是两代编码哲学:前者每 8 位编成 10 位,开销 20%,但保证直流平衡(线上长期 0 和 1 数量相等,接收端电路不至于偏压)且提供 K28.5 这类「逗号字符」做字节边界;后者每 64 位加 2 位同步头,开销约 3%,同步头之外的数据做加扰以维持跳变密度,效率高但机制更复杂。PCIe 前两代、千兆以太网、SATA、JESD204B 用 8B/10B;万兆以太网、PCIe 第三代及以后、JESD204C 用 64B/66B 一类成块编码。
四、串化节拍与参考时钟:看不见的两个时钟
先看并串转换的节拍关系。下图示意发送端:并行字节在低速用户时钟边沿被一次性装载,随后串行器按高速节拍把 8 个位依次推上线。
读这张波形:并行侧一个时钟周期对应串行侧 8 个比特位周期(示意 8 位宽度,实际编码后是 10 位一组)。并行域时钟慢、串行域时钟快,两者都从同一个片上锁相环分频而来,因此相位严格同源——这是 MGT 内部时钟结构的核心。
接收端没有随路钟,CDR 凭数据沿恢复时钟,但 CDR 自己也需要一个频率基准去判断「对方大概跑在多快」,这就是参考时钟 MGTREFCLK 的角色:它不直接采样数据,只给锁相环一个高精度频率锚点,CDR 在这个锚点附近做小范围相位跟踪。参考时钟通常由板上低抖动晶振经专用差分脚(MGTREFCLK0/1 一类引脚)和 IBUFDS_GTE 一类专用差分缓冲进入收发器,不能从普通 IO 或 FPGA 内部全局时钟反送——普通布线抖动太大,会直接劣化发送相噪和 CDR 跟踪。它与 PLL/MMCM 时钟向导里的普通时钟资源是两套相互独立的设施。
读这张图抓住「共享」二字:以 7 系列常见组织为例,收发器以 quad 为单位编排,一个 quad 含 4 条 lane(一条 lane = 一对发送差分 + 一对接收差分),组内有锁相环和专用参考时钟输入,同一参考时钟可服务组内各 lane;相邻 quad 之间也允许经专用布线互借参考时钟。线速率就是参考时钟经锁相环倍频、再配合 PCS 位宽分频算出的——所以改线速率本质是改 Wizard 里的时钟参数,不是改引脚。不同代际(UltraScale 起)的 bank/quad 编排和时钟路由规则有调整,具体路由可能性以对应系列收发器用户指南为准。
复位也因此比普通模块复杂:要先保证参考时钟稳定,再等锁相环锁定、CDR 锁定、字对齐完成,恢复出的用户时钟稳定后,用户逻辑才被允许收发数据。这套握序由收发器 IP 的复位控制器封装成一组状态信号输出,设计时按 FPGA 时钟与复位的异步断言、同步释放原则接住即可,裸写复位状态机是新手常见坑。
五、协议映射:收发器给比特,协议靠 IP
初学者最大的错觉是「FPGA 有 GTH,所以支持 PCIe」。准确的说法是:收发器提供跑 PCIe 物理层所需的电气与编解码能力,但 PCIe 协议本身是跑在它上面的另一层数字逻辑。 常见协议与收发器的分工如下。
| 协议/用途 | 典型线路编码 | 收发器提供 | 还需要补什么 |
|---|---|---|---|
| PCIe | 8B/10B(早期代)、128B/130B(第三代起) | 物理层比特管道 | PCIe 核(链路状态机、事务层)+ DMA/数据通路 |
| SATA | 8B/10B | 物理层比特管道 | SATA 协议层 IP,FPGA 侧多为自研/第三方 |
| 千兆/万兆以太网 | 8B/10B、64B/66B | 物理层比特管道 | MAC 与协议栈(入门见 千兆以太网 RGMII) |
| JESD204B/C | 8B/10B / 64B/66B | 物理层比特管道 | 子类同步、确定性延迟对齐逻辑,对接 ADC/DAC |
| Aurora | 8B/10B 或 64B/66B | 物理层比特管道 | Xilinx 轻量链路层 IP(见 Aurora 与高速串行协议) |
| 串行数字视频(SDI)等 | 对应标准编码 | 物理层比特管道 | 成帧、加解扰与行场处理逻辑 |
以 PCIe 为例最能说明「能做什么、不能做什么」:FPGA 做 PCIe 端点时,Xilinx 提供集成块加 PCIe IP,把 LTSSM 链路训练、TLP 打包这类协议脏活封掉,但 IP 出来只是一组 AXI 流接口;主机内存与 FPGA 片内缓冲之间的 DMA 搬运、描述符管理、中断,仍要靠 XDMA 一类 IP 配合你自己的数据通路完成(整条通路见 PCIe XDMA 入门)。JESD204 同理:收发器保证比特不错,但多片 ADC 的同步建立(SYSREF、子类 1 确定性延迟)是你要写的逻辑。低速 ADC 采样不涉及这一层,普通 SPI 接口就够(SPI 读取 ADC 入门)。
工程上这些都不是从寄存器裸写,而是在 Vivado IP Catalog 调 IP:Transceiver Wizard 配裸 lane,PCIe/JESD204/以太网各有专用 IP。收发器概念属于 常用 IP 核里最复杂的一族。
六、什么时候上 MGT,什么时候 LVDS 就够
两者都能做「串行收发」,但成本和适用区间差别很大。
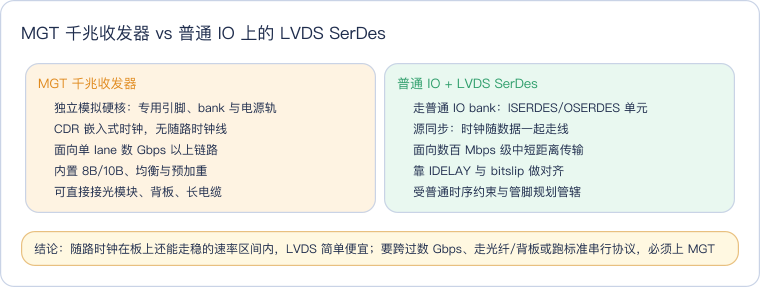
这张对照卡的决策含义可以压成三问:一问介质——要接 SFP 光模块、背板连接器或米级电缆,只能 MGT;板内或板间几厘米到十几厘米、芯片到芯片,LVDS 常常够。二问协议——对端是 PCIe、SATA、JESD204、万兆以太网这类标准串行口,MGT 是门票;Camera Link、并行 ADC、自定义源同步总线,LVDS 加 ISERDES 更直接。三问成本——MGT 占专用硬核、独立模拟电源(MGTAVCC/MGTAVTT 等独立轨)和高价引脚,低端器件 lane 数极少甚至没有;能用 LVDS 解决的场景不必为用不完的速率买单。IO bank 电平与管脚规划本身的约束见 FPGA IO bank 与 VCCO。
七、常见疑问与误区
| 疑问 | 概念性回答 |
|---|---|
| 例化收发器后就「有了 PCIe」吗? | 没有。你得到的是可配成 PCIe 线速率的比特管道,协议状态机、TLP、DMA 都要另加 |
| 没用完的 MGT 引脚能当普通差分 IO 吗? | 不能。专用引脚、专用 bank 与独立电源,选器件和画原理图时就要定死用途 |
| MGTREFCLK 能不能从 FPGA 内部时钟分频供给? | 不能。要低抖动外部源经专用差分脚和专用缓冲进入,内部时钟抖动不满足锁相环要求 |
| 8B/10B 和 64B/66B 选哪个更好? | 没有好坏,只有协议规定与开销取舍:前者开销 20% 但对齐机制简单,后者开销约 3% 但需加扰和成块同步 |
| 链路显示 up 却偶发误码,是逻辑问题吗? | 多数是信道裕量问题:参考时钟抖动、电源噪声、均衡参数、板材损耗,排查方法见 收发器信号完整性 |
| 复位为什么要等一串状态,不能一上来就发数据? | 参考时钟、锁相环、CDR、字对齐、恢复用户时钟有先后依赖,任一未就绪时发出的数据都是垃圾 |
这一篇在知识体系里的位置
本篇是 FPGA 高速接口簇的概念入口:横向的全景图(LVDS/DDR/PCIe/以太网/Aurora 一盘棋)是 高速接口总览;往下动手,配置 Wizard、例化裸 lane、跑通 Aurora 看 高速收发器使用入门;对照学习源同步一侧的 ISERDES/IDELAY/bitslip 看 LVDS 源同步接口。深水区三条支线:模拟机理、抖动分解、PAM4 演进在 收发器 PMA/PCS 与链路裕量,眼图与均衡预算在 收发器信号完整性,协议落地分别接 PCIe XDMA、千兆以太网 RGMII 与 Aurora 与高速串行协议。周边基础:时钟设施见 PLL/MMCM 时钟向导与 时钟与复位,独立电源轨见 供电与散热,IP 调用方法见 IP 核怎么调。
总结
FPGA 千兆收发器概念可以收成一句话:GTP/GTX/GTH/GTY 是同一种 MGT 硬核的速率档名字,PMA 层用串行器、CDR、发送预加重与接收均衡把「并行字节在无时钟线上高速传输」这件模拟脏活在硅片里做完,PCS 层用 8B/10B 或 64B/66B、字对齐和弹性缓冲解决成帧与同步;物理上以 lane 为通道、quad 为四通道分组,靠 MGTREFCLK 专用差分参考时钟提供频率锚点。它的边界同样清晰:只给比特管道,PCIe、SATA、JESD204 等协议必须另叠 IP,DMA 与业务逻辑仍要自己写;速率停留在源同步能驾驭的区间时,普通 IO 加 LVDS SerDes 是更省的选择。