推理服务自动扩缩容:为什么 GPU 的 HPA 不能只看 CPU 利用率
更新时间:2026-10-04。前面 serving 容量规划 讲的是「稳态下该备多少卡」——按流量模型和 SLO 算出副本数的基线;LLM serving 的 TTFT/TPOT 与 SLO 讲的是「用户感受到的延迟由哪几段组成」。这两篇都假设副本数是提前定好的。但真实流量不是平的:早晚高峰、突发热点、定时批任务,基线容量按峰值配就烧钱,按均值配就翻车。推理服务自动扩缩容要解决的正是这件事:让副本数跟着流量走。问题是,Kubernetes 原生 HPA 默认按 CPU 利用率伸缩,而 LLM serving 的瓶颈几乎不在 CPU 上——照抄 Web 服务那套,扩容永远慢半拍,缩容又缩得太狠。本篇讲清该盯哪些 GPU 侧指标、指标背后的负载语义、以及工程上怎么把这套 HPA 搭起来。
本文要回答的问题
- 为什么 CPU 利用率和 GPU 利用率都不是 LLM serving 的好扩缩容信号?
- 队列深度、KV cache 使用率、TTFT 这三个指标各自刻画什么,怎么选?
- 指标从哪采、聚合窗口取多大,才能既不抖动又不迟钝?
- GPU 副本冷启动要几分钟,扩容延迟怎么消化?
- 缩容为什么不能对称地做,要加哪些保护?
一、CPU 利用率为什么失灵:serving 的负载拐点在显存和队列里
先想 Web 服务的 HPA 为什么有效:CPU 利用率和请求处理速率强相关,利用率到 70% 意味着再加流量就要排队,于是扩容。这个「利用率—排队」的单调关系是整条链路的根基。
LLM serving 把这条链打断了。一个 vLLM 副本上,真正的请求处理由 GPU 完成,CPU 只做 tokenization、调度和网络收发,负载很轻——GPU 已经满到 P99 延迟超标时,CPU 利用率可能只有 15%。反过来,CPU 利用率高(比如来了一批超长 prompt 要 tokenize)也不代表 GPU 需要更多副本。用 CPU 指标做推理服务自动扩缩容,等于拿体温计量血压。
那直接看 GPU 利用率行不行?也不行,原因有两个。其一,continuous batching(连续批处理,机制见 continuous batching 调度器)下 decode 是逐轮推进的,只要 batch 里有请求在跑,GPU kernel 就一直在发射,utilization 这类采样指标长期贴着 90% 以上,但它分辨不出「batch 里 8 个请求还很空」和「batch 里 128 个请求已经到拐点」的区别——后者从 batch 延迟吞吐曲线 上看已经进了延迟陡增区,前者再加一倍流量都没事。其二,GPU 的「忙」不等于「产出」:显存带宽打满、SM 空转等 KV cache 读的情况,利用率读数照样漂亮。
结论:推理服务自动扩缩容的信号必须来自调度器和显存层面,那里有真实的排队信息。
二、三个靠谱指标:队列深度、KV cache 使用率、TTFT
社区实践(vLLM、TGI、以及各云厂商的 GPU HPA 方案)收敛到三个候选指标,语义各不相同。
队列深度(waiting queue length):调度器里已到达但还没被调进 running batch 的请求数。这是最直接的压力信号——队列不为零,说明当前副本集合的吞吐已经追不上到达速率,排队长度还在涨就是在欠账。它的优点是灵敏,缺点是没有「归一化」:队列长 5 对高 QPS 服务是小波动,对低 QPS 服务已经是大事故,所以通常要配「队列等待时长」一起看。
KV cache 使用率(KV cache utilization):当前已分配的 KV cache block 占总可分配的比例。vLLM 的 PagedAttention(见 PagedAttention 与 vLLM serving)把显存切成 block 池,这个比例就是副本的「座位占用率」。它的妙处是归一化且直接对应拐点:使用率逼近 90%,调度器就要开始抢占或拒绝新请求,延迟随即恶化——这正是 KV cache 推理显存 里讲的水位管理在扩缩容上的投影。缺点是它反映「存量」不反映「增量」:一堆长上下文请求挂机不动也把水位顶得很高,但此时到达速率可能并不高。
TTFT(time to first token,首 token 延迟):用户直接感知的指标,里面天然包含了排队时间。用 TTFT 的滑动分位数(比如 P90)做信号,等于「以结果为导向」——SLO 是什么就盯什么。缺点是它是滞后指标,等 TTFT 恶化再扩,用户已经挨了几分钟的差体验;而且 TTFT 受 prompt 长度分布漂移影响,噪声大。
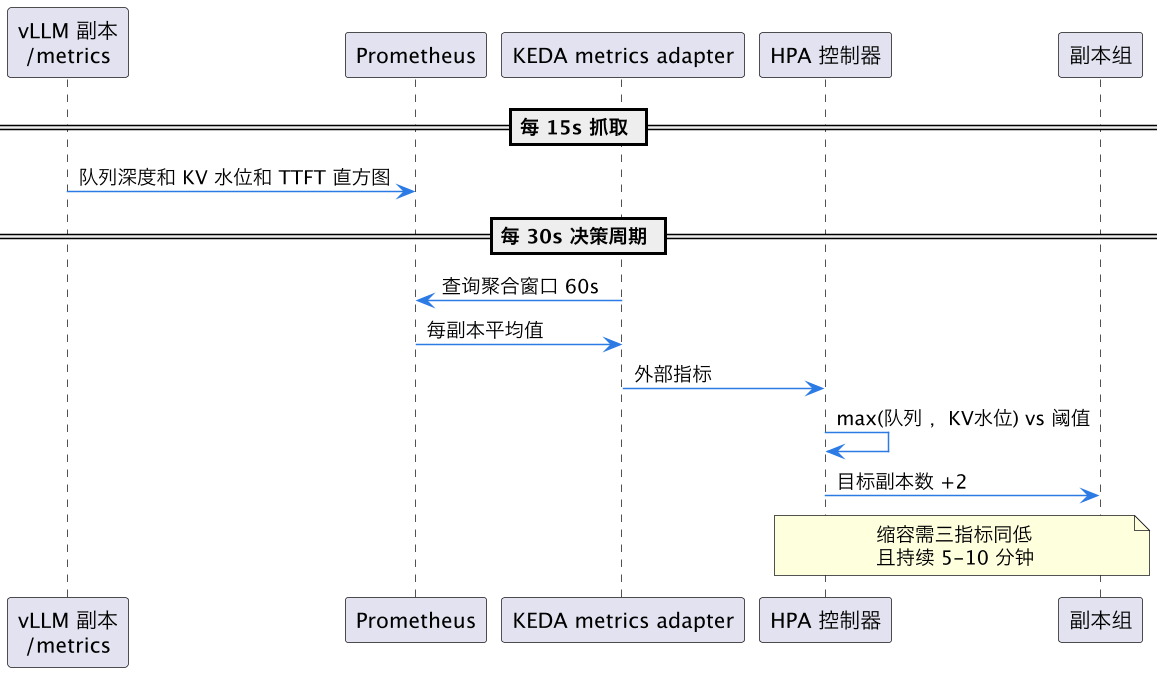
上图把三个指标的位置画在请求路径上,能看清它们的「时间差」:队列深度在请求入口处,是最领先的信号;KV 水位在运行中,是当前压力的实态;TTFT 在链路末端,是结果的确认。务实的做法是多指标融合:扩容器按 max(队列深度归一值, KV 水位) 触发——任一指标越线说明压力真实存在;缩容则要求三个指标同时处于低位且持续一段时间,TTFT 在这里扮演「防误缩」的否决票。
| 指标 | 语义 | 领先/滞后 | 优点 | 缺点 |
|---|---|---|---|---|
| 队列深度 | 入口积压 | 领先 | 灵敏、直接对应欠账 | 不归一化,需配等待时长 |
| KV cache 使用率 | 显存水位 | 实态 | 归一化、贴近调度拐点 | 长会话挂机会虚高 |
| TTFT P90 | 用户体验 | 滞后 | 直接对齐 SLO | 噪声大、反应慢 |
三、指标的采集与聚合:窗口小了抖,窗口大了钝
指标选定后,工程细节决定这套 HPA 是帮手还是震荡源。
采集侧,三个指标都要从 serving 框架内部暴露,而不是从外部黑盒探。vLLM 原生在 /metrics 端点吐 Prometheus 格式:vllm:num_requests_waiting(队列深度)、vllm:gpu_cache_usage_perc(KV 水位),TTFT 有 vllm:time_to_first_token_seconds 直方图。接法是把副本级指标按 deployment 聚合后喂给 KEDA 或自定义 metrics adapter,让 HPA 看到一个「每副本平均」的数。完整的指标栈搭建可参考 LLM 推理可观测性体系。
聚合窗口是经典的控制论权衡:窗口取 15 秒,毛刺流量(一波秒杀开场 30 秒)就会触发一轮无谓扩容,GPU 副本刚拉起来流量已经退了;窗口取 5 分钟,真实高峰的爬坡段全在窗口里被平均掉,等触发时队列已经欠了一屁股账。经验值是扩容窗口 30~60 秒、缩容窗口 5~10 分钟,且扩缩不对称——扩要激进,缩要保守,因为扩晚了的代价(SLO 违约、用户流失)远大于多开几副本几分钟的代价(一点电费)。
四、扩容延迟:GPU 副本不是秒起的
Web 服务的 Pod 几秒就绪,HPA 的「扩了马上有用」假设在 GPU 世界不成立。一个 LLM 推理副本从创建到能接流量,要过四道坎:节点调度(集群里未必有空闲 GPU,涉及 cluster autoscaler 加节点,分钟级)、镜像拉取(serving 镜像动辄 20GB+)、权重加载(70B 模型的分片从对象存储或本地盘读进显存,几十秒到几分钟)、以及 CUDA graph 捕获和预热(vLLM 的 warmup 前向,几十秒)。全链路冷启动 3~10 分钟是常态,而 TTL 级别的流量尖峰可能总共就 5 分钟——等扩容到位,尖峰已经过了。
对策分三层。第一层是缩短冷启动:权重预热到节点本地盘、镜像预拉取、用检查点格式的权重做并行加载,能把冷启动压进 1~2 分钟。第二层是预测式扩容:流量有明显日周期规律的业务,按历史曲线在高峰前 15 分钟先把副本拉起来(定时 HPA 或 cron 式 scaler),让反应式 HPA 只处理预测之外的偏差。第三层是削峰兜底:扩容没到位的窗口期,入口网关做排队和降级——超短 SLO 的请求优先、低优先级流量返回「稍后重试」,别把压力原样灌进已经饱和的副本。入口侧的全局调度可结合 LLM 路由与负载均衡 一起看,路由层本身就有按副本负载分流的逻辑。
五、缩容的保护:别把长会话拦腰砍断
缩容比扩容危险,因为 LLM 请求是长连接、有状态的:一个跑了 20 分钟的长会话,它的 KV cache 全在某一副本的显存里,副本被 HPA 干掉,这个会话就断了——Web 时代「Pod 无状态随便杀」的假设彻底失效。
缩容至少要加四道保护。其一,drain 而非 kill:标记缩容的副本先摘流(路由层不再派新请求),等存量请求自然完成再退出;对超长会话设一个 drain 上限(比如 30 分钟),到期强制终止并通知客户端重试。其二,慢步进:每次只缩 1 个副本,间隔一个冷却期再评估,禁止「从 20 一步到位缩到 8」。其三,低谷窗口:把激进缩容限制在流量低谷时段,白天只小步缩。其四,KV 水位否决:只要集群平均 KV 水位高于某个下限(比如 30%),即使队列是空的也不缩——长会话占着显存,杀掉副本等于主动制造容量缺口。prefill/decode 分离架构(见 disaggregated serving 集群)下两类角色要分别配 HPA,prefill 副本无状态、缩容可以快一些,decode 副本抱着全部会话状态、必须慢。
这一篇在知识体系里的位置
本篇是 serving 运维线的「动态篇」:上游是 serving 容量规划(定基线副本数——HPA 围绕它上下浮动)和 LLM serving 的 TTFT/TPOT 与 SLO(SLO 定义了扩缩容要守住的目标);同层依赖 continuous batching 调度器 和 PagedAttention 与 vLLM serving 暴露的队列与 KV 水位指标,LLM 推理可观测性体系 提供指标管道;配合阅读 LLM 路由与负载均衡(副本间分流)和 vLLM V1 调度器设计(指标产生的机制源头)。
落地顺序建议:先把三个指标的采集链路打通并观察两周,摸清自家流量的指标-SLO 对应关系,再上「只扩不缩」的半自动模式,最后才敢放开对称扩缩——每一步都拿真实流量验证,别直接抄别人的阈值。
总结
推理服务自动扩缩容不能照搬 Web 服务的 CPU 利用率 HPA,因为 LLM serving 的负载拐点藏在调度器和显存里:扩容器应融合队列深度(领先信号)、KV cache 使用率(归一化水位)与 TTFT(滞后校验)三个指标,扩容窗口 30~60 秒求快、缩容窗口 5~10 分钟求稳;同时要正视 GPU 副本 3~10 分钟的冷启动,用权重预热、预测式扩容和入口削峰消化扩晚的窗口,缩容侧则靠 drain、慢步进和 KV 水位否决保护长会话——把这套做完,副本数才真正跟得上流量,而不是跟在后面收拾残局。