BRAM 真双口模式:两个端口同时读写的冲突规则
入门篇 BRAM vs 分布式 RAM 解决的是「数组落到哪种资源」的问题;本篇往下钻一层,专讲 BRAM 真双口模式(True Dual Port,TDP):一块 BRAM 长着两个端口,两个端口各自带时钟、使能、地址和数据,能同时访问同一个存储阵列。多出来的自由度不是免费的——两端口在同一拍撞上同一地址时谁读到新值、谁读到旧值、什么情况下结果根本不保证,都有明确但不直观的硬件规则。这些规则是 FIFO、乒乓缓冲、双主机共享缓存等设计绕不开的地基,进阶篇 BRAM/URAM 存储设计 给的是全景,本篇给的是冲突语义的细节。
先用一张对比卡给出全篇坐标:简单双口、真双口、分布式 RAM/SRL 三者在端口能力上的根本差别。
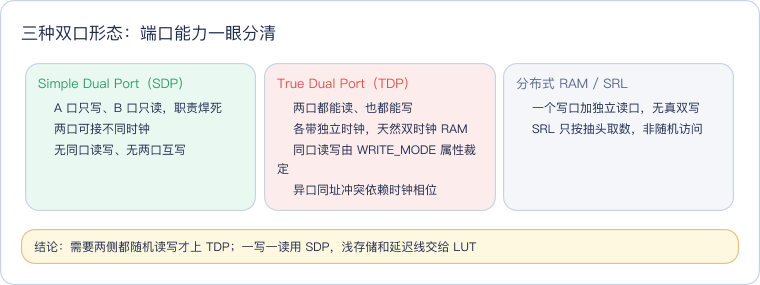
读这张卡抓住一条主线:端口能力的分界线不是位宽或容量,而是「谁能写」。SDP 把读写分置两口,物理上消灭了大部分冲突;TDP 把读写自由同时交给两个口,冲突语义随之出现;分布式 RAM 与 SRL 根本没有两个写端口,想冲突都没有资格。
本文要回答的问题
- BRAM 真双口模式与简单双口、单口在端口结构上差在哪里,一块 36Kb 原语内部怎么组织两个口?
- 两个端口为什么能各接一个时钟?这和异步 FIFO、跨时钟域设计是什么关系?
- 同一个端口在写的同一拍又在读,WRITE_FIRST、READ_FIRST、NO_CHANGE 三个属性分别让输出端看到什么?
- 两个端口在同一拍访问同一地址,结果由什么决定?两口同时写同一地址会怎样?
- RTL 要写成什么样子综合器才会推断出 TDP,什么场景又该主动退回 SDP、分布式 RAM 或 SRL?
一、三种端口模式:先把词汇对齐
Xilinx 7 系的一块 BRAM 是 36Kb(由两块 18Kb 拼合,也可拆开各自独立使用),Intel 同代器件上对应的硬资源叫 M20K。无论哪家,端口模式都是同一套三分法:
| 模式 | 端口 A | 端口 B | 时钟 | 典型用途 |
|---|---|---|---|---|
| 单口 SP | 读+写,分时复用 | 不存在 | 一个 | 配置表、低速参数存储 |
| 简单双口 SDP | 只写 | 只读 | 可同可异 | 数据流缓冲、异步 FIFO |
| 真双口 TDP | 读+写 | 读+写 | 可同可异 | 双主机共享缓存、乒乓控制、双侧随机访问 |
SDP 是工程里用得最多的形态:生产者永远对着 A 口灌数据,消费者永远对着 B 口取数据,地址互不重叠于同一事务语义里,连冲突的机会都很少。TDP 则是在确实需要「两边都可能读、也可能写」时才动用的重装备——典型如两个接口主设备共用一片包缓存、软件经某端口改表而硬件同时查表、乒乓缓冲的切换侧需要反向访问。代价是设计者必须回答下面几节的全部冲突问题。如果架构上其实是一写一读,不要为了「以后可能要双向」过早选 TDP,用 SDP 让工具把冲突检测和时序优化做得更满。
二、TDP 的硅片结构:两口共享一个存储阵列
真双口在硬件上并不是两块 RAM 拼在一起,而是同一套存储位元阵列挂了两套完全对称的端口外设。每个端口各有自己的时钟、时钟使能、写使能(按字节分组)、地址锁存、输入数据锁存和输出锁存,底层阵列只有一份。
图中两个蓝色端口是对称的访问入口,灰色阵列是唯一的存储本体,橙色字节写使能负责按字节掩写,紫色输出锁存解释了「BRAM 读为什么天然晚一拍」——地址在时钟沿进入阵列,下一拍数据才经输出锁存出现在 doa/dob 上。读这张图还要记住一个容量细节:36Kb 整块使用时两个端口共享全部容量;配置成两个独立 18Kb 时,器件内部其实是把下半区交给 A 口、上半区交给 B 口式的独立用法,那时它更像两块各带一端口的 RAM,而不是严格意义上的两端口共享。具体位宽深度组合(512×72、1K×36、8K×4 等)由数据宽度决定,工具按数组声明自动选取。
正因为阵列只有一份,「两个端口同时访问」本质上是两套外设对同一组位元发起并发事务——后面所有的冲突规则都从这个物理事实派生。
三、两个端口两个时钟:天然的双时钟 RAM
TDP(以及 SDP)最值钱的特性之一,是两个端口的时钟在硅片上就是独立的:clka 和 clkb 可以同源同频、同源异频,甚至可以来自两个毫不相干的振荡器。存储阵列内部用各自端口的时钟沿锁存地址和数据,不需要两个时钟有任何相位关系。这使一块 BRAM 天然就是双时钟 RAM,也是跨时钟域数据传递最经典的物理载体。
读图要点:数据路径(蓝色写侧→灰色 BRAM→绿色读侧)本身是安全的,BRAM 的双时钟结构允许两个域各沿各的时钟访问;真正需要额外硬件的是控制路径——橙色的指针同步器。写指针要编码成格雷码、经两级触发器同步到读侧去判空,读指针反向同步去判满。这正是 异步 FIFO 与 CDC 的完整骨架,BRAM 充当其中「数据不过亚稳态、只有指针需要同步」的那块隔离存储,原理背景见 亚稳态与跨时钟域,工程封装见 FIFO 设计。
需要立刻点明的界限是:双时钟 BRAM 可以让数据安全跨域,但有访问条件——两侧不能在时钟关系未知时同时碰同一地址。异步 FIFO 的全部精巧之处(格雷码指针、空满留余量)就是为了保证写地址和读地址在物理上永远不会在同一拍指向同一格。直接把一块裸 TDP RAM 当「双时钟共享寄存器」用,等于亲手放弃这个保证。多时钟设计的约束写法见 多时钟设计。
四、同一个端口边写边读:WRITE_MODE 三属性
先看最简单的情形:只有 A 口在动,它在某一拍 ena=1、wea=1,addra 指向地址 X,dina 上是新值 42,而 X 里的旧值是 17。这一拍 doa 上该出现什么?BRAM 原语为每个端口提供了一个可配置属性 WRITE_MODE(Xilinx 工具与 Intel IP 中名称略有不同,Intel 侧常称 read-during-write),三个取值给出三种确定答案:
| 属性 | 写当拍 doa/dob | 适用语义 | 代价 |
|---|---|---|---|
| WRITE_FIRST | 新值 42 | 「写进去当拍就读得到」 | 功耗略高,写驱动直接绕到输出 |
| READ_FIRST | 旧值 17 | 高吞吐通用,先读后写 | 无额外代价,多数 IP 默认 |
| NO_CHANGE | 保持上一拍锁存值 | 写期间输出冻结,省电 | 读方要知道输出不会更新 |
下面的波形把 WRITE_FIRST 与 READ_FIRST 放在同一组激励下对比:第二拍 wea 拉高、向地址 A 写入 42,这一拍两种模式的输出分叉,第三拍起重新收敛。
读这张波形只盯第二拍:地址与数据完全相同的一次写,WRITE_FIRST 让 doa 立刻翻成 42,READ_FIRST 让 doa 维持旧值一拍、第三拍再读到 42。NO_CHANGE 不出现在图里,它的行为是写使能期间输出锁存完全不翻转——连「读新地址」都不做,纯粹省电。工程含义有两个:其一,累加数组、写回更新这类「写完马上要用新值」的反馈结构要选 WRITE_FIRST,否则会拿到上一拍的旧值;其二,行为级仿真模型与真实 BRAM 的默认值可能不同,不显式指定属性,综合前后仿真结果可能对不上,这类错位在板上极难排查。用 IP 时在配置页选,手写推断时综合器按 RTL 中读语句与写分支的先后关系推断(见第七节),最终以综合日志与原语参数为准。
五、两个端口撞上同一地址:异口冲突的裁定规则
真正微妙的是跨端口情形:A 口沿 clka、B 口沿 clkb,在时间上重叠地访问同一地址。裁定不是一句话,而是一棵按「时钟关系」分叉的决策树。
颜色即结论:绿色安全、红色危险、橙色待判。顺着这张图可以读出三条确证规则。
第一,两口同时写同一地址在任何时钟关系下都是非法操作。 存储位元在同一刻收到两个不同驱动,写进去的是什么没有任何保证,工具也不会替你仲裁。需要双向写共享存储时,仲裁逻辑必须放在 BRAM 之外(互斥、时分轮转或握手),从架构上杜绝双写重叠。
第二,一读一写同址、且两个时钟同源、时钟沿对齐(或相位关系已知且满足器件要求)时,行为是确定的,但由原语参数配置决定。 工具在例化 BRAM 时把冲突行为 parameter 化:Xilinx 原语由两个端口各自的 WRITE_MODE 组合裁定,Intel M20K 提供新数据、旧数据、不关心(DONT_CARE)三档可选。选「不关心」时综合器可以用最省资源的内部实现,但你不能在逻辑上依赖读出值。同源设计里只要把配置选明确、仿真覆盖同址情形,行为就是可预期的。
第三,异步时钟下的异口同址一读一写,读出口数据不保证。 写操作可能恰好落在读时钟沿的建立/保持窗口内,输出可能是旧值、新值,甚至是一段不确定态。不要去记任何具体的建立时间数字——它随器件、电压、温度漂移,数据手册只给边界条件,不承诺这种用法。因此跨时钟域传递数据的正道永远是第六节之外那套组合:让 FIFO/指针逻辑保证不同址,或直接用厂商 FIFO IP(内部已把约束和冲突配置处理好),并在约束中声明两个时钟异步(如 set_clock_groups),让工具不去检查那条本就无法满足的时序路径。
一句话收口:BRAM 的双时钟特性解决的是「两个时钟域各用各的沿访问」,不是「两个时钟域同时抢同一格」。
六、使能、字节写与复位:端口控制信号的实际语义
除了时钟和地址,每个端口还有几类控制信号,初学者常把它们与普通寄存器的同名信号混为一谈。
端口使能(ENA/ENB)是整个端口事务的总开关。 使能拉低时,该口的读、写、输出锁存在这一拍全部冻结,不产生任何内部翻转。它首先是功能信号(实现「这一拍不访问」),同时也是功耗手段——空闲端口长期关使能能显著降低动态功耗。注意它不是片选:BRAM 是按整块例化的,没有「选其中几块」的概念,多块级联时片选由外部地址译码产生。
写使能支持按字节分组(byte-write enable)。 32 位数据对应 4 个字节使能、72 位对应 8 个(含校验位时按 9 位一组)。某字节使能为 0 时,该字节在写周期内保持原值,实现「只更新半个字」而无需先读后写。RTL 推断时要把写使能展开成逐字节判断,工具才会映射到硬件字节使能而不是退化实现:
// 32 位数据、按字节写:wea 为 4 位,每位管一个字节
always @(posedge clka) begin
    if (ena) begin
        if (wea[0]) mem[addra][7:0]   <= dina[7:0];
        if (wea[1]) mem[addra][15:8]  <= dina[15:8];
        if (wea[2]) mem[addra][23:16] <= dina[23:16];
        if (wea[3]) mem[addra][31:24] <= dina[31:24];
    end
end
复位只复位输出锁存,永远复位不了存储阵列。 RSTA/RSTB 影响的是 doa/dob 上的输出寄存器(含可选的第二级输出寄存器),mem 里的数据不接受任何复位值。因此 RTL 里出现 if (rst) mem[i] <= 0 一类写法会直接破坏 BRAM 推断,数组被摊成触发器。需要「清空」语义时,用状态机按地址扫写零,或像 FIFO 那样让读写指针归零、旧数据自然失效。复位设计的一般原则见 时钟与复位。
七、RTL 怎么写才会推断出 TDP
综合器按代码模式推断存储,不认变量名。SDP 的范式是一个写 always 块加一个读 always 块;TDP 的范式是两个 always 块各带各的时钟、对同一个数组既读又写。
// 真双口 BRAM 推断骨架:两口对称、各带时钟,共享同一个 mem 数组
(* ram_style = "block" *) reg [DW-1:0] mem [0:DEPTH-1];

// 端口 A:自己的时钟,能读能写
always @(posedge clka) begin
    if (ena) begin
        if (wea) mem[addra] <= dina;   // 写
        doa <= mem[addra];              // 同步读(晚一拍)
    end
end

// 端口 B:独立时钟,同样能读能写
always @(posedge clkb) begin
    if (enb) begin
        if (web) mem[addrb] <= dib;
        dob <= mem[addrb];
    end
end几个推断要点值得逐条对照。其一,两个 always 块、两个时钟沿、共享同一数组名,是工具识别 TDP 的核心特征;只有一个时钟又写成两块,工具可能合并成更省资源的形态。其二,读必须同步(在沿上 doa <= mem[addra]),异步读 assign doa = mem[addra] 映射不了 BRAM,会落到分布式 RAM。其三,同口读语句放在写分支之后通常被推断为 WRITE_FIRST,放在写分支之前或写分支中不给读赋值则倾向 READ_FIRST/NO_CHANGE——不同综合器版本的推断细则会漂移,跨版本可移植的做法是直接用 Block Memory Generator 之类 IP 把模式钉死(IP 使用见 IP 核入门)。其四,推断成功后要做两件核对:综合日志里找到 inferring dual port RAM 之类信息行;利用率报告中 RAMB36/RAMB18 计数符合预期,且 LUT as Memory 与 FF 没有异常暴涨。存储推断的完整规则与资源对账方法在 入门 27 中有系统讲解。
八、选型:什么时候用 TDP,什么时候退回 SDP 与分布式 RAM
双口能力越往上,需要设计者回答的冲突问题越多。按下表从右往左选——能用简单形态满足的,不要提前动用 TDP。
| 需求形态 | 选择 | 理由 |
|---|---|---|
| 一写一读、两口分属生产者/消费者 | SDP BRAM | 物理上无同口冲突,异口冲突交给 FIFO 指针规避 |
| 跨时钟域数据流 | SDP + FIFO 控制/IP | 异步 FIFO 的标准载体,见 异步 FIFO |
| 两侧都要随机读写、同频同源 | TDP,显式配 WRITE_MODE | 参数化冲突确定,仿真覆盖同址情形即可 |
| 两侧随机读写且异步时钟 | TDP + 外部仲裁/握手 | 必须杜绝双写同址,避免依赖异口冲突输出 |
| 几十深的小 FIFO、寄存器堆 | 分布式 RAM | 一写一读它也做得到,且省整块 BRAM |
| 固定延迟线、等周期抽头 | SRL | 地址是抽头号不是随机地址,比 RAM 更省,见 LUT 与 FF 深入 |
最后两行是容易被忽略的退路:分布式 RAM 只有一个写口加独立读口,做不了真双写,但浅 FIFO、两读一写的寄存器堆本来就不需要 TDP;SRL 连随机访问都不是,它解决的是「把数据流延迟 N 拍、从固定抽头取出来」的问题,延迟对齐、流水线补拍用它比占一块 BRAM 划算得多。反过来,一旦深度×位宽到了几十 Kb 量级、或两侧确实都要写,分布式实现会迅速吃光 LUT,那时 TDP BRAM 是唯一经济的选择。容量与资源归宿的完整权衡见 入门 27,乒乓缓冲等组织手法见进阶 BRAM/URAM 存储设计。
常见坑速查
| 坑 | 现象 | 处理 |
|---|---|---|
| 两口同时写同址 | 写入值随机、偶发数据损坏 | 仲裁逻辑放到 BRAM 外,杜绝重叠 |
| 异步时钟下依赖异口同址读出值 | 板上偶发旧值/新值跳变 | 改 FIFO 结构保证不同址,或用 FIFO IP |
| 不指定 WRITE_MODE | 仿真与上板行为不一致 | IP 配置页钉死,或调整 RTL 读写语句顺序 |
| 给 mem 数组加复位 | BRAM 消失、FF 暴涨 | 只复位输出锁存;清缓存靠扫写或指针归零 |
| 一写一读误用 TDP | 冲突检查复杂、约束变难 | 退回 SDP,让端口职责物理隔离 |
| 想异步读又要 BRAM | 综合进分布式 RAM,LUT 暴增 | 接受同步读晚一拍,读也放时钟沿 |
这一篇在知识体系里的位置
本篇属于 FPGA 存储资源簇的「端口语义」层。向下的资源基础与选型直觉看入门 BRAM vs 分布式 RAM 与 LUT 与 FF 深入;向上的系统组织看进阶 BRAM/URAM 存储设计(乒乓、行缓存、URAM)。双时钟特性把本篇直接连到时钟域簇:亚稳态与跨时钟域 讲为什么裸跨域会出错,异步 FIFO 讲双口 BRAM 怎样配合格雷码指针成为 CDC 标准解,多时钟设计 讲时钟约束怎么写,FIFO 设计 讲深度计算与工程封装。同步设计的一般纪律见 同步设计原则,芯片整体资源版图见 FPGA 架构基础。
总结
BRAM 真双口模式让一块 36Kb BRAM 的两个对称端口各带独立时钟、使能和字节写使能,对同一份存储阵列既读又写:36Kb 可整块使用也可拆成两个独立 18Kb;一写一读选 SDP,两侧都要随机读写才上 TDP,浅存储与延迟线退回分布式 RAM 和 SRL。冲突语义分三层记住——同口边写边读由 WRITE_FIRST/READ_FIRST/NO_CHANGE 三属性裁定,必须显式配置否则仿真与上板可能不一致;异口同址在同源对齐时钟下由原语参数化确定,异步时钟下读出口不保证;两口同时写同址任何情况下都非法,仲裁必须放在 BRAM 之外。双时钟结构使 BRAM 天然胜任跨时钟域数据载体,但前提是 FIFO 指针逻辑保证两侧不撞同一地址。RTL 推断 TDP 的范式是两个各带时钟的 always 块共享同一 reg 数组、读也在时钟沿上,写完以综合日志和资源报告核对落点。