虚拟时钟:用 virtual clock 建模片外器件接口时序的原理与实战
更新时间:2026-10-04。做芯片接口时序约束时绕不开一个尴尬事实:STA(静态时序分析)的检查框架建立在 reg-to-reg(寄存器到寄存器)路径上,可输入端口外的「上游寄存器」、输出端口外的「下游寄存器」都在别人的芯片上,SDC 里根本没有它们的对象。虚拟时钟(virtual clock)就是给这个「看不见的邻居」立数学替身:一条
create_clock不挂任何 pin/port,纯粹作为片外器件时钟的符号存在,再让set_input_delay/set_output_delay对着它说话。预算侧怎么给接口分配时间余量,IO 时序预算与约束 那篇已讲过;这一篇讲预算落地成约束后的另一半——虚拟时钟的原理、latency 怎么配合 delay 命令、两套东西的分工边界。时钟延迟基础概念可先回顾 STA 时钟 latency 之 source 与 network,层次化背景见 层次化 STA 与块接口建模。
本文要回答的问题
- 为什么片外器件的时序不能用普通 create_clock 建模,虚拟时钟到底「虚拟」在哪?
- set_input_delay 和 set_output_delay 的参考时钟为什么是虚拟时钟而不是本芯片时钟?
- 虚拟时钟的 source latency 怎么和 input/output delay 分工,两者会不会重复计数?
- 与 io budget(接口时序预算)的分工边界在哪——谁定数、谁表达?
- 虚拟时钟用错的典型翻车现场有哪些,签核前怎么自查?
一、问题本质:STA 眼里没有片外世界
先回忆 STA 的基本盘:一条时序检查(setup/hold)需要发起沿、捕获沿、两个时钟。对输入路径(片外上游寄存器 → 输入端口 → 片内寄存器),捕获沿在片内,时钟是本芯片真实时钟,没问题;但发起沿在片外上游寄存器上,它连同它的时钟都不在你的设计数据库里。没有发起时钟,setup 方程少一边,工具没法算。
片外:  [上游 FF] --板级走线--> | 输入端口 --> [片内 FF]  :片内
         ^?                        ^
   它的时钟是什么?            这个好办,create_clock 挂端口
对输出路径对称:捕获沿在片外下游寄存器,同样缺一个时钟。传统 SDC 的补丁就是虚拟时钟——create_clock -name VCLK -period 10(注意没有对象列表),声明一个周期为 10ns、但不依附于任何物理节点的时钟。它存在的唯一意义,是给 set_input_delay -clock VCLK 和 set_output_delay -clock VCLK 提供参考系,让工具把接口路径「脑补」成一条完整的 reg-to-reg 路径来检查。
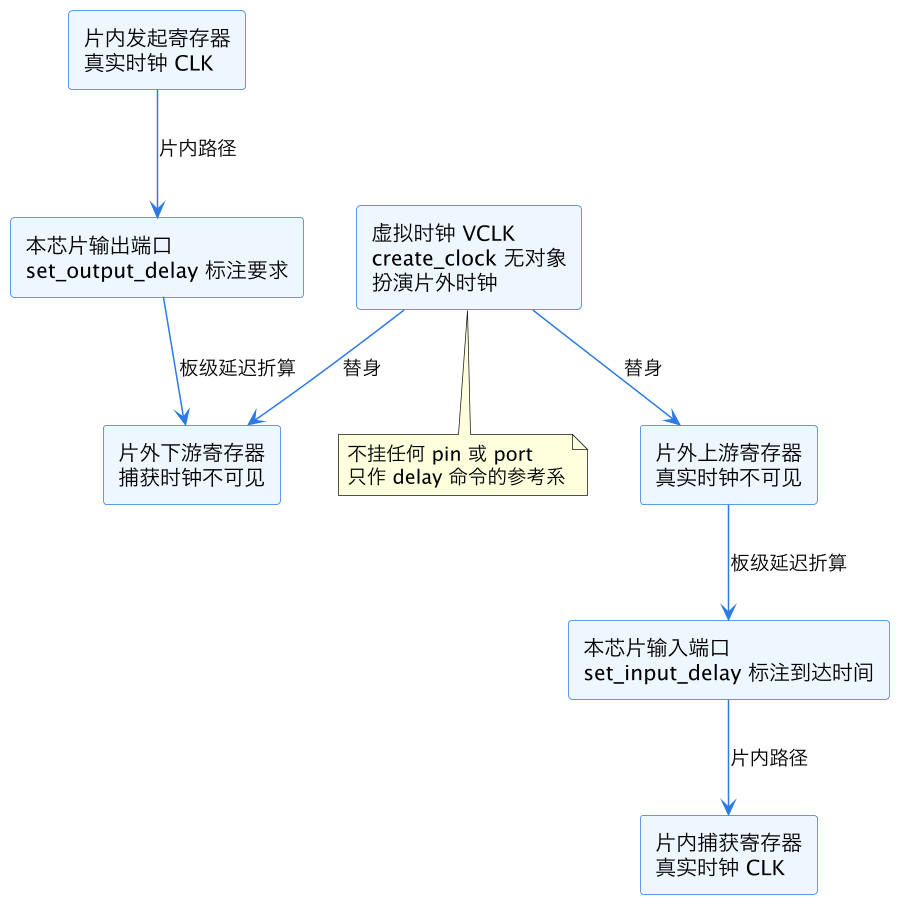
这张图是虚拟时钟建模的全貌:上下两条接口路径,图外侧的世界全部由 VCLK 一个符号代表。关键点——虚拟时钟不是在「模拟」片外时钟树,它只是给 STA 方程补上缺失的时钟变量。片外时钟的抖动、偏斜、延迟全部折算成数字塞进 delay 和 latency,虚拟时钟本身不携带波形细节。
二、定义语法与三种典型用法
虚拟时钟的定义极简:
create_clock -name VCLK_CPU -period 10    ;# 无对象 = 虚拟时钟
set_clock_latency -source 1.2 [get_clocks VCLK_CPU]
周期必须和片外器件的真实时钟一致——虚拟时钟的周期就是片外发起/捕获沿的周期,写错了整条接口的 setup 检查基准就错。三种典型用法对应三种接口形态。
第一种,同频同源接口:片外器件和本芯片共用同一时钟源(比如同源晶振分发)。虚拟时钟周期等于真实时钟周期,delay 值里只需折算走线和片外器件的时钟到输出延迟(clock-to-Q)。
第二种,同频异源接口:两个时钟源标称同频但各自独立,存在 ppm 级频差。这时虚拟时钟和真实时钟之间要加 set_clock_uncertainty 或者干脆按异步处理,视协议要求定——STA 时钟 uncertainty 与抖动 那篇有 uncertainty 的推导口径。
第三种,多时钟接口:一个端口在功能模式下来自 A 时钟域的器件、测试模式下来自 B 时钟域。定义两个虚拟时钟,用 -add 版本的 delay 命令叠加,再靠 case analysis 或 mode 拆分让工具分模式检查,和 corners 与 MMMC 配置 的多模式框架对齐。
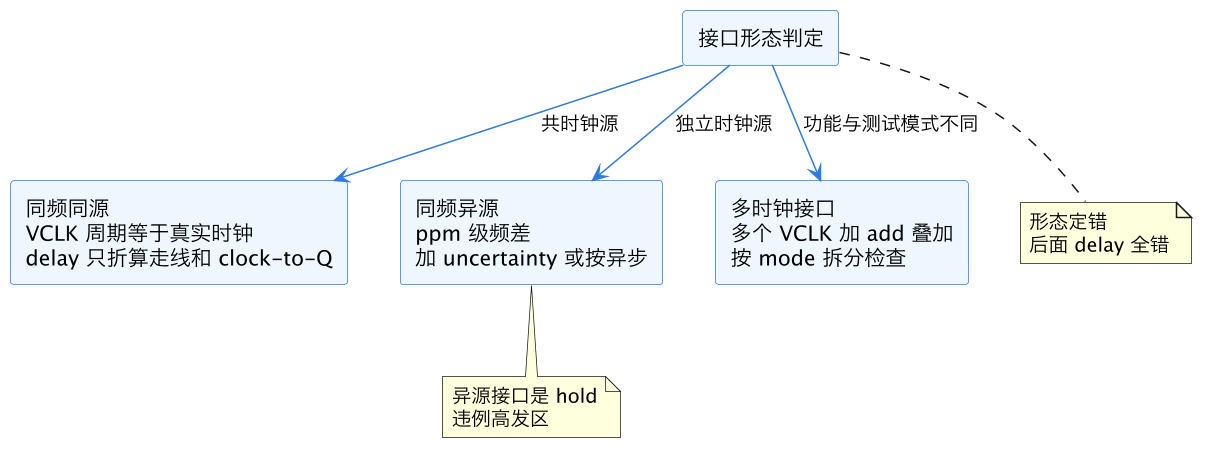
这张图是建模前的分流判定。实战中一半以上的接口时序 bug 不是 delay 数值算错,而是接口形态判定错——把异源当同源,uncertainty 少加了几十皮秒,silicon 回来 hold 满天飞。
三、input/output delay 与虚拟时钟 latency 的配合
这是本篇的核心机制。先看 setup 检查里一条输入路径的到达时间怎么拼:
到达时间 = VCLK 发起沿时刻 + VCLK source latency + input delay + 片内路径延迟set_input_delay 标注的是「数据相对片外时钟沿、经过片外 clock-to-Q 加板级走线之后,到达本芯片端口的时刻」。set_clock_latency -source 标注的是「片外时钟从它的源头到片外寄存器时钟脚的延迟」。两者相加,才完整复现了数据从片外时钟源头出发到本芯片端口的总耗时。
给一个具体数字例子把公式坐实。假设接口周期 10ns,片外上游器件数据手册给 clock-to-Q 最大 1.8ns,板级走线加连接器最慢 1.5ns,那么 set_input_delay -max 3.3 -clock VCLK [get_ports din];片外时钟源到上游寄存器的时钟延迟测得 0.8ns,则 set_clock_latency -source 0.8 [get_clocks VCLK]。于是输入路径的发起侧总延时是 0.8 + 3.3 = 4.1ns,留给片内组合逻辑和捕获寄存器 setup 的余量是 10 - 4.1 = 5.9ns 再减去片内时钟捕获 latency 的差值。这个 5.9ns 就是片内路径的「可用预算」,它和 io budget 表里「片内份额」那一栏必须对得上——对不上就是第四节要说的分工错位。
问题来了:既然 input delay 已把 clock-to-Q 算进去,为什么还要给虚拟时钟设 source latency?答案是时钟偏斜(clock skew)的建模。片外上游寄存器的时钟和本芯片捕获寄存器的时钟若来自同一片板级时钟树,两片芯片分到的时钟到达时刻可能不同——比如上游早 0.3ns 拿到。这部分偏斜属于时钟路径而非数据路径,应进 latency。分工口径:数据路径上的一切(clock-to-Q、走线、连接器)进 input/output delay;时钟路径上的一切(片外时钟树延迟、源到 FF 的 skew)进虚拟时钟 source latency。
对输出路径对称:set_output_delay 标注片外下游器件要求数据提前于它捕获沿多少时间稳定(本质是它内部的 setup 时间加走线延迟),而下游寄存器的时钟到达时刻用虚拟时钟的 source latency(capture 侧)表达。
再给一个输出侧的数字例子,把 capture 侧 latency 的作用坐实。假设周期仍为 10ns,片外下游器件数据手册要求数据相对其捕获沿提前 2.0ns 稳定(含其内部 setup 1.2ns 与板上走线 0.8ns),则 set_output_delay -max 2.0 -clock VCLK [get_ports dout]。若片外时钟源到下游寄存器的时钟比到本芯片晚到 0.5ns——也就是说捕获沿整体后移,对输出路径是「宽限」——这 0.5ns 必须作为 VCLK 的 capture source latency 写进约束,工具才会把 required time 放宽到 10 + 0.5 - 2.0 = 8.5ns。漏写这条 latency,等于平白把片内输出路径的预算砍了 0.5ns;而方向写反(把「晚到」建成「早到」)则更危险,setup 被放宽了实际并不存在的裕量,silicon 上就是间歇性采样错误。方向判定的口诀是:下游时钟晚到,对输出 setup 是好事,latency 取正;上游时钟早到,对输入 setup 是坏事,latency 同样要如实建进去,符号由工具按发起/捕获角色自己处理,人只要保证物理方向没错。
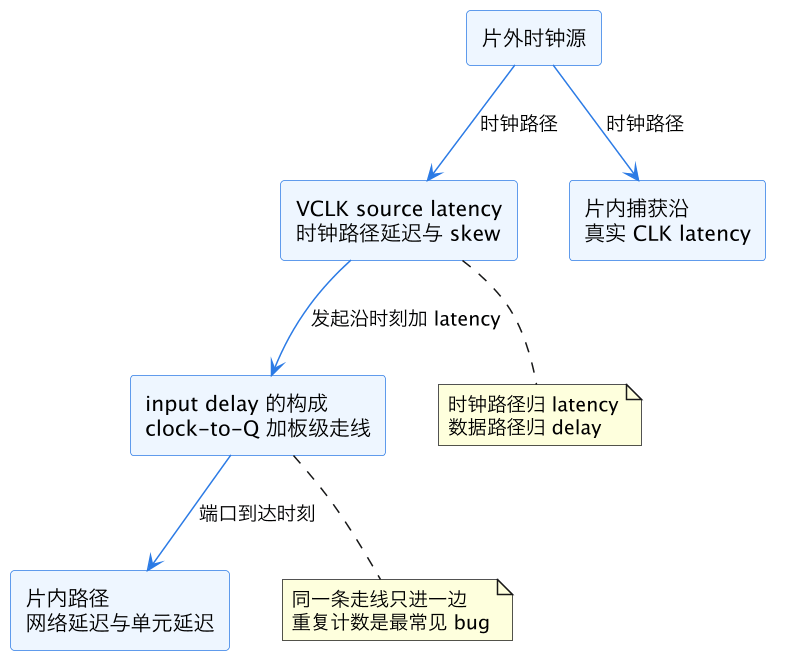
这张图把「谁进哪边」的分工画清楚了。重复计数是最经典的翻车:板级走线延迟既被板级分析组写进 input delay,又被 STA 工程师写进虚拟时钟 latency,setup 平白多几百皮秒悲观度,接口时序怎么都收不掉——Signoff 收敛 ECO 里有同类案例口径。自查方法很朴素:把 delay 和 latency 每项来源列成表,逐项标注物理含义,同一物理量出现两次即错。
| 物理量 | 归属 | 命令载体 |
|---|---|---|
| 片外器件 clock-to-Q | 数据路径 | set_input_delay 数值内 |
| 板级走线与连接器延迟 | 数据路径 | set_input/output_delay 数值内 |
| 片外时钟源到上游 FF 的时钟延迟 | 时钟路径 | VCLK source latency(launch) |
| 片外时钟源到下游 FF 的时钟延迟 | 时钟路径 | VCLK source latency(capture) |
| 片内时钟树延迟 | 时钟路径 | 真实 CLK 的 network latency / CTS 后传播 |
四、与 io budget 的分工:谁定数,谁表达
到这里可以和 IO 时序预算与约束 对齐分工了。一句话版本:io budget 是「定数」的方法学,虚拟时钟机制是「表达」的载体。budget 那篇解决的是:接口总周期时间怎么在「片外上游、板级、片内、片外下游」四段之间切蛋糕,比如 40% 给片内、30% 给上游器件、30% 给板级;本篇解决的是:蛋糕切完之后,片外那两份怎么翻译成 SDC——上游那份折算成 input delay 加 VCLK launch latency,下游那份折算成 output delay 加 VCLK capture latency。
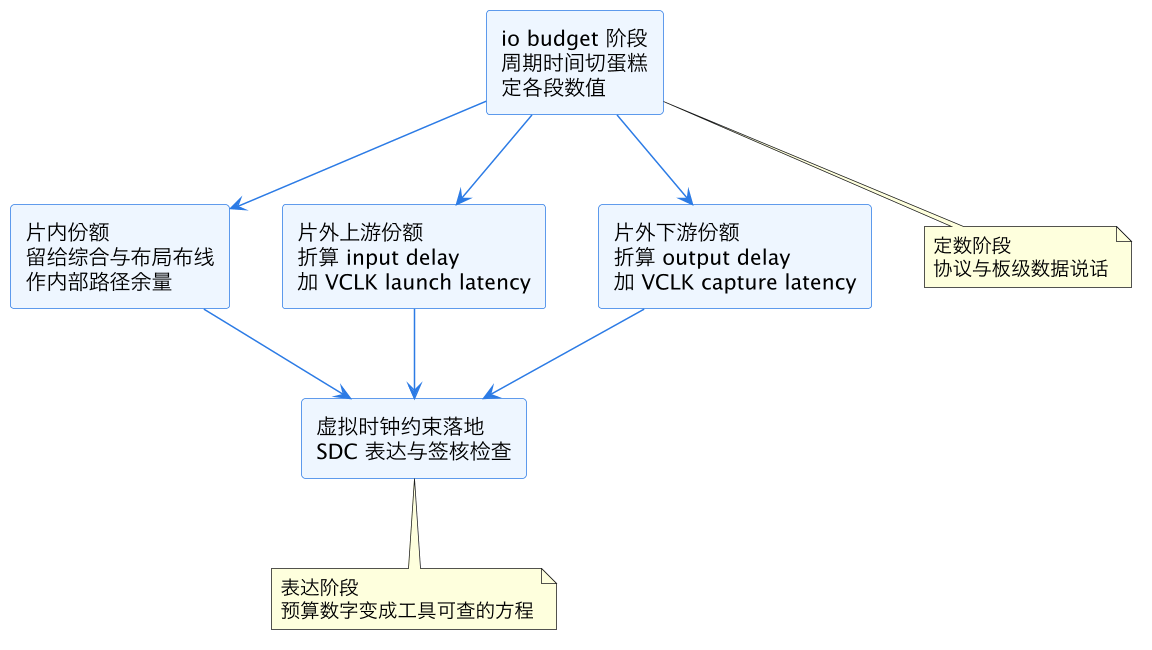
这张图是上下游关系:budget 输出三份份额,其中两份片外份额必须经虚拟时钟机制翻译才能进 STA。分工边界不清的典型症状有两个。一是预算改了约束没改:协议升级后 budget 重切蛋糕,SDC 里的 input delay 还是旧值,签核过的等于旧预算——协议组以为接口已经按新规范收紧,STA 实际还在按旧窗口放行,两边在各自的报告里都「全绿」,到硅后联调才撞车。二是约束超出预算:STA 工程师为了「保险」把 input delay 加大,实际是偷片内路径的预算,片内收敛压力凭空变大,表现为一修接口路径就冒内部路径违例,来回跷跷板——这在 SDC 约束验证与 lint 的检查项里有对应的预算一致性核对。
还有一种更隐蔽的错位发生在层次化设计里:顶层给块的接口约束本身就是一份「芯片内的 io budget」,块内工程师如果用虚拟时钟思路建模顶层接口(给块外逻辑立替身),必须确认顶层送来的 block-level SDC 里 input delay 已经包含了块外时钟延迟的折算,不能再叠一层 VCLK latency——层次化场景下 budget 与表达的边界从「芯片引脚」移到了「块边界」,原则不变,层次化 STA 与块接口建模 对此有完整展开。
落地流程上的建议做法:budget 表格(各段份额、来源依据)和 SDC 文件进同一个版本管理仓,任何一边改动触发另一边的一致性 review;约束 lint 脚本里加一条「input delay + 片内估计 > 周期 × 片外+片内总份额」的越界报警。
五、常见坑与签核前自查
把前面几节的失效模式收成一张检查清单,签核前逐条过。
第一坑,虚拟时钟周期与真实接口频率不符。特别是源同步、DDR(双沿数据率)接口:DDR 在时钟上升沿和下降沿都传数据,若用单沿周期建虚拟时钟,setup 检查窗口直接错一倍——名义 5ns 周期的 DDR 接口,数据有效窗口只有 2.5ns,按 5ns 建模等于把检查放宽了一倍。正确做法要么用 -clock_fall 版本的 delay 命令分别给上升沿发起、下降沿发起的路径标 delay,要么把虚拟时钟周期直接定义成半周期。类似的还有 SDR 接口被误当 DDR 收紧一倍、协议降频模式忘了同步改 VCLK 周期这两类变种,共同特征是「约束文件里的数字和协议规范的数字对不上」,核对手段只有一条:拿协议规范原文逐项对,不靠记忆。
第二坑,latency 与 delay 重复计数,第三节已展开。再补一个变种:CTS 后的 propagated 模式下片内时钟用真实传播延迟,虚拟时钟没有树可传播,永远停留在 source latency 设定值——它是手工维护的,时钟源参数变了要同步改,参见 STA 时钟 latency 对 propagated 与 ideal 模式的讨论。
第三坑,多 mode 下虚拟时钟遗漏。测试模式切了时钟源,功能模式的 VCLK 还挂在 delay 命令上,测试模式接口路径变成无约束——report_timing 不报,静默漏检。用 check_timing 的 unconstrained endpoints 报告兜住。
第四坑,max/min delay 不对称。set_input_delay -max 管 setup、-min 管 hold,只写 -max 时 hold 用默认 0,等于没约束。hold 侧片外最小时延往往是数据手册里最难找的数字,但漏了它,silicon 上的 hold 违例没有工具替你挡。
排查侧的实用线索:接口路径违例先看 report_timing 里的时钟行。发起时钟那行若显示 network latency 恒为 0、只有 source latency 一项,说明参考的是虚拟时钟,属正常;若整行空白、时钟字段是「-----」,多半是 delay 命令的 -clock 指向了一个没定义的时钟名(改时钟命名时漏同步最常见),路径实际已失约束,用 check_timing -include no_clock 一类的报告兜底能立刻捞出来。
| 自查项 | 命令或手段 | 失效后果 |
|---|---|---|
| VCLK 周期等于接口真实频率 | 对照协议规范 | setup 窗口整倍错误 |
| 数据路径量只进 delay 一边 | 逐项来源列表 | 重复或遗漏悲观度 |
| propagated 模式下 VCLK latency 手工同步 | review 记录 | 片外时钟延迟漂移 |
| 每个 mode 接口路径有约束 | check_timing 报告 | 静默漏检 |
| -min 与 -max 成对存在 | lint 脚本 | hold 无约束 |
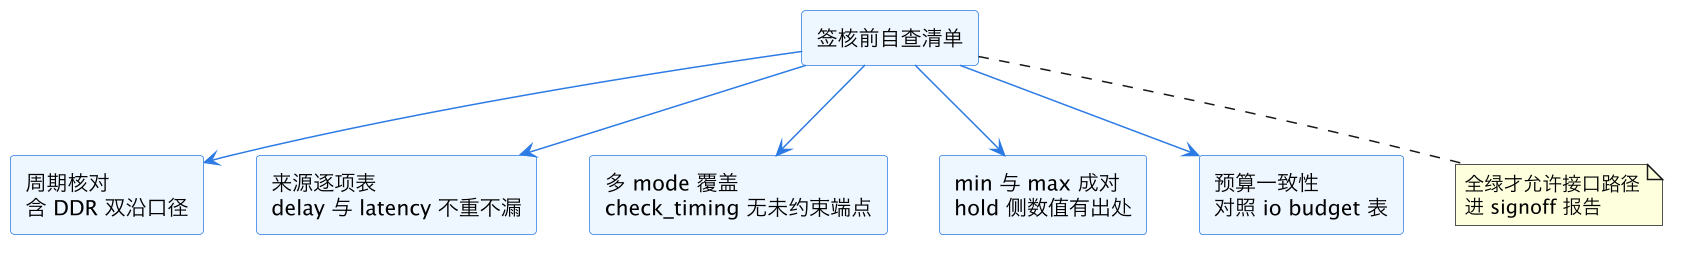
这张图是自查清单的闸门关系:五条全绿,接口时序才算「建模完成」,可以进 Signoff STA 与 PrimeTime 的正式签核。任何一条存疑,先回对应章节修,不要带着疑点签核——接口时序的失效在硅后几乎不可修复,修板级比重做芯片便宜这个安慰剂,只对极低速接口成立。
这一篇在知识体系里的位置
本篇是 eda/ 目录时序约束线的接口建模专文,与预算方法学的 IO 时序预算与约束 构成「定数 + 表达」的上下游对子:那篇切蛋糕,本篇把蛋糕翻译成 SDC。基础概念侧接 STA 时钟 latency 和 STA 时钟 uncertainty 与抖动,层次化场景见 层次化 STA 与块接口建模(块间接口是同一思路的芯片内版本),约束质量侧进 SDC 约束验证与 lint,多模式框架见 corners 与 MMMC 配置,最终落地 Signoff STA 与 PrimeTime。读完本篇,任何一条接口路径的 SDC 约束,你都能说出每个数字的物理出处。
总结
虚拟时钟是一条不挂任何物理节点的 create_clock,给片外「隐形寄存器」立数学替身,让 input/output delay 有参考时钟,把接口路径折算进 STA 的 reg-to-reg 检查框架;建模纪律是数据路径(clock-to-Q、走线)全进 delay 数值、时钟路径(片外时钟树延迟与 skew)全进虚拟时钟 source latency,逐项列来源、绝不重复计数;它与 io budget 的分工是「budget 定数、虚拟时钟表达」,预算表与 SDC 同仓管理、改动互审;签核前过五道自查——周期口径(含 DDR)、来源不重不漏、多 mode 全覆盖、min/max 成对、与预算表一致——全绿后接口时序才有资格进 signoff 报告。