计算光刻 OPC:在掩模版上「画一个不一样的形状」,硅片上才得到想要的形状(F4)
这是制造侧 EDA(DTCO/掩模数据链),和设计侧综合布线几乎是两个世界。光刻物理常识见 芯片制造、摩尔与工艺节点,OPC 之后的掩模规则检查与格式转换是 F5 DFM/掩模准备,版图格式见 GDSII/OASIS 概念、F7 格式。工具代表:Synopsys Proteus、Siemens Calibre OPC/OPCpro、Cadence Litho。
一、根本矛盾:想印的尺寸比光的波长还小
光刻是把掩模版(mask/retiele)上的图形用光照「投影」到涂了光刻胶的硅片上。当工艺进入深亚微米/纳米,硅上要的线宽(如几十 nm)远小于曝光波长(193nm 干式/浸没式用了很多代)。光通过掩模小孔发生强烈衍射与干涉,投影系统是个低通滤波器:
- 掩模上画一个直角,硅片上可能是圆角、线端缩短(line-end shortening)、相邻线因为光的互相影响而疏密失真;
- 也就是说掩模形状 ≠ 晶圆形状,直接照设计 GDS 去做掩模,印出来会短路/开路/线宽超差。
计算光刻的思路是「将错就错」:既然成像会失真,那就先把掩模上的图形反向预扭曲(predistort),让它经过光学畸变后,恰好落在硅上成为想要的形状——这就是 OPC(Optical Proximity Correction,光学临近修正)。
二、RET/OPC 家族怎么修正
| 技术 | 做法 |
|---|---|
| rule-based OPC | 查表:按图形的宽/间距等几何特征,用经验规则加固定偏置。快但对新图形不准 |
| model-based OPC | 对每个边切段(fragment),用光刻模型正向模拟成像结果,迭代移动各片段直到预测轮廓(EPE,edge placement error)达标。准但计算量巨大 |
| SRAF(亚分辨辅助图形) | 在主线旁加一些本身不会被印出来(小于分辨率)的小辅助条,只用来调制光场,改善主线的工艺窗口 |
| 线端/ hammerhead | 线端加锤头状补偿,对抗线端缩短 |
| RET 其他 | 相移掩模(PSM,利用相位差增强对比)、离轴照明(OAI)等 |
model-based OPC 是一个大规模「仿真—比对—挪边—再仿真」的优化循环:全芯片几亿到上百亿个图形片段,每个都要反复做光学成像模拟,这正是它极其吃算力的原因(详见第四节)。
三、SMO 与逆光刻 ILT:把自由度用到极致
- SMO(Source-Mask Optimization,光源-掩模协同优化):不只优化掩模,连**照明光源的形状/极向(custom/自由形式 illumination)**一起与掩模联合优化。先进节点(接触孔、金属一维密线)靠固定光源 OPC 已不够,SMO 对一类关键层显著扩大工艺窗口;
- ILT(Inverse Lithography Technology,逆光刻):把问题反过来做数学求解——「给定我想要的晶圆图形,反求能产生它的最优掩模透射函数」。ILT 算出的掩模常是弯曲、复杂、不像曼哈顿直角的图形(curvilinear mask),工艺窗口最好,但:
- 这是一个巨型逆问题/优化问题,计算量比传统 OPC 还高一个量级;
- 生成的曲线图形对掩模制造成本/检查是挑战(过去受电子束写掩模时间限制,近年多束电子束(MBMW)与曲线掩模工艺成熟,ILT 重新升温)。
ILT/SMO 的成果通常以 pixelated source、ILT 目标层形式进入 OPC 流程,是先进节点良率的关键杠杆。
四、为什么吃掉海量算力(以及 GPU/AI 怎么救)
- 核心是卷积/成像仿真:光学像近似为掩模透射函数与光源点扩散函数(kernel)的卷积(SOCS 分解成几十个空间核叠加),对每个评估点都要算;
- 全芯片图形片段上百亿,OPC 内层迭代十几次、每次全芯片成像仿真 → CPU 集群一跑数天到数周;
- 掩模验证(lithography process check, LPC)还要在焦深/曝光剂量(defocus/dose)矩阵下扫多个工艺角,检查热点(pinch/bridge);
- 加速路线:
- GPU 并行(Proteus 等):成像卷积是天然的数据并行,GPU 可获数十倍加速,把 ILT 这类重算变可行;
- AI/ML(尤其是 CNN/U-Net 类):学习「目标图形→ILT 掩模」的映射做快速初值或端到端预测,再用传统模型精修,是当前计算光刻最热的降本方向;
- 多核 CPU 集群 + 层次化(按图形环境去重复用,reticle/frame 级并行,作业调度见 G3 LSF)。
五、为什么这是 foundry 的地盘(与设计 EDA 的边界)
- OPC 模型要用该工艺的光刻机参数、光源、光刻胶、刻蚀偏差等机密/实测数据标定(F10 版本基线 里最敏感的部分),foundry 才有;
- 修正策略、SRAF 规则、哪些层用 ILT 由 **foundry/IDM 与掩模厂(mask shop)**掌握,按层(poly/metal/contact/via)分别建模;
- 设计公司一般不直接跑生产 OPC,但会在 DFM 阶段用 foundry 给的 litho-friendly design / 热点检测规则提前规避「本质难印」的图形(与 F5 衔接);
- 因此计算光刻是「绑定工艺数据 + 超大规模算力 + 物理模型」三位一体、壁垒极高的制造侧 EDA,也是国产替代最难啃的环节之一(产业格局见 EDA 生态)。
六、与上下游的接口
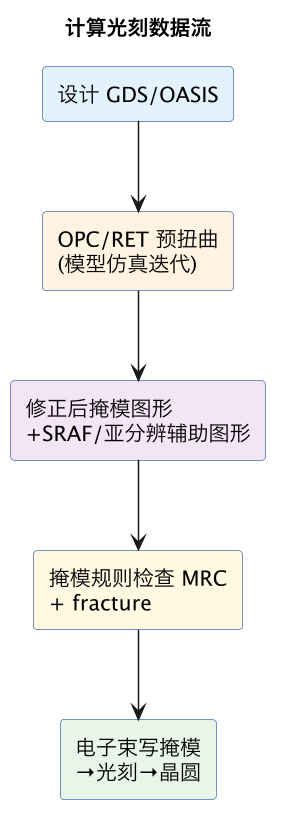
- 输入:设计签核后的 GDS/OASIS(F7),经 DRC/LVS E3 干净;
- DFM 预处理:移除/修补难制造图形、可选金属填充、litho 热点预防(F5);
- OPC/SMO/ILT 生成修正掩模;
- **MRC(Mask Rule Check,掩模规则检查)**确认修正后的图形在掩模制造能力内(最小宽度/缝接/CD 容差);
- fracture(碎裂/数据转换):把版图切成电子束曝光机的格式(MEBES/OSS 等,F5);
- 写掩模、晶圆光刻,结果再用 SEM/CD-SEM 量测回标改进模型,形成工艺闭环。
相关与延伸
- 紧邻:F5 DFM/掩模数据与良率、E3 物理验证、F7 GDS/OASIS 格式。
- 算力与版本:G3 LSF 作业调度、F10 PDK/版本基线。
- 制造常识:芯片制造、工艺节点、GDS/OASIS、良率。
总结
当硅上想要的线宽远小于 193nm 曝光波长,衍射和干涉让掩模直角在晶圆上变圆角、线端缩短、疏密失真,掩模形状不再等于晶圆形状,计算光刻就用「将错就错」的 OPC 把掩模图形反向预扭曲,使它经过光学畸变后恰好印成想要的形状:rule-based 按几何查表快速加偏置、model-based 把每条边切段后在光刻模型里反复成像仿真并挪边直到边缘放置误差收敛,并靠小于分辨率、只调制光场不会被印出的 SRAF 辅助条和锤头补偿改善工艺窗口;先进节点进一步用 SMO 把自由形式光源与掩模联合优化、用 ILT 从目标晶圆图形反求曲线形最优掩模以换取最大工艺容差,而这本质上是全芯片上百亿片段、在 defocus/dose 矩阵里反复做 SOCS 核卷积的巨型优化,单靠 CPU 集群要跑数周,正因成像卷积高度数据并行,GPU 能给数十倍加速、CNN 类 AI 学习掩模逆映射做快速初值,ILT 才随多束电子束写掩模成熟而复兴;但所有 OPC 模型都必须用光刻机、光源、光刻胶和刻蚀偏差等 foundry 实测机密数据标定,按层建模且为掩模厂与 foundry 掌握,设计公司只用 litho-friendly 规则提前规避难印热点——所以计算光刻是工艺数据、超算与物理模型三位一体、壁垒最高的制造侧 EDA,其输出经掩模规则检查和 fracture 转成电子束格式后才能写版、光刻,并由 CD-SEM 量测回标形成持续改进的工艺闭环。