FlashMLA 解码 kernel:KV 压缩后的注意力流水与 Hopper Blackwell 适配剖析
更新时间:2026-10-05。前面 MLA 多头潜在注意力与 KV 压缩 讲清了算法层:DeepSeek-V2/V3 用低秩投影把每个 token 的 KV 压成一个 576 维的潜向量(512 维 content 加 64 维 rope 旁路),KV cache 体积比 MHA 小一个数量级。但算法省下的显存,要靠一个能把压缩格式「就着锅吃」的 kernel 才能变成真实的吞吐——直接拿 FlashAttention 算 MLA,要么先解压把省下的显存又烧回去,要么被 576 维的非标准 head dim 卡在 tensor core 的甜蜜区之外。FlashMLA 解码 kernel 就是 DeepSeek 开源的那个「就着锅吃」的实现:在 H800 上 decode 阶段打到 3000 GB/s 级别的显存带宽利用率,接近硬件上限。本篇逐层拆它:压缩 KV 怎么摆进显存、解码一步的注意力怎么切成流水、分页调度怎么榨干 SM、以及同一套骨架怎么从 Hopper 迁到 Blackwell。
本文要回答的问题
- MLA 解码的算术强度(arithmetic intensity)为什么注定它是纯显存带宽瓶颈,kernel 优化的总目标是什么?
- 压缩后的 KV(576 维潜向量)在显存里怎么布局,为什么「吸收矩阵乘法」让解压彻底消失?
- FlashMLA 的主循环怎么用 TMA 加 wgmma 搭出多 stage 深流水,softmax 藏在哪?
- 分页 KV cache 加 FlashDecoding 式 split 调度,怎么解决 decode 阶段 batch 小、SM 吃不饱的问题?
- 从 Hopper 到 Blackwell,FlashMLA 的哪些部件原样保留、哪些必须重写?
一、MLA 解码的瓶颈画像:每 token 只算两次矩阵乘,却要读 576 维 × 全部历史
先定性能基调。decode 阶段每步只处理一个新 token,对每一层注意力,核心计算是:新 token 的 query 与全部历史 K 算分(一个向量乘矩阵),softmax,再加权求和 V(又一个矩阵乘向量)。这是典型的 GEMV 型负载,算术强度极低——每读一个字节的 KV,只做寥寥几次乘加。这种负载的吞吐天花板不是 tensor core 算力,而是显存带宽,kernel 设计的总目标因此非常单纯:把 KV cache 从 HBM 读到 SM 的这条链路跑到接近满带宽,别的事都给它让路。
MLA 把这个画像改写得很有意思。标准 GQA 的 KV cache 每 token 存 2 × n_kv_head × head_dim 个数;MLA 每 token 只存一个 576 维的潜向量 c_kv(512 维 content 加 64 维 rope 旁路,FP8 或 BF16 存)。以 DeepSeek-V3 的 61 层、10 万 token 上下文算,BF16 下每 token 每层的 KV 只有 1152 字节——是同等能力 MHA 模型的十几分之一。这意味着同样一张 80GB 的卡,能装的上下文长度或并发 batch 直接翻一个数量级。但代价是:query 侧的头数没有被压缩(MLA 的 Q 仍是 128 头 × 576 维等效维度),decode 时 query 这一侧的计算量相对 KV 读量的比值反而变大了,kernel 必须小心别让 Q 侧的计算拖住读带宽。

上图的黄色节点就是全部战场:MLA decode 每秒能出多少 token,几乎完全由「576 维 × 序列长度 × 层数」的数据多快流过 HBM 决定。FlashMLA 在 H800 上测得 3000 GB/s 上下的有效带宽,离 3.35 TB/s 的理论值约九成——对 decode kernel 来说这基本是把硬件榨干了,后面三节就看它是怎么做到的。
把账再算细一点,「带宽唯一论」就更有说服力。以 10 万 token 上下文、BF16 为例,单序列单层注意力的 KV 读量是 576 × 100000 × 2 ≈ 115MB;DeepSeek-V3 有 61 层,完整一步 decode 光 KV 就要读约 7GB。H800 的 3.35 TB/s 理论带宽下,理想下界是每步 2.1 毫秒、约 480 token/s——这还没算权重的读取(权重在 decode 阶段同样是每步全量读一遍,但那属于 GEMM 层的事,不在注意力 kernel 的账上)。反过来,如果 kernel 只能跑到 1500 GB/s,吞吐直接腰斩,任何算力侧的优化都补不回来。这就是为什么 FlashMLA 的全部设计决策都可以归约成一句话:别让 HBM 到 SM 之间有任何一步空转。
二、吸收矩阵与「胖 K」布局:解压从主循环里消失
MLA 压缩格式最自然的用法是「先解压再算」:把 c_kv 乘上解压矩阵 W_UK、W_UV 还原成逐头的 K、V,再走标准注意力。这条路在 decode kernel 里是自杀——解压本身是一次大矩阵乘,读解压矩阵的带宽开销比读 KV 还大,而且解压后的 K、V 体积膨胀十几倍,等于把压缩省下的钱当场花光。
FlashMLA 用的是论文里就埋好的矩阵吸收(absorption)技巧。注意力分数 q · k 展开是 (q_c W_UK^T) · c_kv 的形式:与其把 K 解压出来,不如把 W_UK 吸收进 query 侧——每个请求开始时把 128 个头的 query 一次性乘上 W_UK,得到 128 个 512 维的「投影后 query」,之后整个 decode 主循环里,K 的位置直接站的就是压缩潜向量 c_kv 本身,一次解压都不做。V 侧同理:加权求和的直接结果是一个 512 维的潜向量输出,最后再乘 W_UV(并进输出投影 W_O 里)映射回各头。中间产物全程保持压缩形态。
这个选择的 kernel 后果是:FlashMLA 的「K tile」和「V tile」其实是同一个 576 维向量的两段——QK^T 用全部 576 维(512 content 加 64 rope),V 加权只用前 512 维。于是 KV cache 的显存布局顺理成章:每 token 一条 576 维连续记录,按 token 维度分 tile 加载,前 576 列喂第一个 GEMM,前 512 列喂第二个 GEMM,同一份数据从 HBM 只读一次,两个 GEMM 各取所需。这在 standard attention kernel 里是要分别读 K cache 和 V cache 两遍的,MLA 的压缩格式在这里反而送了一次免费的「KV 合并读取」。
| 方案 | 主循环里 K/V 的形态 | 每 token KV 读取量 | 额外计算 | 结论 |
|---|---|---|---|---|
| 先解压再算 | 还原成 128 头 × 128+64 维 | 膨胀十几倍 | 每层每 token 一次解压 GEMM | 带宽自杀,不可用 |
| 吸收进 query(FlashMLA) | 576 维潜向量原样 | 1152 字节(BF16) | 每步一次 q 投影,摊销近零 | 唯一正道 |

图上黄色 tile 的两条出边是整套设计的题眼:576 列全量进 GEMM1,前 512 列进 GEMM2,解压矩阵从主循环里彻底消失,只在每个 decode 步的边界处露两次脸(q 投影和输出投影),计算量被 batch 摊薄到可以忽略。
还有一个数值细节值得点名:rope 旁路那 64 维只参与打分、不参与 value 加权,所以 tile 的列段切分是「0 到 575 进 GEMM1、0 到 511 进 GEMM2」——两段共享前 512 列的物理数据。这意味着 shared memory 里只需要存一份 576 列的 tile,不存在任何复制;对比 MHA kernel 里 K cache 和 V cache 两份物理副本、两次 HBM 往返,MLA 这一手在带宽账上又省出近一半。把「吸收矩阵」和「列段复用」合在一起看,MLA 的压缩格式在 kernel 层面其实是双重红利:显存容量红利(cache 小十几倍)之外,还附赠每步读取量的红利。
三、主循环流水:TMA 搬 tile、wgmma 算矩阵、softmax 藏进空隙
有了布局,看流水。FlashMLA 的 Hopper 主循环就是 Hopper TMA wgmma 异步流水 那套范式的注意力特化版,但针对 decode 的 GEMV 型负载做了几处关键改造。
第一处改造:Q 常驻寄存器,流水里只流 KV。decode 的 query 是固定的(投影后 128 头 × 576 维,BF16 约 144KB,切到每个 SM 负责的 head 分片后更小),主循环开始前一次性装进寄存器或 shared memory,之后不再搬。流水里唯一流动的是 KV tile——这正好匹配 TMA 的胃口:host 侧为分页 KV cache 编好 tensor map,主循环里生产者 warp 每轮发一条 cp.async.bulk.tensor 搬入下一个 token 块(典型 64 或 128 个 token × 576 列),消费者 warp group 用 wgmma 直读 shared memory 算 QK^T。
第二处改造:softmax 与 GEMM 的硬交叠。MLA decode 的 QK^T 输出形状是「128 头 × 当前 tile token 数」,对每个 token 是一行 128 个分数。FlashMLA 沿用 FlashAttention 显存分块 的在线 softmax——维护 running max 和 running sum,每块算完 rescale 累加器——但把它塞进 wgmma 的异步窗口里:tensor core 在算第 i+1 块的 QK^T 时,CUDA core 同时对第 i 块的分数做 exp、更新 running max、rescale 上一轮的累加器。decode 负载下 softmax 的标量运算量相对读带宽不算小,藏不住就会成为第二瓶颈,这个交叠是带宽利用率能上九成的关键。
第三处改造:两路 wgmma 共用 stage 环。GEMM1 吃 tile 全 576 列,GEMM2 吃前 512 列,两者的输入是同一个 shared memory stage——stage 环的 mbarrier 对账只需管「tile 到了没有」和「tile 被两个 GEMM 都消费完没有」,消费者侧的释放条件要等 GEMM2 收账,比标准 FA 的单消费者多一层 arrive 计数。
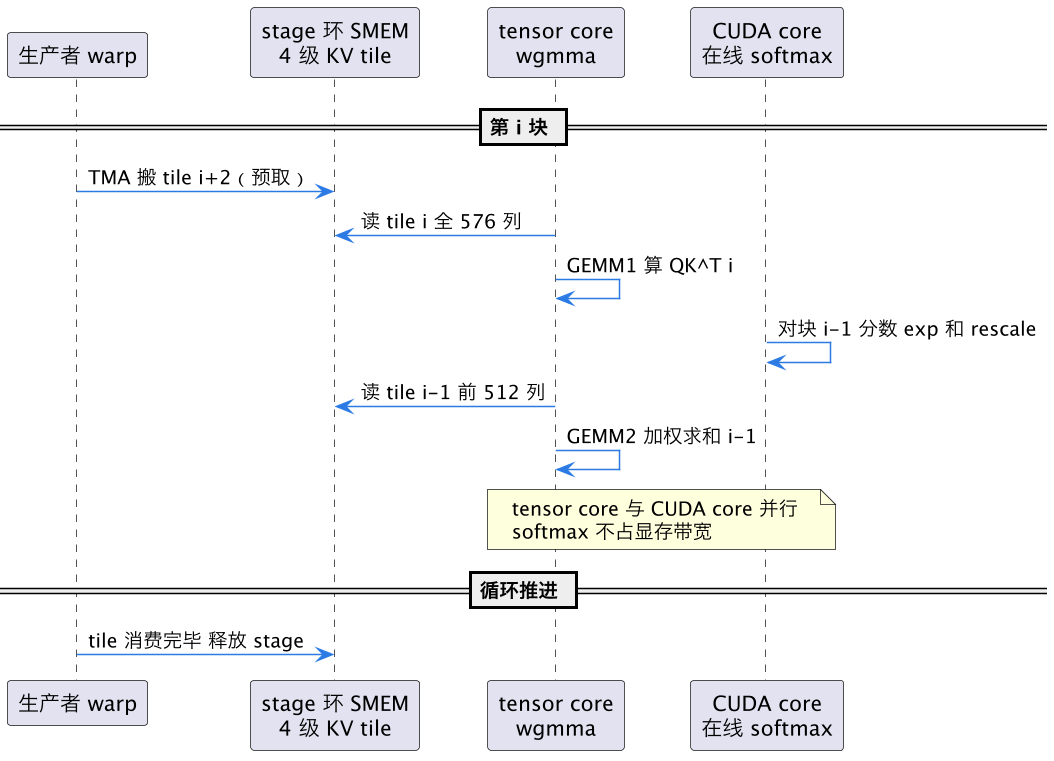
时序图里要读出的核心是三态共存:任何时刻都有一个 tile 在 HBM 路上(TMA 预取)、一个 tile 在 tensor core 上做 GEMM1、一个 tile 的分数在 CUDA core 上做 softmax 加 GEMM2 收尾。stage 环深 4 级左右,HBM 的 600 纳秒级延迟被完全埋在流水深度之下,读带宽曲线拉成一条直线——这就是 3000 GB/s 的微观来源。
资源预算也顺带交代一下。一个 KV tile 按 64 token × 576 列 × 2 字节算是 72KB,4 级 stage 环就要 288KB——超过 H100 单 SM 228KB 的 shared memory 上限,所以实际实现要么把 tile 切窄(32 token 一级)、要么让 GEMM1 和 GEMM2 错峰复用 stage。这个「stage 数 × tile 大小 ≤ SMEM 容量」的不等式,是所有 Hopper 注意力 kernel 共有的紧箍咒,调 tile 形状时每一步都在带宽、延迟隐藏深度和 SMEM 容量之间做三选一。FlashMLA 的选择是偏窄 tile 加偏深流水:decode 场景下 tile 窄不影响 GEMM 效率(本来 K 维就只有 576),而深流水对掩盖 HBM 延迟的收益是线性的。
四、分页调度与 split:小 batch 也要把 132 个 SM 喂饱
单序列 decode 还有一个结构性麻烦:一个请求的 QK^T 沿 token 维天然可并行,但一份 query 只对应一个输出。如果按「一个序列一个 thread block」切,长上下文配小 batch 时(比如 4 个请求 × 10 万 token),H100 的 132 个 SM 只点亮 4 个,带宽利用率跌到个位数百分比。
FlashMLA 的解法是把 注意力解码 split-k FlashDecoding 那套思路与 PagedAttention 分页 KV 的块表机制缝在一起:
- KV cache 按固定页(page)管理,每页若干 token,块表(block table)记录逻辑 token 到物理页的映射——这和 vLLM 生态完全兼容,FlashMLA 的调度器直接吃分页布局;
- 每个序列的 token 维被切成若干 split,每个 split 派一个独立 thread block 去算部分注意力(各自的 running max、running sum 和未归一化输出);
- split 数由调度器按「当前总 block 数够不够填满 SM」动态决定:batch 大就少 split,batch 小就一个序列拆几十份;
- 最后一个小型归并 kernel(combine)把同一序列的所有 split 结果按 log-sum-exp 规则合并成最终输出。

归并的数学不复杂但实现有坑:每个 split 的输出是「未归一化加权和加 running max」,合并时要以全局 max 为基准重缩放再求和,FP16/BF16 下 rescale 的次序会影响尾数精度,FlashMLA 在 combine 里用 FP32 累加兜住。调度器是 host 侧的轻量逻辑,每步 decode 根据 batch 组成和序列长度直方图算一次 split 方案,开销微秒级,换来的是 1 到 512 任意 batch 下 SM 占用率都不塌方。
分页这一侧还有个容易忽略的收益:prefill 与 decode 混合部署(continuous batching)时,新请求的序列长度是参差不齐的,split 方案如果按固定大小切,短序列会浪费整段 block。FlashMLA 的调度器把「剩余 token 数」纳入切分决策,让最后一个 split 吃到的是零头而不是空转——这个细节在压测里值几个百分点的有效带宽,属于 benchmark 打到九成之后还愿意抠的那类优化。
五、从 Hopper 到 Blackwell:骨架不动,三处换引擎
FlashMLA 的 Hopper 版跑稳之后,社区(DeepSeek 官方与 FlashInfer 等)很快把它迁到了 Blackwell(B200/SM100)。对照看,数据布局、吸收矩阵、分页调度、split 归并这四层原样保留——它们是算法和系统层的决策,与微架构无关。真正换的是流水里的三个引擎部件。
| 部件 | Hopper 版 | Blackwell 版 | 变化实质 |
|---|---|---|---|
| 拷贝 | TMA 加 mbarrier 对账 | TMA 保留,支持更大 box 与新 swizzle | 基本零改动 |
| 矩阵乘 | wgmma(128 线程 warp group) | tcgen05.mma(单线程发射,TMEM 累加) | 重写发射与收账 |
| 累加器 | 寄存器堆持有 C | TMEM(tensor memory)持有 C | softmax 数据通路改道 |
| 同步 | mbarrier 相位对账 | mbarrier 保留,加 TMEM 分配释放协议 | 小幅扩展 |
| softmax | CUDA core 读寄存器分数 | CUDA core 经 ld.tmem 读分数 | 指令与延迟特征变 |
最大的范式变化在累加器。Hopper 的 wgmma 把 C 摊在 128 线程的寄存器里,softmax 读分数就是读自己手上的寄存器,零成本。Blackwell 的 tcgen05 把累加器放进了新引入的 TMEM(tensor memory,每 SM 一块 256KB 的片上矩阵存储),分数要从 TMEM 用 tcgen05.ld 显式读回寄存器才能做 exp——softmax 从「顺手的事」变成流水里一段真实的数据搬运,FlashMLA 的 Blackwell 版因此把 softmax 子流水拆得更细:TMEM 读出、exp 与 rescale、新权重写回寄存器喂 GEMM2,三段再叠一层小流水。好消息是 GEMM 粒度更大、发射更省(tcgen05 一条指令顶 wgmma 一组),腾出的发射槽正好匀给这段搬运。

这张图也是本篇想留下的方法论:一个好的 decode kernel,其价值的八成在「不变层」——布局、吸收、调度这些决策跨越架构寿命周期;微架构相关的两成(矩阵乘指令、累加器通路)注定每代硬件重写一次,但因为被压在骨架下面,重写成本是可控的。回头看 FlashAttention 3 的 Hopper FP8 attention 也是同一规律:FA3 的 tile 化与在线 softmax 原样传给了 Blackwell 实现,换的只是流水引擎。
这一篇在知识体系里的位置
本篇是 GPU kernel 剖析系列里「应用层 kernel 深水篇」:算法上游是 MLA 多头潜在注意力与 KV 压缩(压缩格式从哪来);流水地基是 Hopper TMA wgmma 异步流水(TMA、wgmma、mbarrier 三原语)与 FlashAttention 显存分块(在线 softmax 的通用框架);调度层的两个拼接件是 注意力解码 split-k FlashDecoding 和 PagedAttention 分页 KV;同族参照 FlashAttention 3 的 Hopper FP8 attention(prefill 侧的姊妹篇)。读顺本篇后,再去看 FlashMLA 的源码(DeepSeek 官方仓库的 flash_mla 目录),sm90 与 sm100 两套 mainloop 的对应关系会一目了然。
总结
FlashMLA 解码 kernel 把 MLA 的 576 维压缩潜向量当成「胖 K」直接算注意力——用吸收矩阵把解压挪出主循环、KV cache 每 token 只读一次 1152 字节;流水上用 TMA 深 stage 环预取 tile、wgmma 直读 shared memory 连算 QK^T 与加权求和、在线 softmax 藏进 GEMM 的异步窗口,在 H800 上把 decode 跑到约九成显存带宽;调度上靠分页块表加 FlashDecoding 式 split 加 log-sum-exp 归并,让 1 到 512 的任意 batch 都能喂饱全部 SM;迁到 Blackwell 时布局与调度层原样保留,只把 wgmma 加寄存器累加器换成 tcgen05 加 TMEM 并重排 softmax 数据通路——它是「算法压缩红利必须靠专用 kernel 兑现」这一命题的标准范本。