UVM 间接寄存器访问:uvm_reg_indirect_data 的地址+数据两级建模
更新时间:2026-09-29。寄存器模型的整体结构(block/map/reg 三层)见 UVM 寄存器模型:reg_block 与 map 的层次结构,模型怎么接进验证环境见 UVM 寄存器模型集成:adapter、predictor 与显式预测。这一篇解决一个具体痛点:芯片里成百上千个内部寄存器,对外却只暴露一两个总线地址——先写索引、再读写数据的间接访问,寄存器模型该怎么建。
本文要回答的问题
- 什么是间接寻址寄存器,为什么不能用普通的
uvm_reg直接建模? uvm_reg_indirect_data的一次 read/write 在总线上到底发生了什么?configure()里两个寄存器参数(索引寄存器、数据寄存器)各是什么角色?- 间接寄存器的镜像值(mirror)为什么容易失真,怎么预测才对?
- 什么场景该用间接建模,什么场景不如老老实实做地址映射?
一、问题场景:一万个寄存器,一扇门
先还原典型的硬件形态。很多 PHY、SerDes、内部调试模块的设计是:内部有 4096 个 32 位配置寄存器,但挂在 AHB/APB 上的地址空间只留了两个位置——IDX(索引寄存器,写它选内部地址)和 DATA(数据寄存器,读写它即读写被选中的内部寄存器)。软件要先写 IDX = 0x123,再读 DATA 拿到内部 0x123 号寄存器的值。
硬件这么做是出于地址资源考虑:内部阵列动辄几千项,全量映射会把宝贵的总线地址窗撑爆,留两级窗口是经典折中。
这类设计在验证建模时有两个麻烦:一是内部寄存器没有自己的总线地址,普通的 uvm_reg::add_reg(reg, offset) 无从填起;二是一次逻辑访问对应两次总线事务,前门写时序、镜像值更新、predictor 的自动预测全都要跟着变。UVM 为此提供了专门的一对类:uvm_reg_indirect_map(映射策略)与 uvm_reg_indirect_data(寄存器实体),日常只需用到后者。
// 间接寄存器的声明与实例化
class phy_lane_cfg extends uvm_reg_indirect_data;
  `uvm_object_utils(phy_lane_cfg)

  rand uvm_reg_field tx_gain;
  rand uvm_reg_field rx_eq;

  function new(string name = "phy_lane_cfg");
    // 每个间接寄存器都是 32 位、内部 256 个实例的其中一员时,
    // n_bits 仍按单个寄存器的宽度给
    super.new(name, 32, UVM_NO_COVERAGE);
  endfunction

  virtual function void build();
    tx_gain = uvm_reg_field::type_id::create("tx_gain");
    rx_eq   = uvm_reg_field::type_id::create("rx_eq");
    tx_gain.configure(this, 8, 0,  "RW", 0, 8'h00, 1, 1, 0);
    rx_eq  .configure(this, 6, 8,  "RW", 0, 6'h10, 1, 1, 0);
  endfunction
endclass
注意 super.new 的位宽参数仍然指单个内部寄存器的宽度,不是 IDX+DATA 合起来的宽度——这个类描述的是「藏在门后的一员」,门本身另有模型。
二、两级访问:一次 write 拆成两笔总线事务
uvm_reg_indirect_data 的本质是:它没有自己的 map 条目,而是挂在一个特殊 map 上,这个 map 知道「访问它 = 先写 IDX、再碰 DATA」。在 block 里组装:
// reg_block 的 build() 里
idx_reg  = apb_reg_idx ::type_id::create("idx_reg");   // 普通 uvm_reg,offset 0x00
data_reg = apb_reg_data::type_id::create("data_reg");  // 普通 uvm_reg,offset 0x04
lane_cfg = phy_lane_cfg ::type_id::create("lane_cfg");

// 关键一步:configure(索引寄存器, 数据寄存器)
lane_cfg.configure(idx_reg, data_reg);

default_map = create_map("apb_map", 'h0, 4, UVM_LITTLE_ENDIAN);
default_map.add_reg(idx_reg,  'h00, "RW");
default_map.add_reg(data_reg, 'h04, "RW");
// 间接寄存器通过 add_reg 加进 default_map 时,
// uvm 内部会改挂 uvm_reg_indirect_map,不需要手工 new
default_map.add_reg(lane_cfg, 'h00, "RW");  // offset 参数对间接寄存器无实际意义
此后对 lane_cfg 的任何前门访问都会被自动拆成两级。读操作在总线上的真实波形:
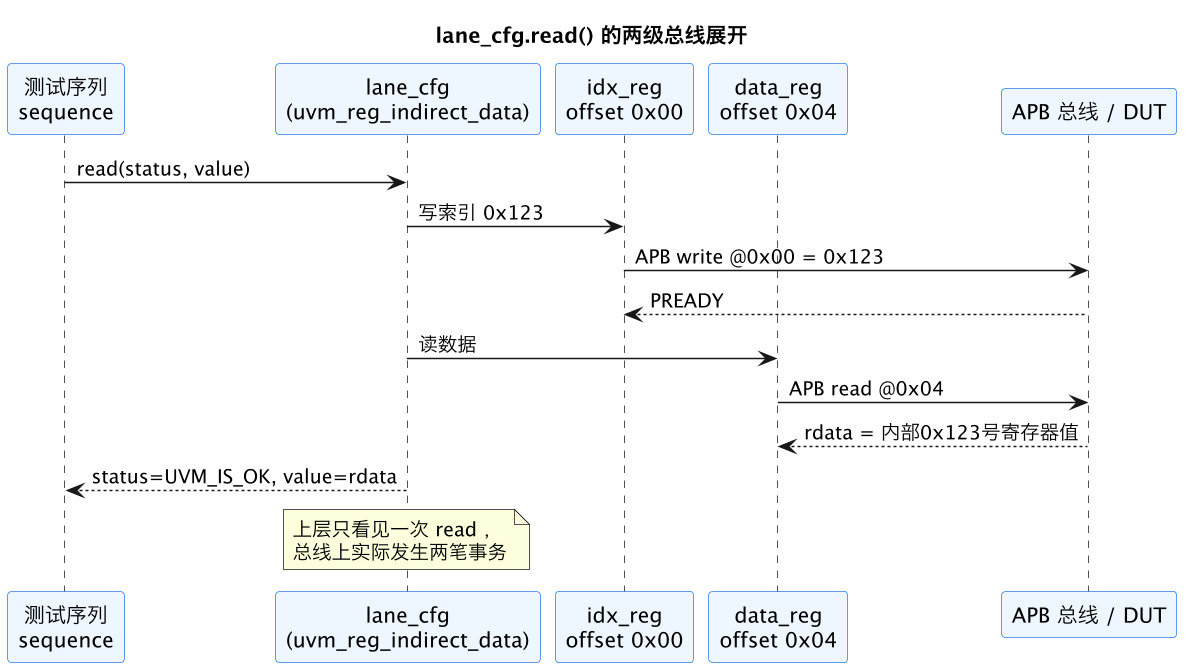
这张图抓两个要点。第一,对调用方完全透明——sequence 里写 lane_cfg.read(status, val) 和访问普通寄存器一模一样,差异被封装在寄存器类内部,这正是用 uvm_reg_indirect_data 而不是「在 sequence 里手写两笔总线事务」的理由:抽象层级保住了。第二,两级访问是两笔独立事务,中间没有原子性保证——如果 DUT 在写 IDX 和读 DATA 之间被另一个主设备抢占总线并改了 IDX,读回来的就是别的寄存器的值。多主场景必须靠 sequence 层的锁(grab/仲裁)来保证这对事务不被插队,寄存器模型自己管不了这件事。
写操作同理,只是第二级变成 APB write:先把目标索引写进 IDX,再把数据写进 DATA。update() / mirror() 等方法也走同一条两级路径,对上层语义不变。
三、镜像值与预测:三个真实踩过的坑
间接寄存器最常见的故障不在访问通路,而在镜像值失真。uvm_reg_indirect_data 的 desired/mirrored 值维护比普通寄存器微妙,三个坑按踩中频率排序:
坑一:predictor 预测不到间接寄存器。 标准的 uvm_reg_predictor 拿到总线 transaction 后,按地址反查 map 找到对应寄存器做预测。可间接寄存器没有独立地址——总线上只有 0x00(IDX)和 0x04(DATA)两笔事务,predictor 只会更新 idx_reg 和 data_reg 的镜像,lane_cfg 的镜像纹丝不动。结果是 lane_cfg.mirror() 或自动 check 拿陈旧镜像比对,报一堆假 mismatch。对策两种:一是关掉这些间接寄存器的自动 check,改为在访问后显式 predict(value);二是自定义 predictor,识别 IDX+DATA 事务对、按 IDX 值路由到具体间接寄存器实例(环境里有几组 indirect map 时这条路几乎绕不开)。
坑二:索引是共享状态,字段值会被「串台」。 假设有 256 个内部寄存器共用一个 IDX/DATA 窗口,你只建了一个 lane_cfg 对象——那 lane_cfg.write(0xA5, .path(...)) 之前必须先有别的机制把 IDX 设对,uvm_reg_indirect_data 并不会替你记住「这个对象对应索引几」。正确姿势是每个索引一个对象实例(循环创建 256 个 lane_cfg[i],各自带独立 desired/mirror),或者用数组型间接寄存器并在 sequence 里显式指定索引。只建一个对象又想访问多个索引,镜像值必然互相覆盖。
还有一个容易忽略的点:自动预测(set_auto_predict(1))下,前门 read/write 会自动更新间接寄存器的 desired 值,但 mirrored 值只在 check 或显式 predict 时更新,两条路径不要混用,否则 update() 会因为 desired 与 mirrored 的差异判断不一致而多写或少写事务。
坑三:reset 与 backdoor 语义。 间接寄存器没有地址,自然没有 backdoor 路径(add_hdl_path 对它无效),peek/poke 用不了,想绕过总线直接读写内部寄存器得改走 idx_reg/data_reg 的 HDL 后门组合。另外 reset() 只清 desired/mirrored,不碰 DUT;内部寄存器的真实复位值往往不等于模型默认值(很多 PHY 寄存器复位值依赖 strap 引脚),上电后务必先做一次全量 mirror(.check(UVM_NO_CHECK)) 同步镜像,否则第一笔 update() 会产生一笔预期之外的写。
间接与直接建模的选型边界可以浓缩成一张表:
| 维度 | 直接映射(普通 uvm_reg) | 间接访问(uvm_reg_indirect_data) |
|---|---|---|
| 硬件形态 | 每个寄存器有独立总线地址 | IDX+DATA 两级窗口,内部寄存器无地址 |
| 总线事务 | 一次访问一笔事务 | 一次访问两笔事务,非原子 |
| predictor | 标准 predictor 直接可用 | 需显式 predict 或自定义预测路由 |
| 镜像粒度 | 一个对象一个地址 | 每个索引一个对象实例才安全 |
| backdoor | 支持 peek/poke | 不直接支持,借 IDX/DATA 组合 |
| 典型场景 | APB/AHB 外设 CSR | PHY/SerDes/调试模块内部大阵列 |
四、一个最小可跑的 sequence 片段
把上面的零件串起来,sequence 层的代码其实朴素:
class lane_cfg_seq extends uvm_sequence;
  `uvm_object_utils(lane_cfg_seq)
  uvm_reg_block regmodel;

  virtual task body();
    uvm_status_e status;
    uvm_reg_data_t val;

    // 配置第 3 条 lane 的 tx_gain
    regmodel.lane_cfg[3].write(status, 32'h0000_103F);

    // 读回校验
    regmodel.lane_cfg[3].read(status, val);
    if (val[7:0] !== 8'h3F)
      `uvm_error("LANE_CFG", $sformatf("tx_gain readback mismatch: %h", val))
  endtask
endclass
注意 sequence 里完全看不到 IDX/DATA 的影子——两级展开发生在 lane_cfg[3] 对象内部。这正是间接建模的价值:测试意图(「配 lane 3 的增益」)和硬件机制(「写 0x00、再碰 0x04」)分离,将来硬件把窗口挪到别的 offset,只改 block 的 add_reg 两行,几十个 sequence 一行不用动。
这一篇在知识体系里的位置
- 上游结构:UVM 寄存器模型:reg_block 与 map 的层次结构 讲清了 block/map/reg 三层与
add_reg的通用机制,本篇的uvm_reg_indirect_map是 map 层的特殊变体。 - 环境集成:UVM 寄存器模型集成:adapter、predictor 与显式预测 定义了 adapter/predictor 的接法,本篇坑一提到的「自定义预测路由」就是在那个框架上扩展。
总结
UVM 间接寄存器访问用 uvm_reg_indirect_data 建模「先写索引、再碰数据」的两级窗口:configure(idx_reg, data_reg) 绑定门和门后的寄存器,一次逻辑 read/write 被自动拆成两笔总线事务且对 sequence 透明;代价是事务非原子、backdoor 不可用、标准 predictor 预测不到——镜像值要靠显式 predict 或自定义预测路由维护,且每个索引应对应一个独立对象实例,搞清这三点,间接寄存器的建模就不会再出镜像失真的假 mismatch。