SAIF 功耗精度:翻转率来源、向量选取与无向量默认值的坑
VCD 与 SAIF 活动率数据流讲过 SAIF 文件本身长什么样、怎么从仿真里导出来;Voltus/RedHawk 功耗签核讲过功耗签核的工具链怎么跑。但工具链再准,喂进去的翻转率不对,出来的功耗数字就是错的——垃圾进垃圾出。SAIF 功耗精度讨论的就是这个「喂进去的东西」到底有多可信:翻转率该从 RTL 仿真还是门级仿真拿?向量怎么选才算「典型工作负载」?实在没有向量时套默认翻转率会偏多远?本篇按这三个来源问题逐层拆解,最后给一张精度分级与验证清单。
本文要回答的问题
- 功耗工具拿到 SAIF 之后做了什么?翻转率的每一个小数点是怎么变成瓦特的?
- RTL 仿真出的 SAIF 和门级仿真出的 SAIF,差在哪几个维度?各适合什么阶段?
- 「典型向量」到底怎么定义?跑一段 boot 代码和跑真实业务流量,功耗数字能差多少?
- 没有向量时工具默认套 0.2 之类的固定翻转率,这个值离真值有多远?哪些模块会被它系统性带偏?
- 工程上怎么验证手上的 SAIF 可不可信?有没有一套可以照做的交叉校验手段?
一、翻转率是怎么变成功耗的:SAIF 在功耗工具里的旅程
动态功耗的基本式是 P = α × C × V² × f:α 是翻转率(toggle rate),C 是负载电容,V 是电压,f 是时钟频率。功耗工具(Voltus、RedHawk、PTPX)手里有精确的 C(来自 SPEF 寄生提取)、精确的 V 和 f(来自工作场景定义),唯独 α 是一个必须外部喂入的变量——这就是 SAIF 的全部职责。
SAIF(Switching Activity Interchange Format,翻转率交换格式)里对每根线网记录两个核心量:T0/T1(停留在 0/1 的时间)和 TC(toggle count,翻转次数)。工具把 TC 除以仿真总时长再归一化到目标时钟频率,就得到这根线的 α。没出现在 SAIF 里的线网怎么办?工具拿已标注的线网做「传播」——用概率模型从输入往输出推,和 无向量与有向量 IR 分析里讲的 vectorless 传播是同一套机制。
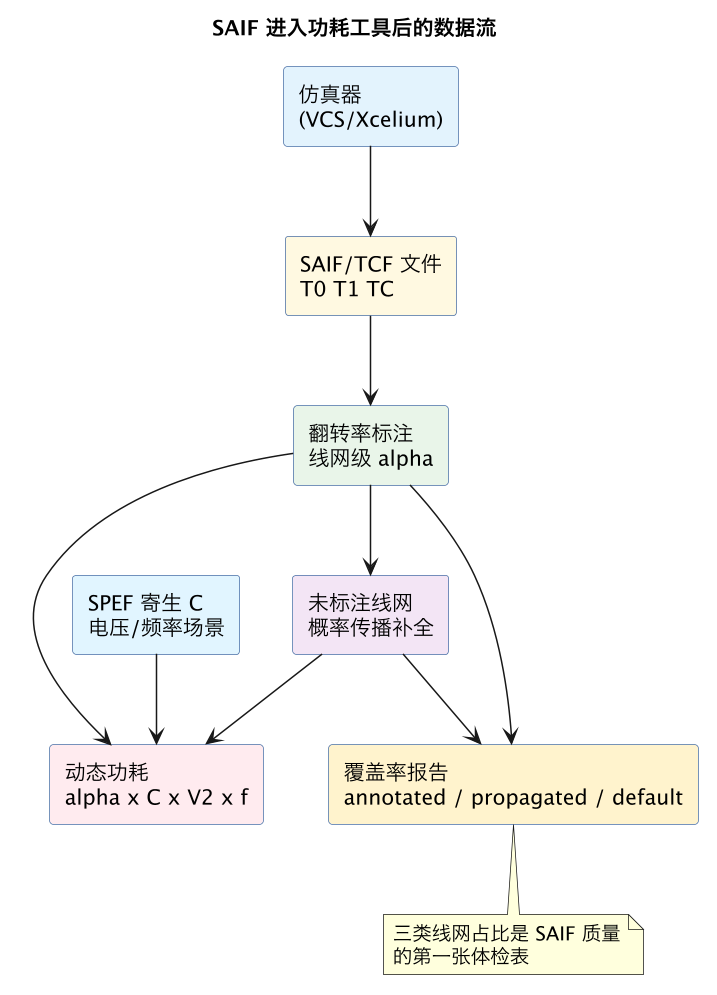
这张图里真正决定 SAIF 功耗精度的是右下那张覆盖率报告:线网分三类——annotated(SAIF 直接标注)、propagated(概率推算)、default(套用全局默认翻转率)。annotated 占比 95% 以上才算健康的 SAIF;如果 propagated 和 default 占了大头,说明你导出的窗口不对、层级没对上,或者仿真根本没跑到那块逻辑。内部功耗(internal power,单元内部的短路功耗与充放电)对翻转率的敏感度比开关功耗还高——查表查的就是输入翻转率和输出负载,α 偏 2 倍内部功耗就偏近 2 倍,没有平摊余地。
二、RTL SAIF 与门级 SAIF:差的不只是「粗细」
同一个测试向量,在 RTL 仿真里导一份 SAIF,在综合后网表仿真里再导一份,两份文件对功耗的预测可能差 20%-40%。差异来自四个结构性来源,理解了它们就知道两份 SAIF 各自的适用边界。
第一,线网数量本身不同。RTL 里一根 assign 经过综合可能变成多级缓冲加逻辑重组,门级网表的线网数是 RTL 信号数的 3-10 倍。RTL SAIF 只能标注到「寄存器和端口语义还能对上」的那部分信号,组合逻辑在门级才被大量标注——这意味着 RTL SAIF 喂给门级功耗分析时,组合逻辑那一大片主要靠传播,精度天然打折。
第二,毛刺(glitch)只有门级仿真看得见。RTL 仿真是零延迟的,一个周期内信号只变一次;真实电路里组合逻辑各输入到达时间不同,输出会在稳定前来回跳几次,这些毛刺是真实的充放电,占总动态功耗的 10%-30%(异或树、乘法器这类逻辑甚至更高)。零延迟 RTL 仿真给出的 TC 永远不含毛刺,用 RTL SAIF 算出来的功耗系统性偏低。
第三,时钟树活动率。RTL 里没有时钟树,时钟被当成理想网络;门级(尤其 post-CTS 网表)里时钟树几十万个 buffer 每拍都在翻,而时钟网络常常占全芯片动态功耗的 30%-40%。RTL SAIF 对这一块零标注,全靠工具按时钟频率补——好在时钟树翻转率几乎恒等于 2(每周期一上一下),补出来的值反而很准,这是 RTL SAIF 少数不吃亏的地方。
第四,命名映射的损耗。RTL 信号名到门级线网名靠综合留下的映射文件(SDC 里的 name mapping 或工具自带的 rename 规则)对账,总有一部分信号因为优化消失(被常量化、被复制、被合并)对不上,这部分就掉进 propagated 桶。
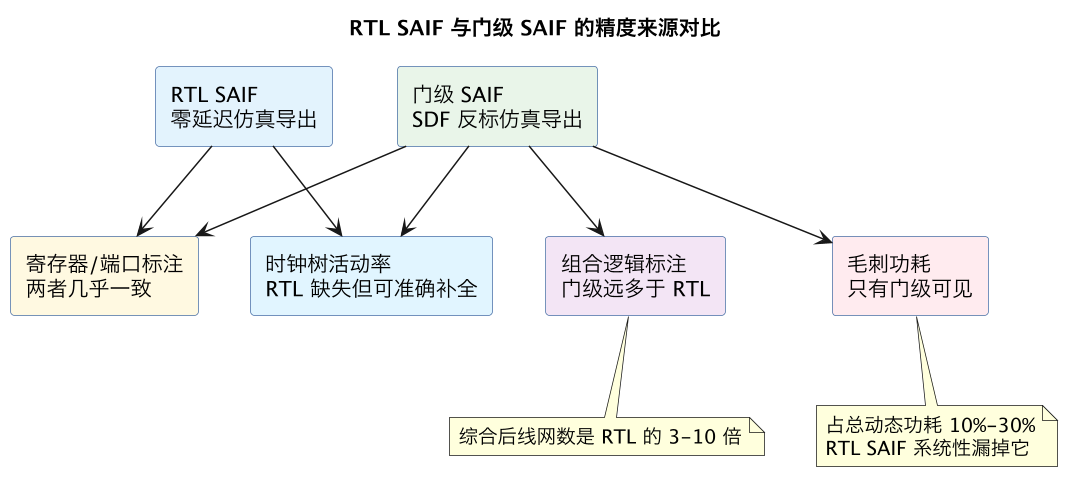
工程上的分工惯例是:架构探索期用 RTL SAIF(仿真快几小时就能出,看模块间相对比例够用),signoff 前的功耗预算定稿必须上门级 SAIF(最好带 SDF 反标,把毛刺也收进来)。拿 RTL SAIF 的绝对值去跟封装散热规格对账,是新手常犯的错——你天然少算了毛刺那一份。
三、向量选取:什么叫「典型工作负载」
SAIF 本身不创造精度,它只是忠实记录了你跑的那段仿真。选错向量比没有向量更危险,因为它会给你一个有零有整的错误数字。
「典型」有三个层次,功耗数字差异巨大:
| 向量类型 | 代表场景 | 翻转率水平 | 典型用途 |
|---|---|---|---|
| 功能验证向量 | 定向测试、随机回归 | 偏低且分布怪(大量 idle 周期) | 验证流程连通性,不适合定功耗 |
| 真实业务流量 | 实际应用 trace 回放 | 最接近真值 | signoff 功耗预算的金标准 |
| 峰值构造向量 | 专门拉满翻转的毒丸测试 | 高于任何真实场景 | IR drop 最坏角、电源网络设计 |
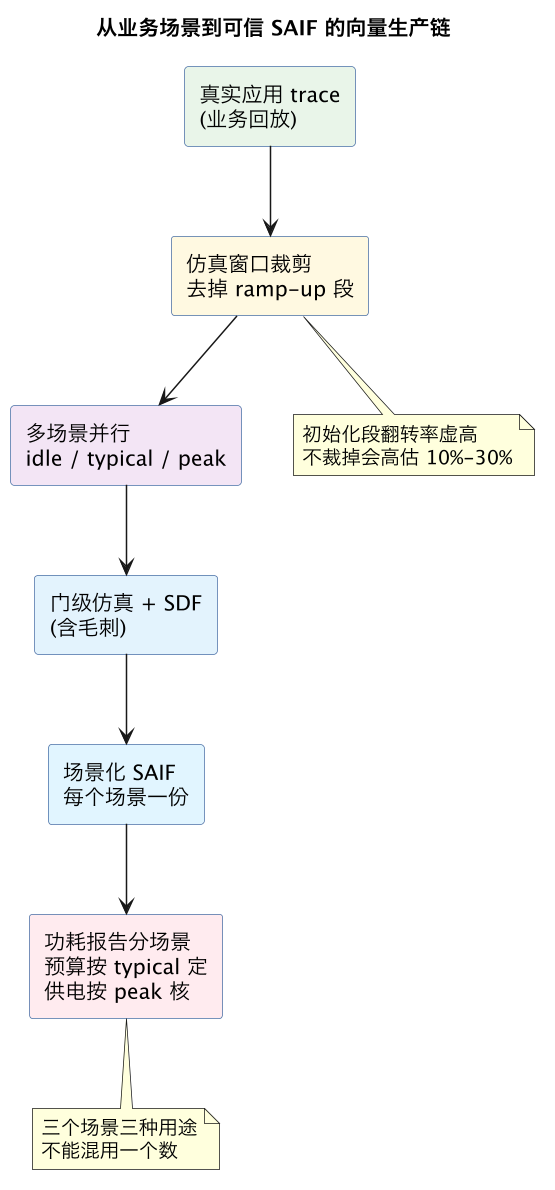
一个直观的数字感受:同一颗网络芯片,跑 idle 保持链路的向量平均翻转率可能只有 0.02,跑满速转发的真实流量约 0.15-0.25,跑构造的 peak 向量能到 0.4 以上——功耗直接差出 5-10 倍。如果你的散热设计按 idle 向量的 SAIF 做,上量后必然过热降频;反过来按 peak 向量做,封装和供电成本又白白多花。这就是为什么 IR 分析里 vectorless 与 vectorbased 之争最终要落到「向量从哪来」。
选取典型向量的实操原则有四条。第一,从真实应用抓 trace,而不是让验证工程师拍脑袋写——手机 SoC 就抓实际应用的指令流,AI 加速卡就抓真实推理 batch。第二,窗口长度要盖过稳态:仿真前几百微秒通常是初始化,寄存器被批量写翻转率虚高,导 SAIF 时要裁掉 ramp-up 段,只取稳定运行窗口(经验上至少几十个完整业务周期)。第三,多场景各导一份:现代芯片没有单一「典型」,待机/中度/满载各一份 SAIF,功耗报告分场景出,这也和 UPF 功耗意图里多 power state 的建模对齐。第四,窗口对齐时钟域:异步时钟域的归一化依赖准确的仿真时长,跨域窗口截断不齐会让慢速域的翻转率被高估。
四、无向量的默认翻转率:方便但充满系统性偏差
项目早期(综合前、甚至只有架构模型时)根本没有仿真可跑,工具提供了 vectorless 模式:给 primary input 和寄存器一个默认翻转率(常见 0.1-0.2),沿逻辑锥逐级概率传播。方便是真方便,坑也是真坑,主要有三类系统性偏差。
第一,默认值抹平了模块间的巨大差异。时钟树翻转率恒为 2,数据通路典型 0.1-0.3,控制逻辑可能低于 0.05,而 memory 的读写使能常常 0.01 都不到。全设计套一个 0.2,等于把控制逻辑高估 4 倍、把时钟相关逻辑低估 10 倍——总量上误差可能部分抵消显得「还行」,但模块级功耗分布完全是错的,而电源网络设计、热点分析恰恰依赖分布。
第二,概率传播不知道相关性。传播模型假设输入独立,真实信号高度相关:一个 32 位总线传地址时高 12 位几乎不动,传数据时各位齐翻。vectorless 对这种结构化行为完全无感,总线类逻辑的翻转率通常被高估,而深度流水线的使能链(clock gating enable 相关性极强)被低估。时钟门控检查里关心的 ICG 效率,在 vectorless 模式下基本测不出来。
第三,它给你一个虚假的信心。vectorless 报告上每个模块都有精确到毫瓦的数字,但这些数字的不确定度可能达到 ±50%。正确的用法是把 vectorless 结果当「相对量级参考」:比较两个架构方案哪个功耗高可以用,拿绝对值去定供电轨设计不行。
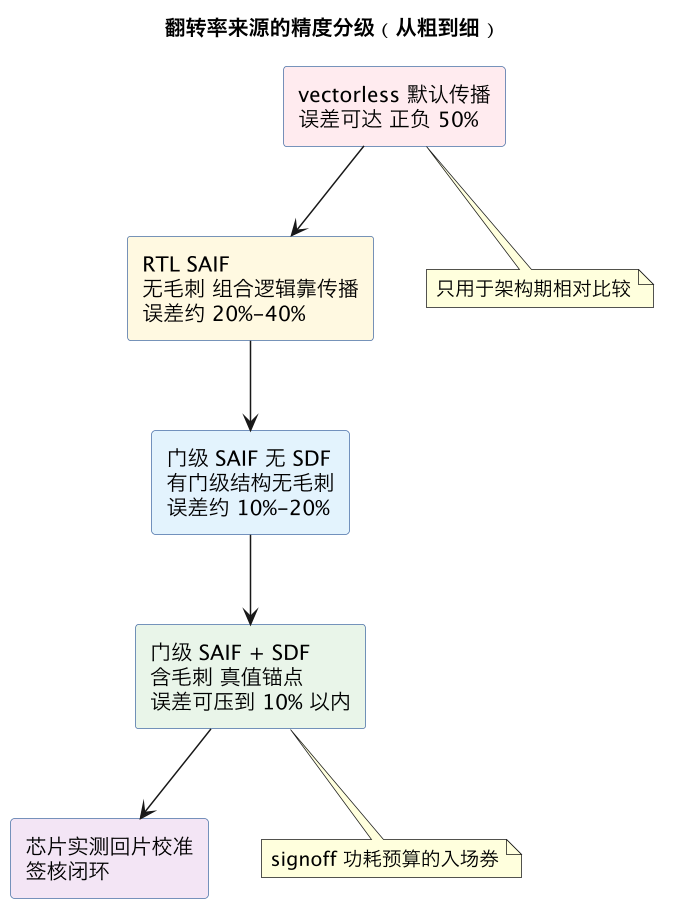
这张分级图值得贴在工作台上:每往下一级,你要付出的仿真成本大约涨一个数量级(RTL 仿真几小时,带 SDF 的门级仿真可能几天),换来的是误差带收窄。项目的成熟节奏应该沿着这条链往下走,而不是停在某一级反复纠结参数。
五、交叉校验:怎么验证手上的 SAIF 可不可信
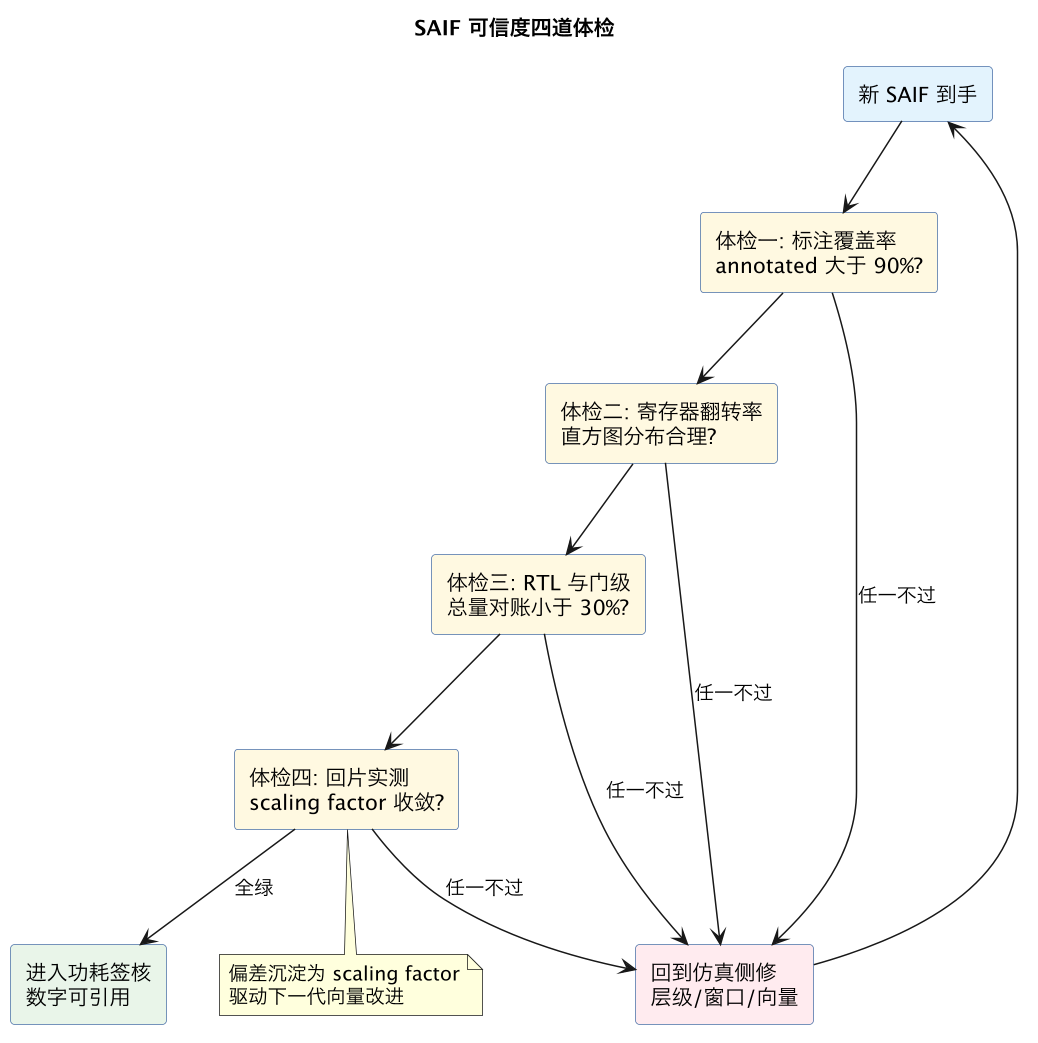
拿到一份 SAIF,先别急着出报告,做四项体检。
其一,看标注覆盖率。annotated 线网占比低于 90% 就要警惕:查是不是导出时层级路径写错、仿真窗口太短、或者 DUT 例化名和功耗工具读的不一致。覆盖率报告里 default 占比高的模块,功耗数字直接标为不可信。
其二,寄存器翻转率分布抽查。把 SAIF 里寄存器 Q 端的翻转率拉个直方图:全设计平均值落在 0.1-0.3 之外(对典型数据通路型设计)就要解释原因;如果出现大量寄存器翻转率精确等于 0 或精确等于默认值,说明它们根本没被仿真激励到。
其三,两份来源对账。同一向量导 RTL SAIF 和门级 SAIF 各算一次,总量差超过 30% 时逐模块找差异最大的那个——通常是毛刺重灾区(宽位运算逻辑)或映射失败区。这一步同时也在校验你的门级仿真环境本身对不对。
其四,回片校准。芯片回来后用片上传感器或电源轨电流实测分场景功耗,和签核报告对账,偏差写进下一版的翻转率 scaling factor。做得好的团队这个 factor 会收敛到 1.0 附近;长期偏离的项目多半不是工具问题,而是向量选取从根上就偏离了真实业务。这条回片反馈闭环也正是 S6 硅反馈在功耗域的落点。
这一篇在知识体系里的位置
- 上游:SAIF 文件格式与导出机制见 VCD 与 SAIF 活动率数据流;翻转率要乘的寄生电容来自 SPEF 寄生提取;多场景划分对齐 UPF 功耗意图。
- 同层:翻转率喂入后的签核工具链见 Voltus/RedHawk 功耗签核;无向量传播机制的取舍见 无向量与有向量 IR 分析;时钟门控效率对活动率的影响见 时钟门控检查。
- 下游:功耗数据的版本管理与跨团队交接见 X4 数据管理;实测回片后的校准闭环见 S6 硅反馈。
总结
SAIF 功耗精度的本质是「翻转率来源的可信度管理」:RTL SAIF 快但漏毛刺、门级加 SDF 的 SAIF 才是 signoff 入场券,向量必须取自真实业务流量并裁掉初始化段,无向量默认翻转率只能做架构期相对比较,任何一份 SAIF 上岗前都要过标注覆盖率、寄存器分布、双源对账、回片校准四道体检——工具链再准,喂错翻转率等于精确地算错。