异步FIFO 满空信号:虚报安全方向论证与两拍保守延迟的吞吐代价
专题导航:异步FIFO设计全景。前置要求:已读支柱页与格雷码跨时钟域原理,了解两级触发器同步器模板。 上一篇:格雷码跨时钟域原理 | 下一篇:亚稳态与 MTBF。 读序说明:本篇是支柱页之后的问题入口——先接受「指针会迟到」这个事实把满空语义想透,再回看格雷码篇的编码实现;若偏好自底向上,也可先读上一篇。配套实验在工程包 derekzhuo/async-fifo-mini 的
tb/tb_full_empty_semantics.v。
本文要回答的问题
- FIFO 里「真实占用」客观存在,为什么两侧看到的满空信号却必然带误差?
- 满报错了有四种方向,为什么只有两种方向能活下来?
- 都说「两拍同步」,为什么实测标志撤销滞后是 3 拍而不是 2 拍?
- 保守标志用多少吞吐换安全,这笔账能不能量化?
- almost-full / almost-empty 的阈值拍数应该怎么定,和同步延迟是什么关系?
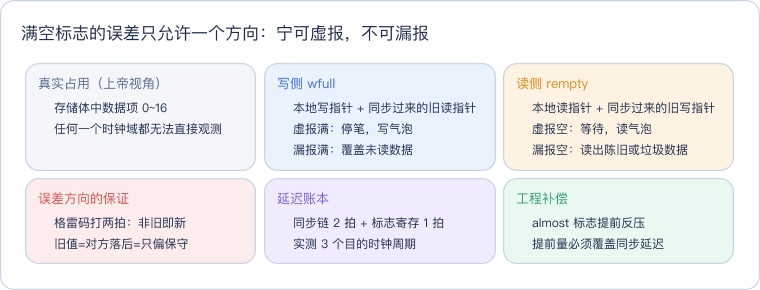
这张概念卡是全文的地图:红色一组是整篇的论证核心——误差不可能消失,但它的方向可以被设计成唯一。支柱页异步FIFO设计全景给了满空比较式,本篇回答比较式背后的语义问题。
一、满和空其实是两个时钟域里的两件事
同步 FIFO 里,满空判断是一道小学数学题:占用 = 写指针 - 读指针,一个时钟沿后两边都更新,比较结果就是真值。异步 FIFO 里这道题做不成,因为写侧看不到读指针的现在时,读侧也看不到写指针的现在时。两侧各自握有两类材料:本侧指针的当前值(甚至下一拍的预测值),以及对方指针经两级触发器同步过来的旧值。

读图抓一个对称结构:蓝色写指针、橙色读指针是各侧的「第一手材料」,灰色同步链是对方的「二手旧闻」,红色两个比较器是误差最终现形的地方。数据本身从不跨域,跨域的只有指针;于是满空信号回答的从来不是「现在空不空」,而是「按我手头最新的对方指针算,空不空」。这两句话之间的时间差,就是本篇全部讨论的源头。
RTL 里的两段比较式值得逐字读:
wire [ADDR_WIDTH:0] wbin_next  = wbin  + (winc  & ~wfull);
wire [ADDR_WIDTH:0] wgray_next = (wbin_next >> 1) ^ wbin_next;

always @(posedge wclk or negedge wrst_n)
    if (!wrst_n) wfull <= 0;
    else wfull <= (wgray_next == {~rgray_wsync2[ADDR_WIDTH:ADDR_WIDTH-1],
                                   rgray_wsync2[ADDR_WIDTH-2:0]});
满判定拿的是 wgray_next——本侧下一拍的指针值,而不是当前值。这个细节决定了延迟账本的算法:本地自己的前进不需要等,组合逻辑提前算好;三个周期的欠账全部记在跨域的那两级同步和标志寄存器上。空判定对称,rempty <= (rgray_next == wgray_rsync2),复位时它被预置为 1(上电默认空,这本身也是保守方向)。
二、四种报错方向,只有两种不毁数据
标志和真值不一致有四种组合,先把后果摆清楚:
| 误差方向 | 触发场景 | 电路反应 | 后果性质 |
|---|---|---|---|
| 虚报满(实际未满报满) | 读侧刚取走数据,写侧还不知道 | 写请求被门控一拍 | 吞吐损失(写气泡),数据完好 |
| 漏报满(实际已满报未满) | 同步值夸大了读侧进度 | 第 17 个写被接受 | 覆盖未读数据,不可恢复 |
| 虚报空(实际未空报空) | 写侧刚放入数据,读侧还不知道 | 读请求被门控一拍 | 吞吐损失(读气泡),数据完好 |
| 漏报空(实际已空报未空) | 同步值夸大了写侧进度 | 读指针越过写指针 | 读出陈旧数据/重复数据,不可恢复 |
结论先行:虚报只损失带宽,漏报损失数据。一个正确的异步 FIFO 设计,必须在结构上保证误差只落在第一、三象限,而不是靠运气。
这个保证由「格雷码 + 两拍同步」共同给出,机制在格雷码跨时钟域原理里有完整反证,这里只取对满空语义关键的一环:目的沿无论落在什么时刻,同步链输出的值非旧即新,绝不可能是一个谁也没发送过的值。再进一步,两级触发器只锁存、不预测,所以它输出的值在时间方向上只能是「旧」——对方已经走到了 B,我手头最坏还是 A。旧读指针意味着什么?写侧以为读得比实际慢,以为 FIFO 比实际更满,于是提前报满;旧写指针则让读侧以为写得比实际慢,以为 FIFO 比实际更空,于是迟迟不报非空。两侧的误差因此被钉死在保守方向。
反过来就能回答「为什么二进制满空判定在跨时钟域下不可用」。它有两层问题。第一层是格雷码篇实测过的:011→100 多位同翻时,偏斜窗口里采到的可能是 000、110 等非法值,比较器直接指向不存在的占用状态。第二层即使所有采样值都合法仍然成立:二进制中间值可大可小——011→100 途中采到 000 是偏小(虚报方向,还好),采到 111 就是偏大(漏报方向,毁数据)。误差方向不随编码单调,任何比较结果都不具安全保证。多位信号不能直接打拍的更一般讨论见多位信号为什么不能直接打拍。
三、说是两拍同步,为什么实测欠了三拍
理论说够了,上实验。深度 16 的标准工程,写时钟 10ns(100MHz)、读时钟 17ns(约 59MHz),两者无整数倍关系,刻意做成真异步。testbench 内部维护一份软件参考队列作为「上帝视角」的真实占用,每个时钟沿同时记录三件事:标志与真值是否一致、请求被挡时属于真满反压还是虚报气泡、读出数据与参考队列逐拍核对。
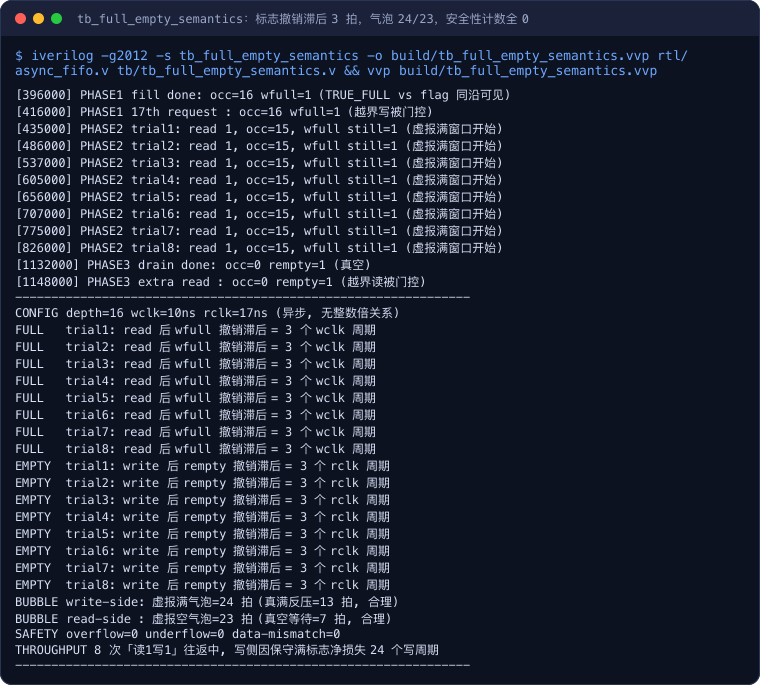
终端卡上半段是过程证据:填满 16 个后 wfull 与真实满同沿可见,第 17 个请求被门控;阶段 2 每次读走 1 个后,wfull 都仍然顽固地为 1——虚报满窗口开始。下半段是八轮统计:满标志撤销滞后稳定为 3 个 wclk 周期,空标志撤销滞后为 3 个 rclk 周期(按沿对齐不同,逐拍气泡计数 24 对 23,个别轮次落在 2 拍)。
三拍的账这样算。以读侧取走一个数据为例:第 0 拍 rclk 沿上读指针更新,rgray 变为新值;新值要等接下来的第一个 wclk 沿才进第一级同步器,最坏要等将近整整一个写周期——这是第 1 拍,相位欠账;再过一个 wclk 沿到第二级,第 2 拍,同步欠账;满判定是时序逻辑(wfull <= ...),比较结果还要再等一个 wclk 沿才输出,第 3 拍,寄存欠账。注意 wgray_next 的预测式写法已经替本地运动付清了一拍,否则账上还会再多一项。空侧完全对称。
下面的波形把三拍欠账画在空侧:写沿接受数据后 wgray 变为 G1,该值依次穿过两级读侧触发器,rempty 在第三个 rclk 沿之后才撤下。
读这张波形只看一件事:数据在第二个 wclk 沿就已经躺在存储体里了(真实非空),但读侧要到 wgray_rsync2 拿到 G1、再经空比较寄存器输出后,rempty 才拉低。G1 斜穿两个时钟域的这段路,就是读者请求被白白挡住的时间。两级同步器为什么恰好是两级而不是一级或三级,失效率的量级在两级同步器 MTBF 实测展开。
四、气泡的吞吐账:8 轮往返损失 24 和 23 个周期
保守不是免费的,终端卡最下面四行就是价格。八轮「读 1 个、写侧补 1 个」往返中,写侧在确实已有空位的情况下仍被虚报满挡住 24 个写周期(平均每轮 3 拍,和滞后测量完全对上);反向实验里读侧在确实已有数据的情况下被虚报空挡住 23 个读周期。另有 13 个写周期、7 个读周期挡得有理有据——那是真满/真空下的正常反压,统计时单独记账,没有混进气泡数字。
| 指标 | 写侧(wfull) | 读侧(rempty) |
|---|---|---|
| 标志撤销滞后 | 3 个 wclk 周期,8/8 轮稳定 | 3 个 rclk 周期(按沿对齐偶现 2 拍) |
| 保守气泡(虚报挡下的请求) | 24 拍 / 8 轮 | 23 拍 / 8 轮 |
| 正常反压(真值挡下的请求) | 13 拍 | 7 拍 |
| 溢出 / 读空 / 数据错配 | 0 / 0 / 0 | 0 / 0 / 0 |
把单价翻译成带宽直觉:若两侧时钟同频且持续满载,每发生一次「读一个、补一个」的临界操作,补位要晚 3 个周期,临界区附近的瞬时写带宽只剩四分之一。FIFO 大部分时间工作在远离满空边界的区间,这笔税只在边界附近征收,所以宏观吞吐损失通常远小于此——但在深度很浅、读写速率接近、流量突发频繁的设计里,三拍气泡会周期性出现,深度计算时不能假装满空标志零延迟。支柱页对深度与突发的工程估算有展开,配套的深度算法实验见 FIFO 深度计算实测。
安全性那一行零才是整张表的主角:实验全程软件参考队列逐拍比对,一次溢出、一次读空、一个错数据都没有发生——不是因为激励温和,而是即使在最不利的沿对齐下,误差结构上也到不了漏报象限。
五、almost-full 与 almost-empty:用阈值买回延迟
既然欠账是固定的三拍,工程上的标准对策是把反压提前:增加 almost-full / almost-empty 标志,在「还剩 N 个空位/数据项」时就拉起,让对方在标志真实生效前提前动作。阈值拍数的关系可以直接写成一条不等式。
| 阈值设置 | 行为 | 评价 |
|---|---|---|
| 提前量 < 同步延迟折算拍数 | 临界时反压晚到,仍可能顶到真满边界丢数据 | 错误,阈值失去意义 |
| 提前量 ≈ 延迟拍数 × 速率比 | 反压恰好抵消同步欠账 | 正确但无裕量,时钟有抖动时贴边 |
| 延迟折算 + 1~2 拍裕量 | 覆盖相位欠账与频率漂移 | 工程推荐,代价是少量容量不可见 |
| 阈值过大(如深度的一半) | 大面积容量被保守冻结 | 安全但浪费 RAM,FIFO 等效变浅 |
折算方向要特别注意:almost-full 服务于写侧决策,但它缓解的是读指针跨到写域的延迟,因此提前量要按「同步期间写侧还能写入多少拍」折算,即 N ≥ (2 + 1) × T_r / T_w 再向上取整加裕量;读快写慢时这个系数小于 1,写快读慢时它会大于 1。almost-empty 对称,折算的是写指针跨到读域期间读侧的消耗拍数。阈值设计的完整扫描与反压气泡曲线在后续 almost 阈值专题展开;FIFO 在工程里被误用、标志方向搞反的真实案例,汇总在异步FIFO 常见坑点排查。
顺带回答一个评审常被问到的备选方案:同步链能不能加成三级、四级来换更低的亚稳态失效率?可以,失效率确实指数下降,但每加一级,满空撤销滞后和气泡单价线性多一拍,almost 阈值也得跟着重算。安全和带宽在这根链条上直接兑换,没有白拿的一级寄存器。异步 FIFO 的完整可综合模板见异步 FIFO Verilog 模板。
代码获取:实验平台在独立仓库 derekzhuo/async-fifo-mini 的 tb 目录,克隆后执行 iverilog -g2012 -s tb_full_empty_semantics -o build/x.vvp rtl/async_fifo.v tb/tb_full_empty_semantics.v && vvp build/x.vvp 即可复现本文全部输出;本机需安装 Icarus Verilog。
实验环境
- 机器/系统:Mac(Intel)/ macOS,本机原生执行(未使用容器)
- 工具版本:Icarus Verilog 13.0(stable)
- 日期:2026-11-03
- 完整命令:
iverilog -g2012 -s tb_full_empty_semantics -o build/tb_full_empty_semantics.vvp rtl/async_fifo.v tb/tb_full_empty_semantics.v && vvp build/tb_full_empty_semantics.vvp - 原始记录:本文终端卡内嵌的 35 行输出即完整原始记录,实验源码见上述工程包
这一篇在知识体系里的位置
本篇是异步FIFO 专题原理段的第二篇,在支柱页异步FIFO设计全景给出的满空比较式之上追问其语义安全性。上承格雷码跨时钟域原理的「非旧即新」结论,把「旧」字翻译成满空两侧的误差方向;跨域单 bit 的物理根基是两级触发器同步器模板。下一篇亚稳态与 MTBF回答欠账表中「两级」这个数字本身的由来:格雷码为什么不能替代打拍、多打一级失效率怎么变。
总结
异步FIFO 满空信号本质上是两侧用对方指针的旧值做的比较,误差无法消除但方向可以设计:格雷码保证跨域值非旧即新,旧值让两侧都只可能把 FIFO 看得比实际更挤——虚报满与虚报空只产生气泡,漏报才会覆盖或读空。实测深度 16、读写异步的工程,标志撤销滞后固定 3 拍(相位、两级同步、标志寄存各一笔),8 轮临界往返征收 24 和 23 个气泡周期,换得溢出、读空、数据错配全程为零;almost 标志用覆盖同步延迟的提前量把这笔税提前兑回,代价是少量容量被保守冻结。