优先编码器验证:全组合枚举、X 输入处理与优先级违例检查的完整做法
更新时间:2026-09-30。优先编码器(priority encoder)是数字芯片里最小却最容易被轻视的组合逻辑模块:N 个请求输入进来,输出优先级最高的那一路的编号。中断控制器选最高优先级中断、仲裁器选最高优先级请求、缓存替换选牺牲路,背后都是它。模块小到经常被一句
casez写完,验证也常被一句「不就查个表」带过——结果上线后发现 X 输入传播、默认输出和 valid 关系没定义清楚,整片返工。这一篇按入门篇的深度,把优先编码器验证从「能不能全枚举」讲起,落到 X 输入处理和优先级违例检查三件实事上。前置的断言与覆盖基础可先看 SVA 断言实践 与 代码功能覆盖。
本文要回答的问题
- 优先编码器的输入空间有多大,什么位宽下可以全组合枚举、什么时候必须换策略?
- 输入带 X(未知态)时输出应该是什么,规范没写清楚时验证怎么推进?
- 「优先级违例」具体指什么 bug,用断言怎么逐拍守住?
- 输出编码、valid 标志和输入请求三者的对应关系,参考模型怎么写才独立可信?
一、先钉死接口与优先级约定
验证前先和设计把三件事对齐,少一件后面全是白验。第一,输入 req[N-1:0] 哪一 bit 优先级最高——是 bit 0 最高还是 bit N-1 最高,行业里两种都有,testbench 里写反了,所有检查全反。第二,输出是什么:多数设计给一对信号,grant_id(二进制编码的编号,宽度 clog2(N))加 valid(有请求时为 1);有的设计直接给独热(one-hot)输出 grant[N-1:0],一个 bit 对应一路。第三,无请求时 grant_id 输出什么——保持上次的值、输出全零、还是不关心(don't care),必须写进规范,因为断言和参考模型都要拿它当预期。
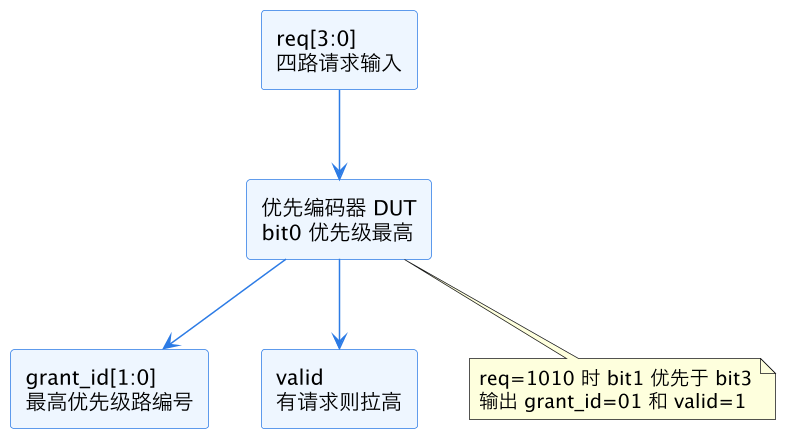
这张图就是独热仲裁的核心语义:四路请求同时到达,编码器只看优先级最高的那一路,其余的一律忽略。注意它是纯组合逻辑——没有时钟、没有状态、没有记忆,同一个输入永远得到同一个输出。这一点决定了它的验证策略和时序模块完全不同:不需要长序列、不需要状态机覆盖,关键是把输入空间扫干净。
二、全组合枚举:什么时候值得做、什么时候做不起
纯组合模块最大的福利是:输入空间是有限的,理论上可以穷举。N 位输入就是 2^N 种组合,每种组合的预期输出可以离线算好,逐个比对。这就是全组合枚举(exhaustive enumeration)。
| 输入位宽 N | 组合数 2^N | 枚举可行性 |
|---|---|---|
| 4 | 16 | 定向逐条写都行 |
| 8 | 256 | 一个循环几秒钟跑完 |
| 16 | 65536 | 依然轻松,必做 |
| 32 | 约 43 亿 | 仿真跑不完,放弃枚举 |
| 64 | 天文数字 | 只能靠断言加随机加形式 |
经验分界线大致在 N=24 到 N=28 之间:2^24 约 1700 万,仿真里一个 for 循环逐拍驱动其实也能跑,只是回归时间开始变长;超过 32 位就彻底不用想枚举了。中断控制器常见 32 路、64 路甚至更多,恰好落在「枚举不起」的区间,所以优先编码器验证的真实场景大多是后者——但只要是 16 位以内的小编码器,不做全枚举说不过去,这是成本最低的 100% 输入覆盖。
枚举的写法非常朴素,重要的是参考模型必须独立于 RTL 实现,用行为级描述另算一遍预期:
// 参考模型:从优先级最低的 bit 往高扫,最后命中的就是最高优先级
function automatic int ref_encode(logic [N-1:0] r);
  int id = -1;
  for (int i = N-1; i >= 0; i--)
    if (r[i]) id = i;   // bit0 优先级最高时,低 index 后写覆盖
  return id;
endfunction

initial begin
  for (longint v = 0; v < (1 << N); v++) begin
    req = v[N-1:0];
    #1;
    if (ref_encode(req) == -1)
      check(valid == 0, "no-req must deassert valid");
    else
      check(valid == 1 && grant_id == ref_encode(req), "encode mismatch");
  end
end
注意参考模型故意用和设计不同的写法:RTL 里常见 casez 或优先级 if-else 链,参考模型就用循环扫描。两边写法和思路都不一样,才能抓实现 bug;如果参考模型照抄 RTL 的 casez 表,那叫自我印证,一个错两处犯。
三、X 输入处理:验证里最常被跳过的一节
数字仿真里信号除了 0 和 1,还有 X(未知)和 Z(高阻)。上电瞬间、跨时钟域采样亚稳态、未初始化的寄存器输出,都可能把 X 打到优先编码器的输入上。问题随之而来:输入里混着 X,输出应该是什么?
这件事没有天然正确的答案,只有「规范说了算」。常见的三种约定,验证方法各不相同:
- X 当 0 处理:
casez写法天然如此,X 位被通配符吞掉。验证要检查:输入含 X 的每个组合,输出等于「把 X 替换为 0 后」的预期。这要求参考模型显式做 X 掩码,不能让 X 直接参与比较——===全等比较碰上 X 会全部失败。 - X 传播到输出:有些设计要求输出也带 X,强迫下游暴露问题。验证用
===检查输出确实为 X,并且 X 的位置符合预期。 - 规范没写:最常见的现状。这时验证的正确动作不是猜,而是把问题抛回设计评审——没定义的行为就是潜在的硅后 bug,X 传播到
grant_id后被下游当真实编号用,选中一个根本没请求的设备,这种故障在门级仿真或 X-propagation 仿真里才会冒出来,详见 门级仿真与 SDF 时序。
工程上的实用检查是两条断言:一是输入全 0/1(无 X)时输出绝不允许出现 X,用 !$isunknown({grant_id, valid}) 逐拍守;二是 valid 为 1 时 grant_id 必须是确定值。第二条尤其重要——X 出现在 valid 上最多误触发一次,出现在 id 上是选错路,严重度高一个量级。
// 输入确定时,输出必须确定
a_no_x_out: assert property (@(posedge clk) disable iff (!rst_n)
  !$isunknown(req) |-> !$isunknown({valid, grant_id}));

// valid 拉高时,id 必须指向一个真正在请求的 bit
a_id_points_to_req: assert property (@(posedge clk) disable iff (!rst_n)
  valid |-> req[grant_id] === 1'b1);
四、优先级违例检查:这个模块唯一的功能性 bug 类型
优先编码器能犯的功能错误其实只有一类:选中的不是优先级最高的那一路。细分下来三种形态:选了优先级较低的路(真违例)、选了没请求的路(幻觉 grant)、有请求却不给 valid(漏报)。后两条上一节的断言已经守住,真违例需要一条专门的性质:被选中的路之下(低优先级侧)允许有任意请求,之上(高优先级侧)必须一个请求都没有。
写成断言就是:对每一个可能的输出 id k,凡是比 k 优先级高的 bit 必须全为 0。bit0 最高优先的约定下:
// grant_id=k 成立时,req[k-1:0] 必须全零(bit0 优先级最高)
property p_no_higher_req;
  int k;
  @(posedge clk) disable iff (!rst_n)
  (valid, k = grant_id) |-> (req & ((1 << k) - 1)) == '0;
endproperty
a_priority_no_violation: assert property(p_no_higher_req);
这条断言是优先编码器验证的灵魂:它不关心参考模型怎么写、不关心设计内部怎么实现,只陈述「输出必须满足优先级序」这个规范本身。即使 N=64 枚举不起,这条断言在随机激励下逐拍检查,配合「每个 bit 单独请求」「相邻 bit 同时请求」「全部同时请求」三类定向序列,优先级逻辑基本无处遁形。
枚举不起的大位宽场景,激励要有结构偏向:纯随机的 64 位请求向量几乎必然全为 1 附近,低优先级的组合很难出现。定向构造 sparse(稀疏)请求——每次只拉高一两个 bit,让高优先级侧经常为空,才能真正压到违例检查的边界。覆盖上至少收「被选中 id 的全部分布」和「最高有效请求 bit 位置」两个 coverpoint,确认每一路都当过赢家,边界路(bit0 和 bit N-1)单独 bin。
五、常见坑
- 优先级方向没和设计对齐就开写,testbench 整个做反,回归全绿但验的是镜像规范。
- 参考模型照抄 RTL 的
casez表,变成自我印证,实现 bug 两边一起犯。 - 用
==比较含 X 信号,结果永远是 X 导致检查静默失效,含 X 场景必须用===或先掩码。 - 大位宽用纯随机激励,高优先级侧永远有请求,低优先级路径和违例边界根本压不到。
- 无请求时
grant_id的输出值没写进规范,断言和 scoreboard 各猜各的,评审时吵不出结论。 - 只验 valid/id 忘了下游:id 被下游当索引用,X 或越界 id 的下游后果要在系统集成层面再过一遍。
这一篇在知识体系里的位置
- 向上承接:SVA 断言实践 提供本文全部断言的语法基础,代码功能覆盖 支撑覆盖点设计。
- 横向相关:优先编码器是仲裁器的内核,带状态和公平性要求的完整仲裁器验法见 仲裁器验证;X 传播在门级阶段的系统性验法见 门级仿真与 SDF 时序。
- 向下延伸:位宽大到枚举和随机都吃力时,交给形式工具做属性证明,见 形式验证基础。
总结
优先编码器验证的核心是三件事:位宽 16 以内做全组合枚举、用独立写法的参考模型逐值比对;X 输入的行为必须逼设计写进规范,断言守住「输入确定则输出确定、valid 高则 id 指向真实请求」;优先级违例用一条「被选中路的高优先级侧必须全零」的断言逐拍把守,大位宽场景配合稀疏定向激励和每路必中覆盖,这个小模块就能验得干净彻底。