resource DB 与 config DB:UVM 两套配置数据库的继承关系、通配匹配与优先级差异
更新时间:2026-09-30。在 UVM config object 与 resource_db 里,我们把 config object 的组织方式讲过一遍;在 UVM config_db 通配符作用域 里,又专门拆了 inst_name 的匹配规则。这两篇都默认你已经知道:UVM 里其实存在两套配置数据库——
uvm_resource_db和uvm_config_db。新人最常问的问题是「两个都能 set/get,到底该用哪个」。这一篇把 resource DB 与 config DB 摆在一起对比:谁继承谁、匹配语义差在哪、多条记录抢一个键时各按什么规则裁决。
本文要回答的问题
uvm_config_db和uvm_resource_db在源码里是什么关系,为什么说 config_db 是 resource_db 的「封装」?- 两套 API 的 set/get 参数列表差在哪,
uvm_resource_db缺掉的那个参数意味着什么? - 两边都能写
*通配吗,匹配引擎是不是同一个? - 同一个键被 set 多次,resource_db 的「按类型排队」和 config_db 的「按路径具体度排序」分别怎么裁?
- 工程上哪些场景必须用 config_db,哪些场景用 resource_db 反而更干净?
一、源码里的关系:config_db 站在 resource_db 肩上
打开 UVM 源码(uvm_config_db.svh),uvm_config_db #(T) 的全部 set/get 都只是几行转发:它把 cntxt 和 inst_name 拼成一条实例路径,然后调用 uvm_resource_db #(T)::set(scope, field, value, accessor) 或对应的 get。也就是说,resource_db 是底层仓库,config_db 是上面那层「以组件为中心」的语法糖。
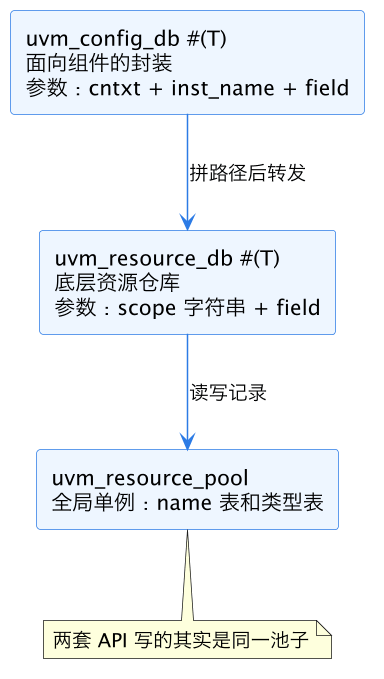
这张图最关键的一点是:两者共享同一个 resource pool。你用 uvm_config_db::set 塞进去的 virtual interface,理论上能被 uvm_resource_db::get_by_name 用同一串路径取出来——因为底下是同一张表。理解这一点,后面所有差异都只是「API 帮你做了什么、没帮你做什么」的问题。
二、API 差异:config_db 多给的和一个隐藏参数
把两个 set 签名并排看:
// config_db:组件视角
uvm_config_db #(T)::set(uvm_component cntxt, string inst_name,
                        string field_name, T value);
// resource_db:字符串视角
uvm_resource_db #(T)::set(string scope, string name,
                          T value, uvm_object accessor = null);
差异有三处,每一处都对应一类坑:
| 维度 | config_db | resource_db |
|---|---|---|
| 路径表达 | cntxt 句柄 + inst_name,自动拼全名 | 一整串 scope,自己写全 |
| 写错 cntxt 的风险 | 编译期就能发现(类型不对) | scope 是字符串,错了静默落空 |
| accessor 参数 | 内部自动传 cntxt | 默认 null,需手动传才计入审计 |
| 典型用途 | 组件间传配置对象、vif | 模块域塞 vif、全局常量、跨层直写 |
resource_db 的 accessor 参数值得一提:它是「谁写的」记录,配合 +UVM_RESOURCE_DB_TRACE 能打出写入方。config_db 转发时自动把 cntxt 填进去,所以 config_db 的审计信息天生更全。用裸 resource_db 又懒得传 accessor,出问题时日志里就只有一条来路不明的记录。
三、通配匹配:同一引擎,不同默认姿势
两边底层都用同一套 glob 匹配器——* 匹配任意长度任意字符(可跨 . 层级)、? 匹配单字符,细节见 UVM config_db 通配符作用域 第二节。差异在使用姿势上:
- config_db 的 inst_name 几乎总是带通配(
"*"、"env.agent*"),因为它的设计目标就是「一条 set 广播到子树」; - resource_db 的经典用法则相反,社区约定俗成是全名字符串精确写:
uvm_resource_db #(virtual dut_if)::set("uvm_test_top.env.agent1.*", "vif", if0)这种带星号的写法虽然合法,但 resource_db 的高频场景其实是set("uvm_test_top", "vif", ...)加一个组件在固定点read_by_name取——点对点,不广播。
换句话说,通配能力两边都有,但 config_db 的 cntxt 机制「诱导」你写相对模式,resource_db 的裸字符串「诱导」你写绝对全名。混用时事故率最高的姿势是:在 resource_db 里写了半截相对路径(忘了 resource_db 不会帮你拼 cntxt),记录挂在一个不存在的短 scope 下,get 方永远落空。
还有一个细节容易被忽略:resource_db 的 set 默认允许 scope 里带通配,但它的姊妹函数 set_anonymous(不显式给 scope,写到调用方名字的写法)生成的 scope 取自 get_full_name() 的字面结果,本身不含通配。也就是说 resource_db 家族内部也有「广播型」和「点名型」两种性格,读别人代码时看到 set_anonymous 要意识到这条记录只对一个确切位置可见,指望它覆盖子树是会落空的。
四、优先级裁决:同一个键被抢的时候谁赢
多套记录命中同一个查找键时,两层的裁决逻辑也共享同一套 precedence 机制:路径模式越具体,优先级越高;同等具体时后 set 覆盖先 set。这一点 config_db 一文已详述。但 resource_db 多了一个 config_db 用户很少意识到的维度——按类型分桶。
resource pool 内部既按 scope+name 建索引,也按类型建一张队列表(uvm_resource_types::rtype_q)。uvm_resource_db #(T)::get_by_type 这种 API 完全无视 scope,只按类型取最近写入的那条。这就引出一个 resource_db 独有的坑:
// 顶层 module A
uvm_resource_db #(virtual dut_if)::set("scope_a", "vif", if_a);
// 顶层 module B(同一仿真、多 testbench 拼接场景)
uvm_resource_db #(virtual dut_if)::set("scope_b", "vif", if_b);
两条记录 scope 不同、互不覆盖,按 name 查井水不犯河水。但任何一处调用 get_by_type(...) 拿到的都是后 set 的那条——类型队列是全局的。单 testbench 项目几乎碰不到,多顶层拼接或引入第三方 VIP 时会突然咬人。
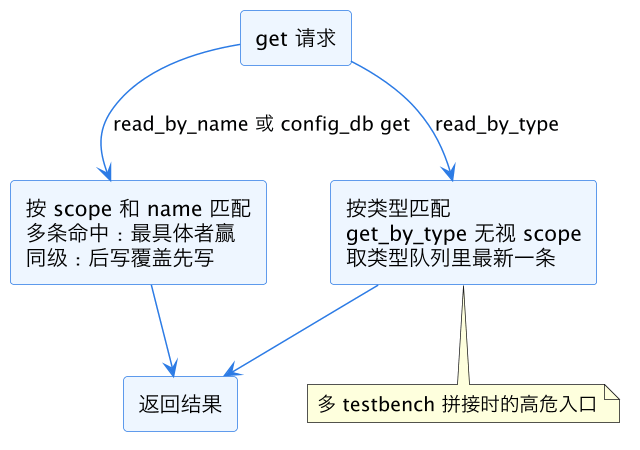
对照这张图记:config_db 用户走左边这条路,裁决看路径具体度;resource_db 还多开右边这扇门,裁决只看写入顺序。两扇门的规则不一样,排查「取到了错误的值」时先确认取方走的是哪扇门。
再补一个和读操作相关的冷知识:read_by_name 和 read_by_type 失败时返回空句柄而不报错,这正是 resource_db 比 config_db「安静」的地方——config_db 的 get 至少返回 bit 让你可以 if(!get(...)) uvm_fatal(...),resource_db 的 read 系列连这个返回值都没有,防御性检查要自己写 if (rsrc == null)`。团队规范里如果允许直接用 resource_db 的 read 系列,务必配套一条「取完必须判空」的硬规矩。
五、工程选型:什么时候用哪套
把前面的差异收敛成几条可直接执行的约定:
- 组件树内传配置,一律 config_db。配置对象、开关量、agent 模式下发,都从 test/env 的 build_phase 用
set(this, ...)发,下层组件get(this, "", ...)收。cntxt 句柄帮你拼路径、自动填 accessor,审计和类型检查都是白送的。 - 模块域向类域递 virtual interface,用 resource_db 或 config_db 的 null 写法。顶层 module 里没有
this,两个等价写法:uvm_config_db #(virtual dut_if)::set(null, "uvm_test_top.*", "vif", if0)或uvm_resource_db #(virtual dut_if)::set("uvm_test_top.*", "vif", if0, null)。团队内部统一选一种,不要混。 - 全局常量、与组件树无关的查找表,用 resource_db。比如回归时由脚本注入的全局种子表、跨 testbench 的共享句柄——它们没有 cntxt 可挂,硬套 config_db 的
set(null, ...)反而绕。 - 审计要求高的项目,accessor 别省。裸 resource_db 调用把第四个参数传上,TRACE 日志里每条记录都有写入方,「谁在覆盖我」三分钟定位。
最后补一个混用时的检查习惯:如果环境里两套 API 都在用(引入的 VIP 用 resource_db、自家 env 用 config_db 是常态),排查配置问题第一步先跑一遍带 +UVM_RESOURCE_DB_TRACE 的冒烟——它打的是底层池子的全量访问,两套 API 的写入都在里面,比 +UVM_CONFIG_DB_TRACE 覆盖面更全。打开日志后先搜 set 记录确认写入确实发生,再搜对应字段的 get 记录看命中了哪一条,两步就能把「没写进去」和「写进去但被别的记录压住」这两类故障分开。
这一篇在知识体系里的位置
- 向上承接:UVM config object 与 resource_db 讲配置对象怎么组织,本篇把两套数据库本身的差异讲透。
- 横向同族:UVM config_db 通配符作用域 专攻 inst_name 匹配细节,本文第三节是它在双库视角下的简版。
- 骨架背景:UVM 组件与 phase 提供组件树模型,理解 cntxt 拼路径的前提。
- 落地延伸:SystemVerilog virtual interface 重配置 和 AXI UVM 环境搭建 里能看到 vif 经资源库下发的完整链路。
总结
resource DB 与 config DB 是同一个资源池的两层接口:config_db 在 resource_db 之上,多做了「cntxt 拼路径」和「自动填 accessor」两件事,组件间配置下发用它最稳;resource_db 是裸字符串 scope 的底层入口,模块域塞 vif、全局常量、跨 testbench 共享走它更干净——通配引擎两边相同、路径裁决都是「越具体越优先」,但 resource_db 独有按类型取数的入口只看写入顺序不看 scope,多顶层场景要格外当心。