LVS 器件识别:从图形到器件,再到网表比对的完整链路
Calibre 物理验证总览把 DRC、LVS、ANT、PERC 放在同一张签核地图上,chip-design 专家线的 DRC/LVS 篇讲了物理验证在整个 tapeout 流程中的位置。本篇往下一层钻:LVS 跑一次到底在干什么?很多人以为 LVS 就是「比对两个网表」,其实那只是后半场。前半场——器件识别(device recognition)与连通性提取(connectivity extraction)——才是大多数诡异报错的真正发源地。看懂这两阶段的分工,mismatch 报告里每一行字才有意义。
本文要回答的问题
- LVS 为什么必须先从图形里「认出」器件,而不是直接比对 GDS 和网表?
- 器件识别阶段提取了哪些信息?MOS、电阻、电容、二极管各自靠什么图形特征被认出来?
- 识别(extraction)与比对(compare)两阶段各产什么报告?报错该先看哪一份?
- device mismatch、instance mismatch、net mismatch 各自指向什么根因?有没有一套可复用的定位套路?
一、为什么 LVS 要从「认器件」开始
原理图网表(schematic netlist,SPICE/CDL 格式)里的世界是符号化的:M1 d g s b nch w=0.1u l=0.03u 一行就是一个 NMOS,属性齐全。而 GDS 版图的世界的纯粹几何的——一堆图层上的多边形,没有任何一处写着「这里是栅极」「那里是源极」。要让这两个世界对上话,必须有人把几何翻译成符号,这个翻译器就是 LVS 的提取阶段。
这个翻译难在哪?难在器件是图形的空间组合,不是单个图形。一个 MOS 管在版图上只是 poly 层和 active(扩散)层的一次交叉,再加上 contact、metal1 把源漏引出来;一个 nwell 电阻是 nwell 层上一段被两个端头夹住的区域,还要扣除 sti 的干扰;MIM 电容靠一张专门的 marker 层(cap 标识层)声明「上下极板之间的区域是电容」。工具必须按规则文件(rule deck)里定义的「图形运算配方」逐类扫描版图,把满足配方的区域抽出来,赋予器件类型、端口和参数,剩下的金属与通孔则归并为线网(net)。
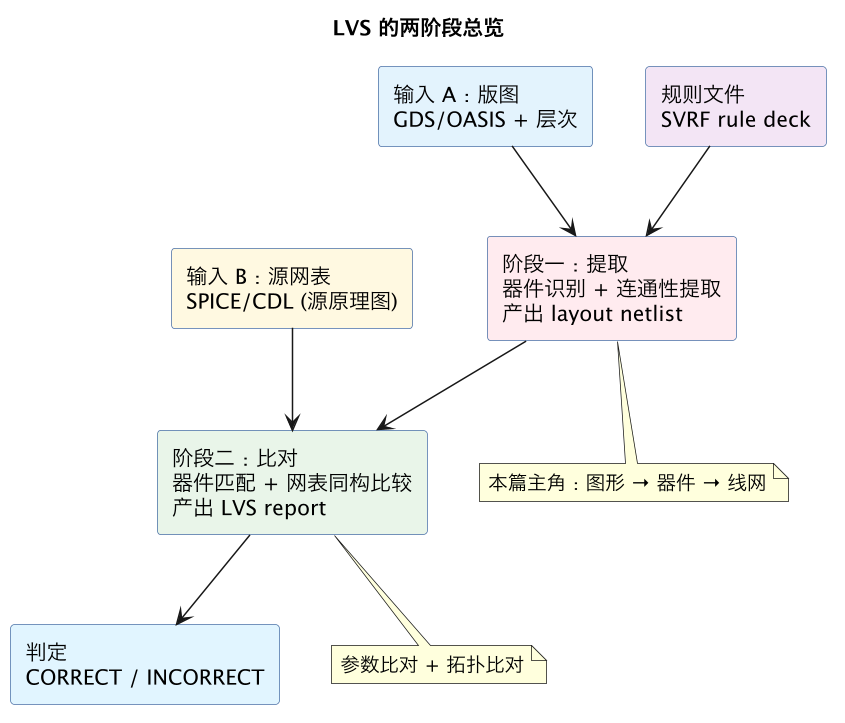
这张图里最重要的一个事实是:LVS report 里绝大多数报错是阶段一的产物。器件没被认出来、参数算错、线网连错,都会以「比对不一致」的形式出现在阶段二的报告里,但根因在阶段一。所以排查 LVS 的第一条纪律是:看到 INCORRECT 先别急着比网表,先翻提取阶段的报告(Calibre 里是 extraction 段与 lvs.report 前半部分,含 extraction messages/warnings)。
二、器件识别:图形配方怎么把多边形变成器件
器件识别的引擎是图形布尔运算。规则文件里每类器件都有一段配方,以 Calibre SVRF 风格示意一个 NMOS 的识别逻辑:
// 伪 SVRF:NMOS 识别配方
nwell_not  = NOT chip_extent nwell        // p 型衬底区域
gate       = AND poly active              // poly 与 active 交叉 = 栅
nsd        = AND active nplus             // n+ 注入的扩散区
sd_nmos    = AND nsd nwell_not            // 落在 p 衬底上的 n 扩散 = 源/漏
body_nmos  = nwell_not                    // 体端 = 衬底
DEVICE MN(nch) gate(G) sd_nmos(S) sd_nmos(D) body_nmos(B)
  [ property w, l: w = width(gate), l = length(gate) ]
工具按这个配方扫描全图:每一处 poly 与 active 的交叉都生成一个 MN 器件实例,交叉区的宽度方向量出 W、电流方向量出 L,交叉两侧的扩散区分别是 S 和 D,衬底是 B。其它器件同理,但配方各有侧重:
| 器件 | 核心图形特征 | 提取的关键参数 | 常见识别陷阱 |
|---|---|---|---|
| MOS | poly 交 active | W、L、指条数 fingers | dummy poly 交叉误识别;串并连接拆分 |
| 电阻 | 电阻层 + marker(rpo/电阻标识层) | R 值(方块数 × 方块电阻) | marker 层漏画导致电阻被当导线短路 |
| MIM/MOM 电容 | cap marker 层夹住的上下极板 | C 值 | marker 与极板对不齐,容值偏差 |
| 二极管 | p+/nwell 或 n+/psub 结区 | 结面积、周长 | 寄生二极管遍地都是,需 marker 或层次约束过滤 |
| BJT | 发射/基/集电三层套叠 | 发射区面积 | latch-up 相关的寄生 BJT 被误抽 |
两个工程细节值得单独说。其一是marker 层(识别标识层)的地位:模拟版图里大量器件靠人工画的 marker 层声明身份——电阻层本身也是导体,没有 rpo 层把它「罩住」,LVS 就会把这段电阻当成一根普通导线,源漏直接短路,报出来的错是「net mismatch」,根因却是器件没识别。其二是参数提取的单位与口径:W/L 是按绘制图形量出来的几何尺寸,与原理图的符号参数比对时容差由规则文件里的 property tolerance 控制;先进节点还有 LOD(长度扩散效应)、WPE(阱邻近效应)相关参数要不要提取、要不要参与比对,都是 rule deck 里逐条开关的。
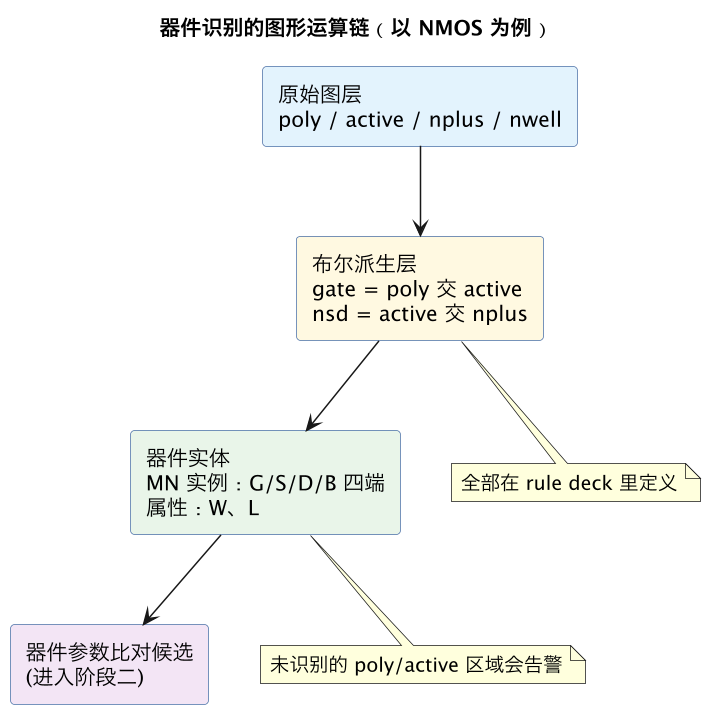
识别阶段的输出除了器件实例清单,还有一串「未消费图形」告警:版图上存在 poly 与 active 的交叉却没形成合法器件(比如交叉区被 marker 层排除、或落在文本标注的 dummy 区),这类 warning 在 tapeout 前必须清零或逐条 waive——它往往指向漏画 marker 或器件拼版错误。
举一个真实感强的例子:模拟版图里常见的共质心(common-centroid)差分对,两只 MOS 被拆成四段、八段交叉排布,中间还插着 dummy 指条。如果 rule deck 没把 dummy 指条的排除区域定义对,识别结果会从「两个多指条 MOS」变成「五个 MOS」,比对直接报 instance mismatch;更隐蔽的情况是 dummy 指条被错误识别成一个悬空栅的 MOS——它一端电学上无连接,比对时表现为「多出来的器件挂在某条内部网上」,光看 net mismatch 根本想不到根因是一根 dummy poly。所以模拟模块的 LVS 通过率高度依赖器件识别配方与版图惯例(dummy 画法、guard ring 画法、marker 使用习惯)的匹配程度,这也是为什么代工厂会随 PDK 发布经过验证的 LVS rule deck,而不鼓励设计公司自己改写识别语句——改一行布尔配方,影响面是全库所有器件的识别口径。
三、连通性提取:器件认出来之后,线网怎么连
器件识别只解决了「有哪些元件」,阶段一还有另一半工作:连通性提取(connectivity extraction)——把 metal1、via1、metal2…… 这些导电层按物理接触关系归并成线网,给每条线网一个内部编号,并把器件端口挂到线网上。归并规则由 rule deck 的 CONNECT 语句定义,比如 CONNECT metal1 poly BY contact、CONNECT metal2 metal1 BY via1。
这一步有几个直接影响比对结果的机制:
- 文本标注(text/label):线网默认只有编号,没有名字。版图工程师在关键节点打的 text label(如
VDD、out)会把名字绑到线网上,阶段二靠名字做初始配对,名字错了会直接导致「正确连接的线网被当成两条」; - 电源地的全局处理:
VDD/VSS通常通过 text 声明为全局网,tie-high/tie-low 单元、well tap 的连接都依赖它,全局网声明漏了会爆出成片的 power net mismatch; - 层次化提取(hierarchical extraction):大规模设计按 cell 逐层提取,子 cell 内部的线网在顶层只暴露 pin。Calibre 的 hcell 机制允许指定「这个 cell 在比对时按黑盒对待」,hcell 列表配错(比如版图和原理图两侧黑盒集合不一致)是层次化 LVS 的经典翻车点。
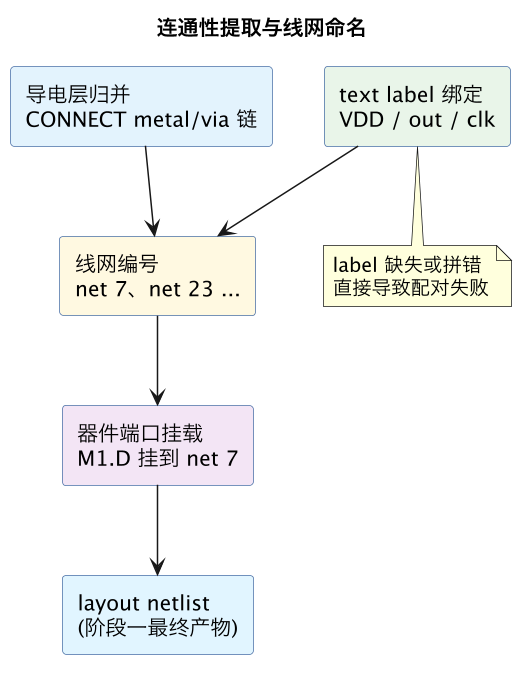
阶段一跑完后,Calibre 会输出一份 layout netlist(通常 SPICE 格式,扩展名如 .spi 或在 svdb 目录里)。这份网表是阶段二唯一的版图侧输入——养成「INCORRECT 时先 diff 这份网表和源网表」的习惯,比在 RVE 图形界面里漫无目的地点要高产得多。
四、比对阶段:器件匹配与拓扑同构
阶段二拿两份网表(layout 提取版 vs schematic 源版)做图同构比较。流程是先做器件匹配:按器件类型和参数(W/L、R、C)在容差内找一一对应;再做线网匹配:从用户给的对应点(顶层端口名、label)出发,沿连接关系逐网扩张,验证两边的邻接关系完全一致。全部对上输出 CORRECT,任何一处对不上输出 INCORRECT 并给出差异清单。
比对报告里的差异分三大类,每一类的根因域完全不同:
| 报错类型 | 报告里的典型字样 | 含义 | 高频根因 |
|---|---|---|---|
| instance/device mismatch | Incorrect Devices / Missing Instances | 器件数量、类型或参数对不上 | 器件没识别(marker 漏画)、参数超容差、finger 合并口径不同 |
| net mismatch | Incorrect Nets / Missing Nets | 线网数量或连接关系对不上 | short(两条网连一起)、open(该连没连)、label 拼错 |
| port mismatch | Missing Ports | 层次边界 pin 不一致 | cell 接口增删后两侧没同步 |
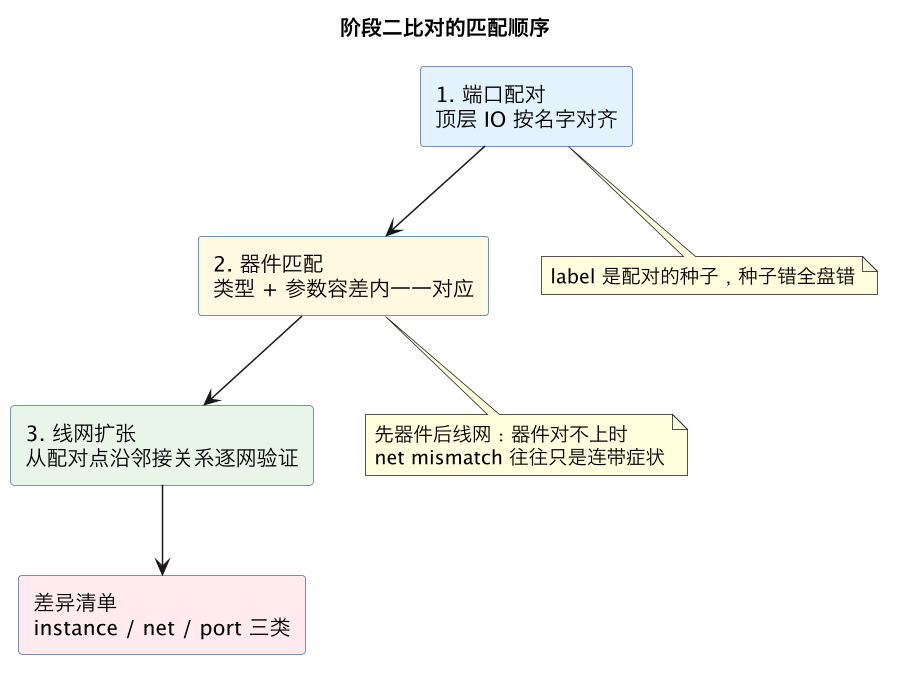
这张图解释了报告阅读顺序的依据:比对是自顶向下、先器件后线网的,所以报告要倒着因果看、顺着工序修——先修 instance mismatch(它通常是根因),很多 net mismatch 会随之消失;一上来就追 net mismatch,很可能在修一个由器件缺失派生出来的假问题。
五、常见 mismatch 类型与定位套路
把上百次真实 LVS debug 的经验压缩成一张决策表:
| 症状 | 第一眼判断 | 定位动作 |
|---|---|---|
| Missing Devices 全是某类电阻/电容 | marker 层问题 | 检查对应 marker 层是否存在于版图、rule deck 的识别语句是否引用了正确层号 |
| 某 MOS 参数 mismatch(W 或 L 不符) | 参数提取口径 | 看容差设置;查 finger 拆分/合并规则(merge 选项)两侧是否一致 |
| 大量 net mismatch 集中在电源域 | 全局网声明 | 查 text label 与 power net 声明(LVS SPICE 全局声明)是否齐全 |
| 只有两三条 net 交叉 | 典型 short 或 open | 用 RVE 高亮两条报错网,差异点通常在 via 缺失或金属搭桥处,见 LVS 短路定位 |
| 子模块全绿、顶层 INCORRECT | 层次接口问题 | 查 hcell 列表两侧一致性、顶层 pin 与 cell port 名字映射 |
| 器件数成倍差异 | 器件拆分口径 | 查串并联识别(parallel/series merge)开关;一个并接器件在两侧一边合并一边拆开就会这样 |
| 提取阶段大量 warning | 别进入比对分析 | 先清 extraction warning,比对结果不可信 |
定位时的通用工序是四步。第一步,读 extraction 段的 warning,器件识别失败的痕迹都在这里,清零或 waive 之前不要相信任何比对结论。第二步,看报告头统计:两边各识别出多少器件、多少线网,数量差本身就有指向性——layout 侧器件明显偏少指向识别漏抽,偏多指向 dummy 结构被误抽。第三步,按上一节的顺序先修 instance,再修 net;RVE 里点一条 mismatch,工具会把版图高亮到出问题的图形上,几何位置比 net 编号更有信息量。第四步,善用缩小复现:把报错的子 cell 单独跑 LVS(hcell 黑盒化其余部分),运行时间从小时级缩到分钟级,迭代修错效率高一个数量级。
再补一条时间预算的经验:全芯片扁平化(flat)LVS 在先进节点动辄跑十几小时,而层次化 LVS 配合增量重跑可以把单个子模块的迭代压到十几分钟。收敛期的正确姿势是「子模块层次化跑绿 → 顶层只做接口与拼接比对」,而不是每次改一根线都全芯片扁平重跑——后者既慢又会把层次化能隔离的问题搅成一团,报错定位难度指数级上升。
还有两个容易被忽视的配置坑。其一是 filter/reduce 选项:rule deck 里通常会把源漏短接的 MOS、fill 电容等「不影响功能」的器件过滤掉再比对,原理图侧如果有对应器件而过滤开关两侧不一致,就会凭空报 mismatch。其二是 网表预处理:原理图导出的 CDL 里常见的 *.PININFO、$.subckt 注释、大小写敏感性(SPICE 传统上不分大小写)都可能影响比对,LVS 工具的 LVS SPICE 读入选项里对应开关要和交付网表的风格对齐。这类「两边其实都对、口径没对齐」的假错,在跨团队交接(设计方与后端方)时尤其高发——交接契约里应写明 LVS 配置与网表风格,属于数据管理的一部分。
六、把器件识别放进签核大局
LVS 器件识别不是孤立环节:它的规则文件与 DRC waiver 管理共用同一套 rule deck 基线,layer map 的版本必须与代工厂 PDK 冻结版本一致,否则同一版图换一版 rule deck 识别结果就会漂移。提取出的 layout netlist 还是寄生提取(PEX)的输入——器件识别阶段的端口定义直接决定 PEX 反标时器件端子能不能对上,识别口径不稳,下游 SPEF 寄生提取和仿真反标全部跟着晃。签核收敛期的纪律因此是:rule deck 版本冻结、LVS 配置项纳入评审、extraction warning 与 INCORRECT 一样计入 tapeout 门禁。
这一篇在知识体系里的位置
- 总览篇:Calibre 物理验证讲 DRC/LVS/ANT/PERC 的全家福与签核位次;本篇深入 LVS 内部的两阶段机制。
- 姊妹 debug 篇:LVS 短路定位专治 net mismatch 里的 short/open 类,本篇则覆盖器件识别与参数类 mismatch。
- 横向对照:chip-design 专家线 DRC/LVS 篇从流程视角看物理验证,本篇从工具机制视角看 LVS。
- 下游:识别产物喂给 SPEF 寄生提取;规则基线与 DRC waiver 管理、PDK 版本基线共享冻结纪律。
总结
LVS 器件识别是「图形到符号」的翻译:rule deck 里的图形布尔配方先把 poly 交 active、marker 罩电阻这类空间组合认成 MOS、电阻、电容并量出 W/L/R/C,连通性提取再把金属链归并成带名字的线网,两份工序合成 layout netlist 后才进入与源网表的比对;排查 INCORRECT 的铁律是先清提取 warning、按 instance→net→port 的因果顺序修——因为绝大多数「比对不一致」,根子都长在器件识别那半场。