UVM 分层 sequence:协议栈激励的 translation sequence 逐级转换与 virtual sequence 职责边界
更新时间:2026-10-03。验证一个带协议栈的 DUT——比如上层是自定义的消息协议、中间是 PCIe TLP 事务层、底层是 AXI 或串行链路——最自然的想法是「用上层语义写用例,让环境自己把事务翻译成底层信号」。实现这个想法的标准件就是 UVM 分层 sequence(layered sequence,也叫 sequence stacking):每一层协议配一对 sequence 和 sequencer,高层 sequence 产生高层事务,交给一个 translation sequence(转换序列)逐笔翻译成下一层事务,层层下推,直到最底层的 driver 把字节流打到总线上。本站的 UVM sequence driver scoreboard 讲了单层激励链路,UVM sequence sequencer 仲裁 讲了 sequencer 侧的调度,UVM virtual sequence start 讲了多 sequencer 的并发编排。这一篇把三者之上的「垂直分层」讲透:分层栈怎么搭、translation sequence 怎么写、它和 virtual sequence 的职责边界画在哪。
本文要回答的问题
- 协议栈验证为什么不能只用一层 sequence,分层激励解决的具体痛点是什么?
- 一个标准的两层分层栈由哪些组件组成,事务是怎么从上往下流的?
- translation sequence 的 body 怎么写,
p_sequencer向上拿事务、向下发事务的握手细节是什么? - 分层 sequence 和 virtual sequence 的职责边界在哪,什么情况该用哪一个?
- 工程落地时有哪些常见翻车点:层级泄漏、响应回传、随机化层级、可复用性?
一、为什么协议栈激励必须分层
先看不分层会怎样。假设 DUT 的协议栈是「应用消息 → TLP → AXI burst」三级,如果你只在最底层 AXI 上写 sequence,每个用例都得手工拼 AXI 的地址、长度、字节使能,把上层语义(「发一个 64 字节的读请求,消息 ID 是 5」)脑内翻译成总线行为。三个后果立刻出现:用例可读性崩塌,三个月后没人看得懂某个 burst 序列到底想验证什么;约束写在底层,上层语义的合法空间(消息 ID 范围、消息间依赖)根本表达不出来;协议栈上层改版时所有用例全废。
分层 sequence 的思路是把「语义」和「翻译」分离:测试意图永远用最高层的事务表达,层与层之间的转换逻辑封装在各自专属的 translation sequence 里,每层只懂「上一层的事务」和「下一层的事务」两种类型。这恰好对应 DUT 协议栈本身的分层结构——验证环境在激励侧镜像了设计的层次,改哪一层只动哪一层。站内的 testbench 分层架构复用 从环境复用角度讲过同样的镜像原则,本篇聚焦激励链路。
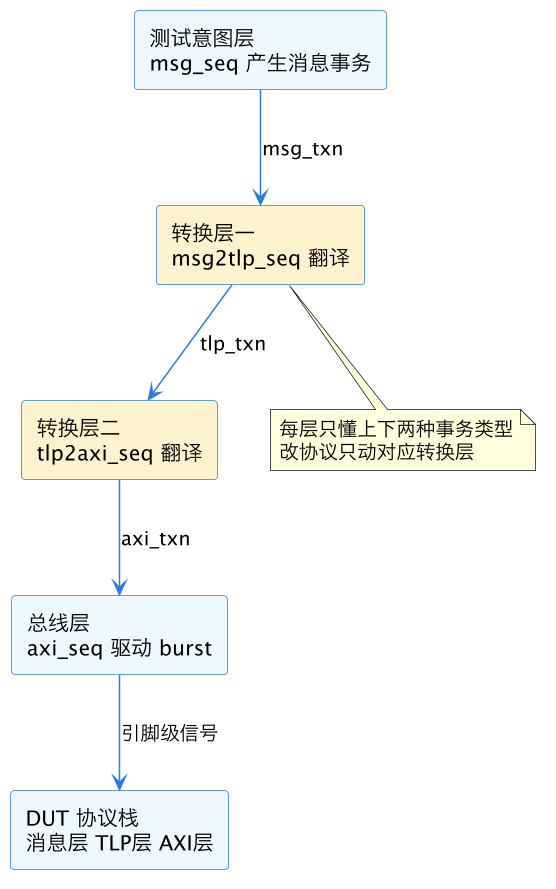
上图是整个分层栈的骨架:事务从顶部注入,每经过一层被「降级」一次抽象级别,最终变成总线信号。注意箭头方向——分层是单向的生产线,高层不感知低层细节,低层不理解高层语义,中间靠 translation sequence 做唯一的耦合点。这个单向性是分层架构可维护性的根基。
二、分层栈的组件构成与连接
一个两层分层栈(以「消息层 → AXI 层」为例)需要这些角色:上层 agent 里有一个 msg_sequencer(不带 driver,纯事务中转);下层是标准的 AXI agent(sequencer 加 driver);连接两者的就是 translation sequence,它运行在下层 sequencer 上,但句柄里握着上层 sequencer 的引用,一边从上层「取」事务,一边向下层「发」事务。
连接代码的骨架如下:
class msg2axi_seq extends uvm_sequence #(axi_txn);
  `uvm_object_utils(msg2axi_seq)
  `uvm_declare_p_sequencer(axi_sequencer)

  msg_sequencer up_seqr;   // 上层 sequencer 句柄

  task body();
    msg_txn m;
    axi_txn a;
    forever begin
      up_seqr.get_next_item(m);        // 向上层取一笔
      `uvm_do_with(a, { addr == m.addr; len == m.len; })  // 向下层发
      up_seqr.item_done();             // 告诉上层这笔消化完
    end
  endtask
endclass

// env connect_phase 里:
msg2axi = msg2axi_seq::type_id::create("msg2axi");
msg2axi.up_seqr = msg_agt.sequencer;
fork
  msg2axi.start(axi_agt.sequencer);    // 常驻在下层 sequencer 上
join_none
三个要点逐一说。第一,translation sequence 是常驻进程,env 启动时 fork 出去跑 forever 循环,test 结束才停,它不像普通 sequence 那样跑完 body 就退出。第二,它借用的是 driver 和 sequencer 之间那套 get_next_item / item_done 握手——上层 sequencer 眼里,这个 translation sequence 就是个「虚拟 driver」;下层 sequencer 眼里,它就是个普通的发激励的 sequence。一个组件同时扮演两个角色,这正是「栈」能堆起来的机关。第三,uvm_declare_p_sequencer 让它能拿到下层 sequencer 的类型化句柄,这个宏的展开细节见 UVM driver sequence item 流。
还有一个新手常问的问题:上层那个 msg_sequencer 没有 driver,它存在的意义是什么,能不能让 msg_seq 直接 start 在某个特殊对象上省掉它?答案是不能省。sequencer 在这里不只是「发激励的执行器」,它同时是事务队列和仲裁点——msg_seq 每次 start_item 都把事务推进 msg_sequencer 的队列,translation sequence 按自己的节奏从队列里取,两侧的速度天然解耦:高层可以一口气灌入一百笔消息,底层可以按总线带宽慢慢消化,队列深度就是两层之间的弹性缓冲。省掉上层 sequencer 等于让 msg_seq 直接和 translation 层点对点函数调用,缓冲和仲裁语义全丢,反压(back-pressure)场景根本没法建模。这也是为什么 UVM 允许一个 agent 里只有 sequencer 没有 driver——分层栈的上层正是这个形态的合法用户。
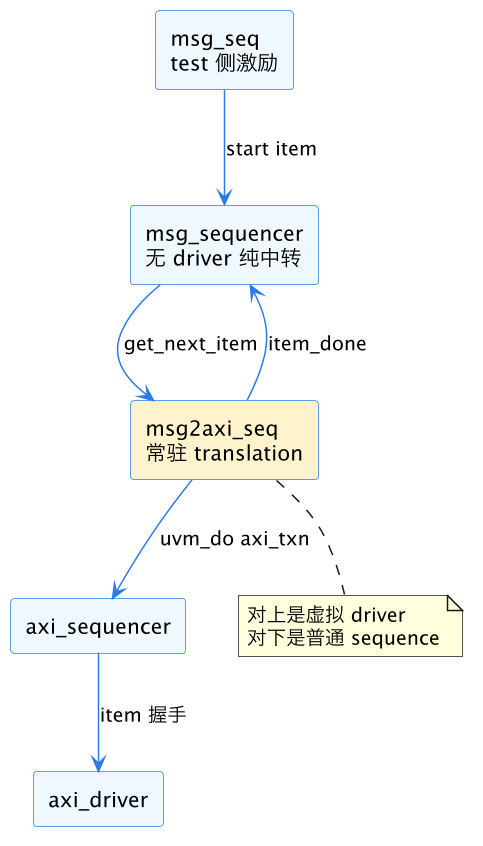
这张图把「双重身份」画清楚了:translation sequence 卡在两台 sequencer 中间,向上用 driver 的接口拿事务,向下用 sequence 的接口发事务。test 侧的 msg_seq 完全不知道 AXI 的存在,它启动在 msg_sequencer 上,发出去的消息事务被谁拿走、怎么翻译,一概不关心。
三、translation sequence 的写法细节与响应回传
上面的骨架能跑,但真实项目里三个细节决定它好不好用。
细节一:一对多的翻译。 一笔上层消息经常要拆成多笔底层事务——一个 4KB 的消息拆成 16 个 256 字节的 AXI burst。写法是在 get_next_item 和 item_done 之间放一个循环:
task body();
  msg_txn m;
  forever begin
    up_seqr.get_next_item(m);
    for (int i = 0; i < m.burst_cnt; i++) begin
      axi_txn a = axi_txn::type_id::create("a");
      start_item(a);
      a.addr = m.addr + i * 256;
      a.len  = 255;
      finish_item(a);
    end
    up_seqr.item_done();
  end
endtask
注意 item_done 的位置:必须在所有拆分事务发完之后调用。提前调用会让上层 sequence 以为这笔消息已经处理完,并发地推下一笔下来,而底层还在拆上一笔——transaction 句柄被上层复用后,你拆到一半的数据就被改掉了。这类「句柄被复用」的坑和 UVM clone create 语义 讲的是同一个根源:不确定生命周期就克隆。
细节二:响应怎么回传。 如果上层消息协议有响应语义(比如读消息要等读数据返回),translation sequence 需要把底层的 response 逆向翻译回上层 response。做法是下层 get_response(rsp) 拿到 AXI 读数据后,构造一个 msg_rsp,通过 up_seqr.put_response(rsp) 送回给上层等待的 sequence。漏掉这一步的现象是上层 sequence 的 get_response 永远等不到,test 挂死——排查时先看底层 response queue 是不是溢出(sequencer 默认 response queue 深度 8,溢出直接丢),再看 translation 层有没有做 put。response queue 的调度细节在 UVM sequence sequencer 仲裁 里有展开。
细节三:随机化放在哪一层。 原则是「语义约束放高层,时序和底层字段约束放低层」。消息 ID 的合法范围、消息间的依赖关系是高层语义,写在 msg_txn 的 constraint 里;burst 对齐、length 边界这些是总线层的事,写在 axi_txn 里。translation 层本身不应该引入新的随机化决策,它只做确定性映射——翻译逻辑里出现 randomize() 通常是设计味道不好的信号,意味着你在转换层藏了语义,三个月后没人找得到某个覆盖箱为什么总是空。场景级随机化的分层组织,SystemVerilog 场景随机化分层 有更系统的讨论。
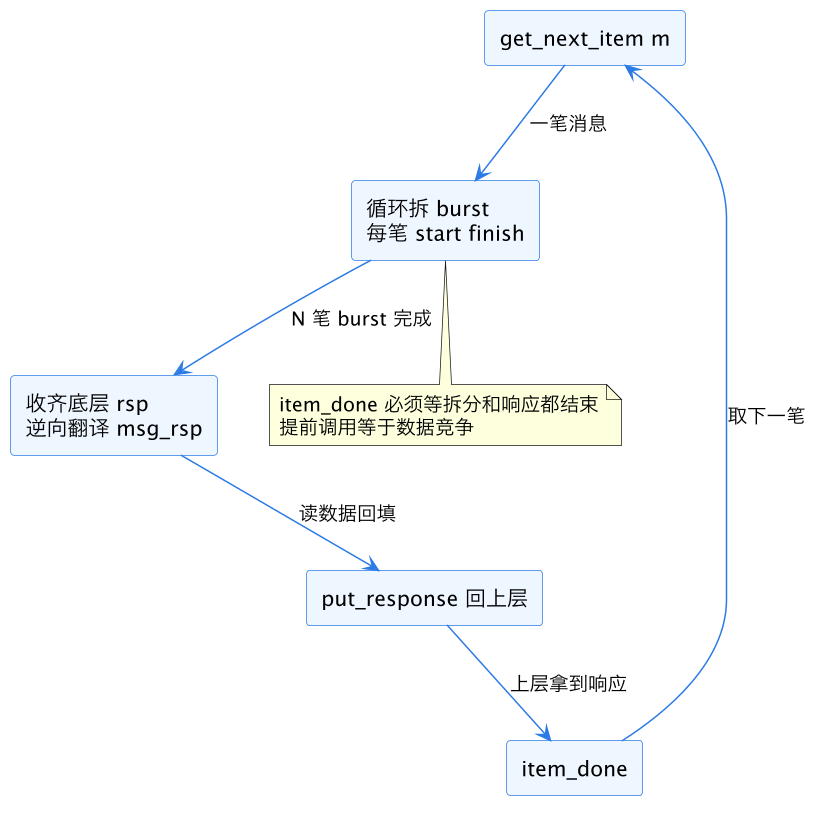
这张图是带拆分和响应回传的完整单笔生命周期。五个环节里最容易写错的是 item_done 的时机——它是上层并发节奏的总闸门,闸门开早了,上下游的事务流就错位了。
四、与 virtual sequence 的职责边界
新手最容易混的就是这两个:virtual sequence 也是「一个 sequence 操纵多个 sequencer」,分层栈也是「一个 sequence 跨层操纵多台 sequencer」,什么时候用哪个?
判据只有一条:看激励之间的关系是「并发编排」还是「抽象转换」。
virtual sequence 解决的是水平问题——test 想同时让 AXI 口发读写、让中断口拉一个中断、让配置口写几个寄存器,三股激励并发推进、按剧本同步。它不持有任何事务的翻译逻辑,只是把现成的各层 sequence 调度到各自的 sequencer 上,自己通常不 start_item 任何事务(或者只在 virtual sequencer 上做纯编排)。UVM virtual sequence start 讲了它的 start 机制。
分层 sequence 解决的是垂直问题——同一股激励要在不同抽象层之间流动,高层一笔事务变成低层 N 笔,中间的翻译逻辑必须有个地方放,这个地方就是 translation sequence。它一定 start_item 具体事务,一定持有上下两层的事务类型。
真实环境里两者几乎总是共存:分层栈负责把「消息」降级成「总线事务」,virtual sequence 在更高处编排「配置口先初始化、然后消息口发流量、同时中断口注入错误」这种多路剧本。画一条边界线:virtual sequence 只调度和同步各 sequence 的 start,不写翻译代码;translation sequence 只做翻译,不做多路并发编排。谁越界,谁就变成三个月后的维护黑洞——virtual sequence 里塞翻译逻辑会让它长成一个什么都懂的上帝类,translation sequence 里塞并发编排会让层级之间的耦合变得无法测试。
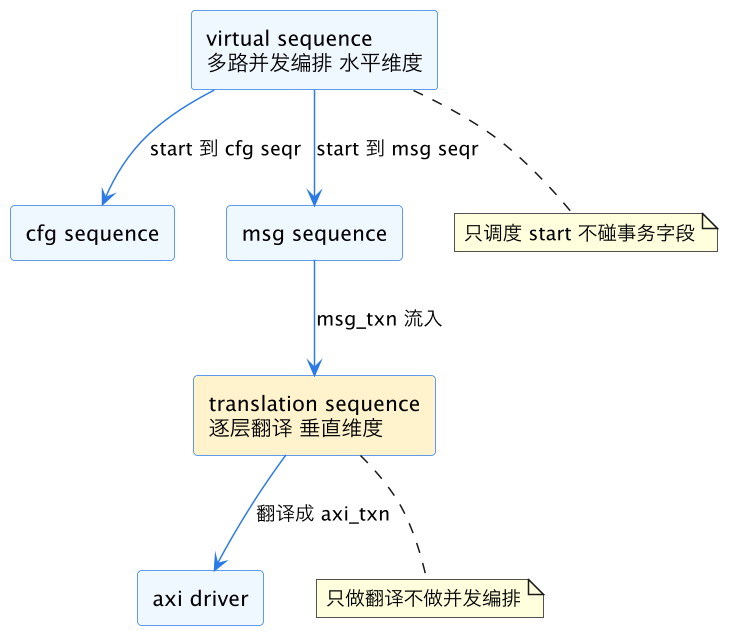
上图把两个维度画在一起:横向的 virtual sequence 像指挥,管「什么时候谁上场」;纵向的 translation sequence 像译员,管「这句话用下层语言怎么说」。指挥不该抢译员的活,译员也不该替指挥排节目单。
五、工程落地的五个翻车点
一,层级泄漏。 高层 sequence 里偷偷引用底层事务类型,或者 translation 层把底层异常码原样抛给上层语义——层级一旦被穿透,分层的好处全部归零。评审纪律:高层 sequence 的 import 列表里不该出现任何底层 package。
二,translation 层变上帝类。 拆包、组包、重试、流控、错误注入全堆进一个 translation sequence,几千行的 body 没人敢动。纪律和软件分层一样:一个 translation sequence 只翻译相邻两层,跨层需求就再加一层。
三,忘启动或重复启动常驻翻译层。 translation sequence 忘了在 env 里 fork 启动,现象是上层 sequence 发的事务永远卡在 sequencer 里没人取;重复启动两实例,两台「虚拟 driver」在同一上层 sequencer 上抢 item,事务被随机分流,失败现象飘忽。把启动代码统一收进 env 的 run_phase 或 base test,写进 checklist。
四,覆盖率采错层。 功能覆盖应该采高层事务(语义覆盖),底层总线行为交给接口级 covergroup 或底层 monitor。如果收集器订在底层 monitor 上又想覆盖消息级交叉,就得做逆向拼接,那是给自己找罪受。订阅侧怎么接见 uvm_subscriber 覆盖收集器。
五,寄存器序列混进分层栈。 UVM 寄存器包自带一套 reg_sequence 机制(内建序列库见 UVM reg sequence 内建库),它本质上也是一种 translation(寄存器操作翻译成总线事务),但走自己的 adapter 通路,不要和手写的分层栈混在同一个 sequencer 上做两套翻译——要么配置走 reg 通路、流量走分层栈,各走各的 sequencer,要么全用分层栈,别让一条激励路径上有两种翻译机制。
把这五条收拢成一句话的评审视角:分层栈的每一层都应该能被单独拿去问一个问题——「这层删掉,上一层还能独立编译、独立跑通吗?」答得上来,说明层级干净;答不上来,说明耦合已经渗进去了。协议栈项目的环境寿命往往跨越多次协议改版,分层激励的全部回报都在「改版时只动一层」上,所以平时任何一次图省事的跨层引用,都是在预支未来的维护成本。
| 翻车点 | 典型现象 | 纪律 |
|---|---|---|
| 层级泄漏 | 高层 import 底层 pkg | 评审卡 import 列表 |
| 上帝 translation | body 数千行 | 一个翻译层只管相邻两层 |
| 翻译层未启动 | 上层事务卡死 | env 统一 fork 启动 |
| 重复启动 | 事务随机分流 | 启动代码唯一入口 |
| 覆盖采错层 | 语义交叉打不满 | 高层采语义 底层采信号 |
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 UVM sequence 线的进阶篇,主关键词 UVM 分层 sequence。向上承接 UVM sequence driver scoreboard 的单层激励链路与 UVM driver sequence item 流 的 item 握手细节;横向与 UVM virtual sequence start(水平编排维度)、UVM sequence sequencer 仲裁(sequencer 调度机制)、SystemVerilog 场景随机化分层(约束分层)互为补充;环境组织原则见 testbench 分层架构复用,数据生命周期的坑见 UVM clone create 语义,覆盖采集侧对接 uvm_subscriber 覆盖收集器。
总结
UVM 分层 sequence 是协议栈验证的标准激励组织方式:每层协议一对 sequence 加 sequencer,层与层之间靠常驻的 translation sequence 桥接——它运行在下层 sequencer 上、用 get_next_item/item_done 握手从上层取事务、用 start_item/finish_item 向下层发事务,对上是虚拟 driver、对下是普通 sequence;用好它要守五条纪律——item_done 等拆分与响应全部结束才调用、语义约束放高层而翻译层只做确定性映射、响应经 put_response 逆向回传、翻译层在 env 里唯一入口 fork 启动、覆盖在高层采语义;它和 virtual sequence 的边界一目了然:translation sequence 管垂直方向的抽象转换,virtual sequence 管水平方向的多路并发编排,谁越界谁长成上帝类——分层栈让测试意图永远停留在最高层语义,改协议只动一层,这正是它在协议栈验证里不可替代的原因。