program block、final block 与 SystemVerilog 调度区域
更新时间:2026-10-01。前面反复说“竞争”,这一篇钻进仿真器内部,看一个时间步里事件到底按什么顺序执行,理解了调度区域,时序玄学就变成可解释的规则。
本文要回答的问题
- 同一个时间步里,阻塞、NBA、采样谁先谁后?
- program block 为什么能避开竞争,现在为什么又少用了?
- final block 适合做什么,和普通 end-of-test 有何不同?
#0到底暂停到了哪里?
一、一个时间步的调度区域
SystemVerilog 把同一仿真时刻切成多个有序区域(简化):
- Preponed:信号值等于上一时刻,断言采样用。
- Active:阻塞赋值、RTL 进程计算。
- NBA(Inactive→NBA):非阻塞赋值更新(
<=)。 - Reactive(Observed→Reactive):program/testbench 代码响应,断言求值。
- Postponed:时刻末尾,值已稳定,适合只读采样。
竞争根源:TB 若在 Active 区域读信号,而 DUT 在 NBA 更新,先后不确定。clocking 的 input #1step 就是到 Preponed 取旧值;program 则把 TB 执行推迟到 Reactive。
二、program block
program test(intf.tb p);
  initial begin
    @(posedge p.clk);
    p.data <= 8'h55;
  end
endprogram
program 的代码在 Reactive 区域执行,天然落在 DUT(Active/NBA)之后,采样到稳定值、驱动在下一沿生效,从而消除竞争。它还禁止例化模块、强制测试与设计分离。
但现代 UVM 实践更常用 module + clocking block + virtual interface:program 的限制较多、与 UVM 配置/接口生态不顺,clocking 已能独立解决竞争。理解 program 的设计动机比使用它更重要。
三、final block:零耗时收尾
final begin
  $display("TEST DONE: pass=%0d fail=%0d", pass_cnt, fail_cnt);
  print_coverage_summary();
end
final 在仿真结束时执行,不允许消费时间(不能有 #、@、等待),专门做统计打印、关闭文件这种必须在 $finish 前完成的收尾。它解决了“仿真被某处 $finish 终止,结尾统计没打印”的问题。
四、#0 的含义
#0 不推进仿真时间,而是把当前进程挂到本区域的惰性事件队列末尾,让同区域其他先排队的进程先执行。它常被滥用来“碰巧”压过竞争,但脆弱难懂——正确做法是用 clocking 或事件握手,而不是堆 #0。
五、调度时序图
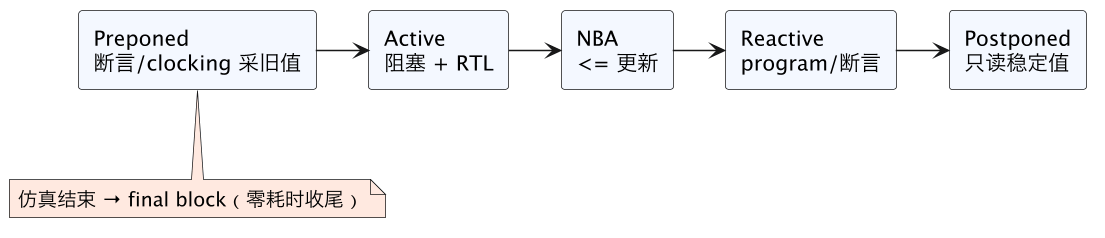
六、常见坑
- 在 Active 区域读 DUT 用 NBA 更新的信号,竞争偶发失败。
- 指望
#0稳定排序,代码一改顺序就崩。 - final 里写了延时/等待,编译报错。
- 用 program 又试图例化 module 或和 UVM config 混用,处处受限。
- 收尾统计放在普通 initial 里,被提前
$finish跳过。
小结
总结
SystemVerilog 把一个仿真时刻切成 Preponed→Active(阻塞/RTL)→NBA(<=更新)→Reactive(program/断言)→Postponed(稳定只读) 有序区域,竞争的根源就是 TB 在 Active 读、DUT 在 NBA 写、先后不定;program block 把 TB 推迟到 Reactive 天然避开竞争但限制多,现代 UVM 更推荐 module + clocking(input #1step 到 Preponed 取旧值),final block 专做不消费时间的收尾统计以保证 $finish 前必打印,而 #0 只是把进程挂到本区域队列末尾、不应被当成解决竞争的手段。