AXI 乱序响应验证:多 ID scoreboard 匹配、ID 内保序与交织深度检查
更新时间:2026-10-07。AXI(Advanced eXtensible Interface,ARM AMBA 家族的高性能片上总线)用 ID 标签换来并发:主机可以带不同 ID 连发多笔事务不等响应,从机允许按任意顺序返回不同 ID 的响应。乱序是性能的来源,也是验证的重灾区——scoreboard 按发出顺序傻等响应,一遇乱序就满屏误报。AXI 乱序响应验证要回答三件事:响应按什么键匹配、同 ID 保序怎么钉、AXI3 写数据交织深度怎么查。这一篇是 S 层标准篇,承接 AMBA AXI UVM 环境 的整体框架,scoreboard 通用乱序匹配思路见 scoreboard 乱序匹配。
本文要回答的问题
- AXI 为什么允许乱序,哪些乱序合法、哪些非法?
- scoreboard 怎么按 ID 分队列匹配乱序返回的响应?
- 同一 ID 内的保序规则怎么用断言钉死?
- AXI3 的写数据交织(write interleaving)深度检查怎么做?
- 覆盖率侧要收集哪些乱序场景才算验到位?
一、乱序的合法边界:ID 是唯一的排序键
AXI 的排序规则一句话能说清:ID 相同的事务必须按发出顺序返回响应,ID 不同的事务之间没有任何顺序约束。读通道的 R 带 RID、响应通道的 B 带 BID、读地址 AR 带 ARID、写地址 AW 带 AWID,主机靠 ID 把回来的数据挂到正确的等待槽位。设计用乱序换性能的动机很实在:从机后端挂着快慢不一的存储(SRAM 一拍、DDR 几十拍),若强制全序返回,快事务全被慢事务堵死,多 outstanding(未完成事务数)的流水线优势荡然无存。
验证侧先把合法与非法的边界画清楚。合法场景:ID0 的读先发出,ID1 的读后发出,ID1 的 R 先回来;B 通道同理。非法场景:同一 ARID 连发两笔读,第二笔的 R 先回来——哪怕数据内容碰巧一样也不行,协议层面 RID 顺序就是错的。还有一条容易漏的:AXI4 里同一 ID 的读和写之间也没有顺序约束(读写是独立通道),但同一 AWID 的多笔写,B 必须按序。
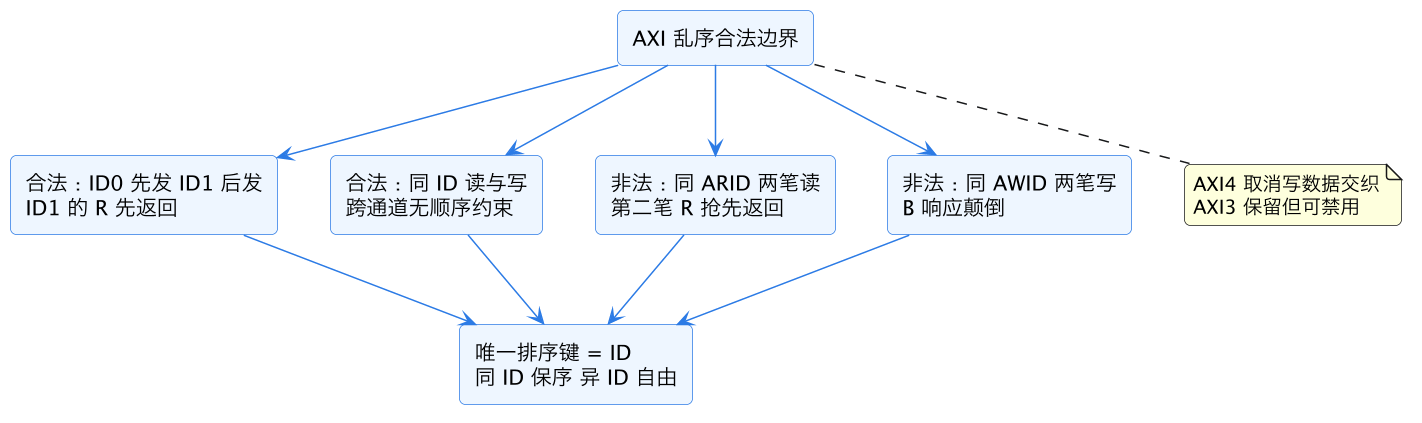
上图把四类典型场景收敛到一条规则上:ID 是唯一的排序键。checker 不需要知道从机内部怎么调度,只需要对每个 ID 独立维护一条期望队列——这是下一节 scoreboard 结构的基础。
二、按 ID 分队列的 scoreboard:乱序匹配的标准结构
AXI 乱序响应验证的核心设施是一个二维 scoreboard:第一维是 ID,第二维是该 ID 下的期望响应队列。monitor 在 AR/AW 握手时把期望(地址、长度、预测数据或预测响应码)压入 exp_q[arid] / exp_q[awid];R 握手时按 RID 到 exp_q[rid] 队首弹出比对;B 握手时按 BID 同理。队首弹出这个动作本身就隐含了保序检查——如果 DUT 乱序返回同 ID 响应,队首期望和实际对不上,比对立即报错,不需要额外断言。
写数据通道(W)要单独处理。AXI4 里 W 通道没有 ID,写数据严格跟随 AW 的发出顺序,所以写数据只需一条全局队列:按 AW 握手顺序记录每笔写的起始,W 拍按序消耗。AXI3 里 W 带 WID 且允许交织,见第四节。下面是按 ID 分队列的骨架代码:
class axi_ooo_scoreboard extends uvm_scoreboard;
  // 每个 ID 一条期望队列:读数据按 beat 存
  axi_read_beat exp_r [bit [3:0]][$];
  axi_resp_item exp_b [bit [3:0]][$];
  axi_write_beat exp_w [$];  // AXI4:W 无 ID,全局一条

  function void on_ar_handshake(axi_ar_item ar);
    foreach (ar.beat_data[i]) exp_r[ar.id].push_back(ar.beat_data[i]);
  endfunction

  function void on_r_handshake(axi_r_item r);
    if (exp_r[r.id].size() == 0)
      `uvm_error("SB", $sformatf("unexpected R with RID=%0d", r.id))
    else begin
      axi_read_beat e = exp_r[r.id].pop_front();  // 队首弹出即保序
      if (e.data !== r.data)
        `uvm_error("SB", "R data mismatch")
    end
  endfunction
endclass
真实工程里 ID 位宽常见 4~8 bit,队列用关联数组按 ID 索引最省内存。还有两个细节不能省:一是 unexpected R/B 检查(期望队列为空却来了响应,说明 DUT 多吐了一笔或 ID 错了);二是测试结束时所有期望队列必须排空,残留即丢响应。这两个检查加上队首比对,构成乱序匹配的三道闸。通用 scoreboard 的队列实现技巧见 SystemVerilog scoreboard 队列实现。
预测数据从哪来是另一个实战问题。对存储型从机,期望数据通常来自 backdoor 读的参考内存模型——AR 握手时快照地址对应的数据压入期望队列,而不是等 R 回来才现查,否则从机在读飞行期间被另一笔写改写了同一地址,快照时序之争会变成 scoreboard 假阳性。对 FIFO 型外设,期望来自 predictor 模型按写历史推出。两类来源都不影响「按 ID 分队列、队首弹出」的匹配骨架,骨架稳定、数据源可换,是这套结构能跨项目复用的原因。内存后门与 scoreboard 的衔接见 内存 backdoor 与 scoreboard,predictor 建模见 scoreboard predictor 模型。
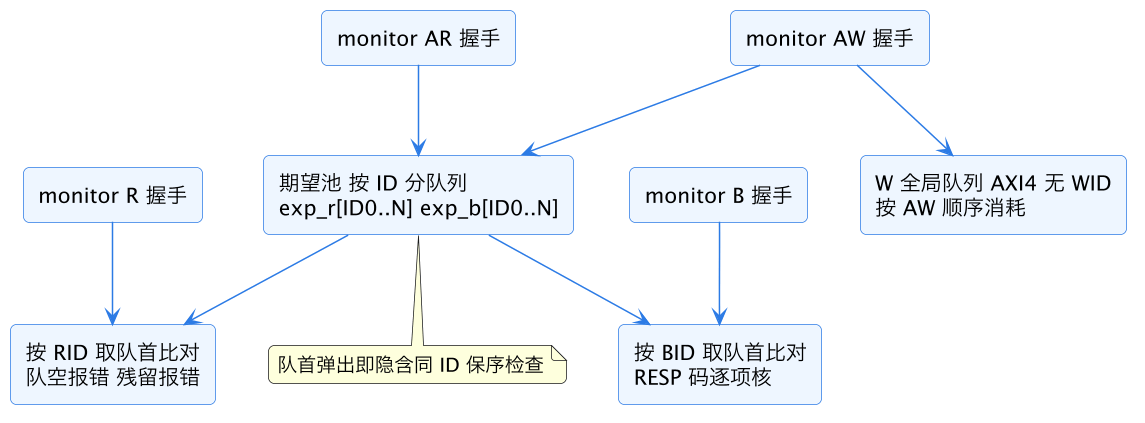
上图里 AR/AW 只负责生产期望,R/B 负责消费期望,两侧经 ID 索引的期望池解耦——monitor 的采样速率与 DUT 的返回顺序完全脱钩,这正是乱序环境必须的结构。W 通道挂在 AW 之后走独立全局队列,因为 AXI4 里它没有自己的 ID。
三、同 ID 保序与乱序深度的断言层
scoreboard 管数据对错,SVA(SystemVerilog Assertion,断言语言)管协议时序。同 ID 保序用断言写比 scoreboard 比对更直接——它在波形上钉住顺序本身,不依赖数据内容。经典写法是对每个观察到的 AR 记录「该 ID 尚未返回的读事务计数」,R 返回时校验 RID 等于最早未完成的那个 ID。实现上用一个每 ID 的未完成 ID 历史队列(scoreboard 侧)或断言绑定计数器。工程里更常用的是轻量近似:检查「R 返回时,该 RID 对应的最早未完成 AR 确实是它」交给 scoreboard 的队首比对;断言层只补两条 scoreboard 盖不住的协议红线:
| 检查项 | 通道 | 规则 | 漏检后果 |
|---|---|---|---|
| 同 ID 保序 | R/B | RID/BID 必须等于该 ID 最早未完成事务 | 主机挂错槽位,数据错位 |
| RLAST 位置 | R | 每笔读最后一拍才置 RLAST,且必须置 | burst 边界错乱 |
| B 与 W 完成关系 | B | B 只能在对应写最后一拍 WLAST 之后返回 | 从机提前报喜 |
| ID 宽度一致性 | 全部 | 返回 ID 必须命中某个未完成事务 | 幽灵响应 |
乱序深度(reordering depth,从机同时重排的 ID 个数)是另一个要钉的点。很多从机文档声明「最多 N 个 ID 乱序」,验证要造出超过 N 个 ID 在飞的场景确认不溢出,也要收集实际达到的乱序深度做覆盖率。读通道更细的时序断言见 AXI4 读通道检查,写通道对称的检查见 AXI4 写通道检查。
B 通道提前返回那条值得展开写一个断言骨架,因为它是从机实现里真实高发的 bug——写数据还没收完就报喜:
// B 只能在对应写最后一拍 WLAST 握手之后返回
property b_after_wlast;
  @(posedge aclk) disable iff (!aresetn)
  $rose(bvalid) |-> ($past(wvalid && wready && wlast, 1) ||
                     w_done_since_aw);
endproperty
a_b_order: assert property (b_after_wlast)
  else $error("B returned before WLAST handshake");
裸写 $past(wlast) 不够严谨——多笔写在飞时 B 对应的未必是最近那笔 WLAST,所以实际工程用 w_done_since_aw 这样的辅助信号:按 AWID 维护「该写数据已完整」标志位,B 握手时按 BID 查标志。这类辅助状态正是断言与 scoreboard 共享同一套按 ID 簿记的实例。
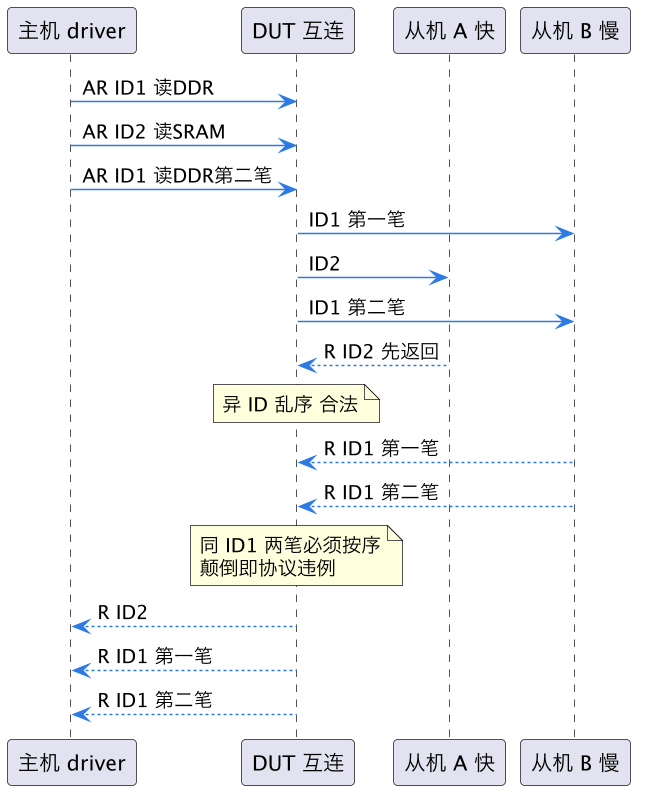
这张时序图把三笔读的实际飞行过程画出来:ID2 走快 SRAM 抢先返回(合法乱序),同 ID1 的两笔都挂在慢 DDR 上、必须按发出顺序回来。scoreboard 看到 R ID2 时去 exp_r[2] 队首弹,看到 R ID1 时去 exp_r[1] 队首弹——只要 DUT 在同 ID 内颠倒了,弹出来的期望数据必然错位,比对即报警。
四、AXI3 写数据交织:WID 与交织深度检查
AXI3 的 W 通道带 WID,允许不同 ID 的写数据拍在 W 通道上交织——第一笔写的 beat0、第二笔写的 beat0、再回到第一笔的 beat1,总线上穿插出现。同一笔写内部的数据拍仍须按序,交织只发生在不同 WID 之间。AXI4 把这个特性删了(实现收益小、验证成本高),所以 W 通道不再有 ID。验 AXI3 从机或兼容 AXI3 的互连时,交织检查躲不掉。
检查清单四条。其一,交织只跨 ID:同一 WID 的数据拍必须连续按序出现,中间可以插入别的 WID,但回来后 beat 序号要对上。其二,交织深度上限:很多实现声明最大交织深度(比如 4),scoreboard 要统计同时在 W 通道上「开了头没收尾」的 WID 个数,超限报错。其三,WID 必须命中某个已发 AW 且该写的数据还没发完——幽灵 WID 和对已关闭写的续拍都是协议违例。其四,WLAST 关闭该 WID 的交织槽位,之后该 WID 不得再出现直到下一笔同 ID 写开始。scoreboard 侧把第二节的全局 W 队列换成按 WID 分队列即可复用同一套结构。
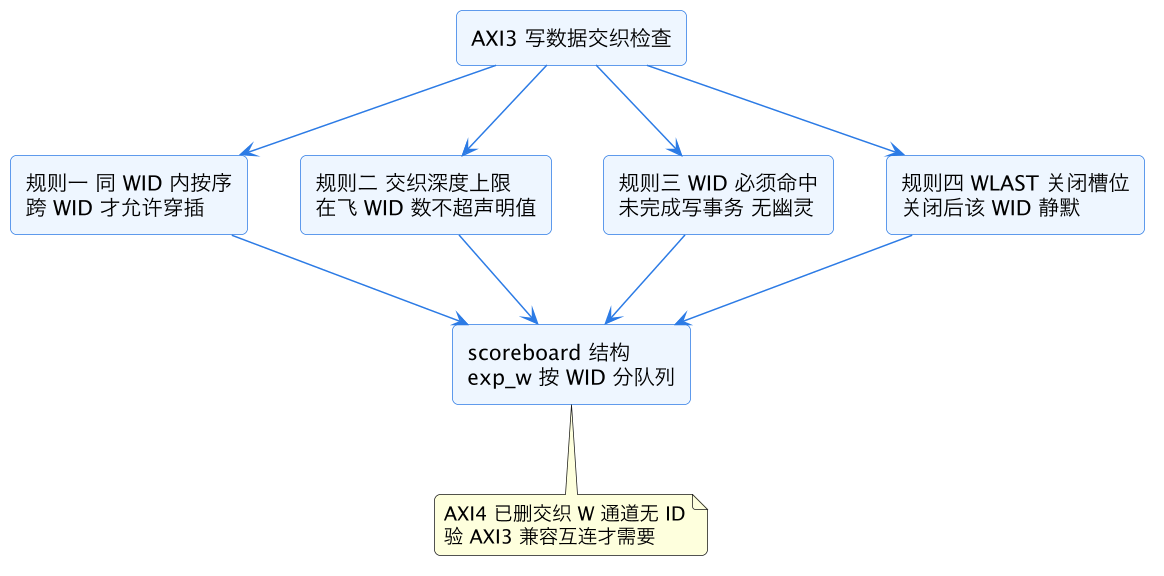
上图的四条规则最终都落到同一个结构:exp_w 按 WID 分队列,和 R/B 通道完全同构。深度上限检查是一个独立计数器——WID 首拍加一、WLAST 减一,峰值即实际交织深度,既要断言不超上限、也要进 covergroup 看是否造满了声明深度。
五、典型漏检症状与反查路径
乱序相关 bug 报错特征很集中,按症状反查比分头翻代码快。症状一「scoreboard 报数据错位,但数据内容看起来都在、只是顺序乱了」:九成是同 ID 保序被破,或 scoreboard 自己没按 ID 分队列——先确认 scoreboard 结构,再用 RID 在波形上把同 ID 的 R 返回顺序和 AR 发出顺序叠着看。症状二「压力一大就报 unexpected R」:从机多吐响应或 RID 生成逻辑在满 outstanding 时回绕出错,把在飞事务计数器拉进波形对照。症状三「B 比 WLAST 早到一拍」:从机把「数据进内部 FIFO」当成了「写完成」,第三节的 B/WLAST 断言一抓一个准。症状四「AXI3 模式下 W 数据串到别的写里」:交织槽位管理 bug,WLAST 没正确关闭槽位或 WID 匹配用了错误的全局队列。把四个症状各配一条能稳定复现的定向用例,修复才有回归依据,也才有说服力。
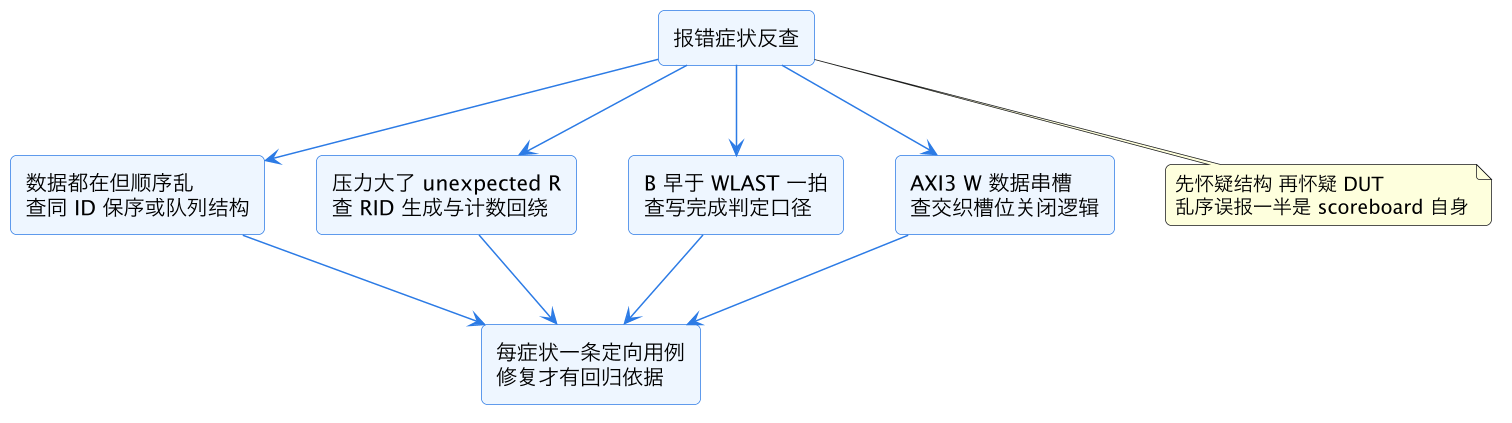
上图的反查顺序有个隐含优先级:先怀疑验证环境自身结构,再怀疑 DUT——乱序环境里 scoreboard 没按 ID 分队列导致的误报,在项目早期占报错的一半以上。结构对了,剩下的报错才是真 bug。
六、激励与覆盖率:把乱序真的造出来
结构就绪只是上半场,乱序 bug 藏在极端调度里,激励得主动造。三个手段按性价比排。第一,响应延迟随机化:UVM 从机 agent 给每个 ID 配独立的随机延迟分布,快 ID 延迟 0~2 拍、慢 ID 延迟 20~50 拍,乱序自然出现;驱动侧怎么在流水线里容忍乱序响应见 UVM 流水线 driver 乱序响应。第二,outstanding 压力:约束随机 sequence 保持同 ID 多笔在飞(同 ID 保序路径)与异 ID 满压在飞(乱序路径)交替出现,ID 池刻意收窄到 2~3 个 ID 反复用,同 ID 保序的冲突概率才上得去。第三,背靠背切换:同一 ID 读写交替、burst 长度 1 与 16 交替,逼从机内部调度器走边角。
覆盖率四个必备 bin 组:在飞 ID 数分布(1 到最大值,cross 读写方向);乱序深度实际峰值;同 ID 连续返回与跨 ID 交替返回的 transition;交织场景的在飞 WID 数(AXI3)。骨架写法如下:
covergroup cg_axi_ooo @(sample_ev);
  cp_inflight_ids: coverpoint inflight_id_cnt {
    bins low  = {[1:2]}; bins mid = {[3:6]}; bins full = {[7:$]}; }
  cp_reorder_depth: coverpoint reorder_depth {
    bins d[] = {[0:8]}; illegal_bins over = {[9:$]}; }
  cp_ret_transition: coverpoint ret_kind {
    bins same_id_run = (XID => XID); bins switch_id = (XID => YID); }
  cx_dir_ids: cross cp_inflight_ids, rw_dir;
endgroup
cp_reorder_depth 里 depth 0 也必须有 hit——全序返回是合法的退化场景,乱序压力用例如果意外跑成全序,说明延迟差异化没生效,要靠这个 bin 的空洞反过来查激励。回归里加一条「乱序压力冒烟」:窄 ID 池 + 极端延迟差 + 满 outstanding 的最小组合每夜必跑。覆盖率采样时序的坑见 covergroup 采样时机,scoreboard 与 trace 对齐的方法见 UVM scoreboard trace 对齐。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录的一篇 S 层标准篇,主关键词 AXI 乱序响应验证。它向上承接 AMBA AXI UVM 环境 的环境骨架与 UVM sequence、driver 与 scoreboard 的数据通路框架;横向与 scoreboard 乱序匹配(通用方法)、AXI4 读通道检查 与 AXI4 写通道检查(断言层)、AXI 窄传输对齐(另一 AXI 专题)同属 AXI 验证族。
总结
AXI 乱序响应验证的钥匙只有一把:ID 是唯一排序键——异 ID 随便乱、同 ID 必须按序。scoreboard 按 ID 分队列、队首弹出比对,一次动作同时完成乱序匹配与保序检查,外加「队空来响应报错、测试结束队列必须排空」两道闸;断言层补 RLAST 位置、B 晚于 WLAST 等协议红线;AXI3 额外把 exp_w 按 WID 分队列并钉交织深度上限;激励侧用窄 ID 池、差异化延迟、满 outstanding 把乱序真正造出来,覆盖率盯在飞 ID 数与乱序深度峰值——匹配键选对、保序钉死、深度查满,乱序就从敌情变成了可测的正常行为。