CRC8 SystemVerilog模板:逐位串行与字节并行两种实现对拍精讲
更新时间:2026-11-10。这是一篇「拿来即用」的模板文:CRC8(8 位循环冗余校验)给你两份完整的 SystemVerilog 实现——逐位串行的移位寄存器版与一字节一拍的并行版,讲清它们背后同一套 GF(2) 多项式除法,以及抄走之后怎么换多项式、换初值、怎么验证它真的对。校验和里最朴素的异或奇偶概念在 比较器与奇偶校验电路 里讲过,本篇把「一位奇偶」推广到「一串比特的多项式余数」;想看 16 位宽度、输入反射等更多参数形态的续篇在 CRC16 SystemVerilog 模板,而移位寄存器本身的结构与最长序列性质在 LFSR/PRBS 发生器模板 里展开。
本文要回答的问题
- CRC 到底在算什么,为什么一组移位加异或就能检错?
- 逐位串行的电路长什么样,为什么它本质上是个带反馈的移位寄存器?
- 字节并行版本怎么把 8 次移位摊到一拍组合逻辑里,结果凭什么和串行一致?
- 换一个多项式或换一个初值,代码里到底改哪几个地方?
- 怎么证明写出来的 CRC 是对的,而不是「看起来能跑」?
先把两份实现的关键差异摆在一起,后面逐段展开:
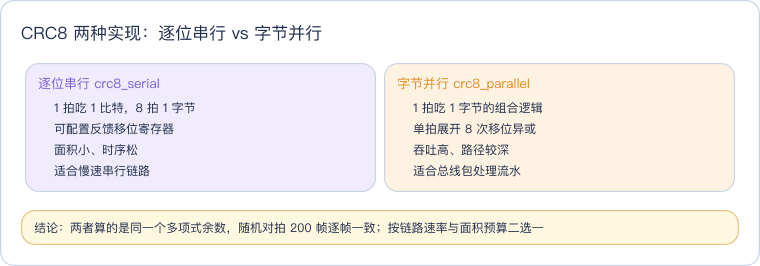
读这张卡抓一条主线:两份代码对外都是「喂数据、取 8 位余数」,行为完全等价,差别只在把 GF(2) 除法的 8 次移位异或摊到 8 个时钟拍,还是压进一拍组合逻辑。后面的随机对拍就是让串行 DUT、并行 DUT 和一个软件参考模型吃同一组帧、逐帧比余数。
一、CRC 在算什么:GF(2) 上的多项式余数
CRC 把一帧比特看成一个系数只能是 0 或 1 的多项式。比特 1011 对应多项式 x³ + x + 1。发送方在帧尾补上若干位,让整串比特对应的多项式能被一个约定的生成多项式整除;接收方拿同一个生成多项式去除收到的整串,除不尽(余数非零)就说明传输中出了错。
这里的除法不是普通整数除法,而是 GF(2)(二元域)上的除法:加减法都退化成异或,没有进位借位。于是「除以生成多项式取余」整套操作,落地到电路里就只剩两种动作——移位和异或。
这张图把 CRC 的硬件形态画成了一个带反馈的移位寄存器:每来一个比特,先把它和寄存器当前最高位异或,决定这一拍要不要「减」一次生成多项式,然后整体左移一位。所谓除法取余,就是这个反馈移位寄存器在数据流上连续滚动的结果。正因为它和伪随机发生器共用同一种反馈移位结构,理解了本篇再看 LFSR/PRBS 发生器模板 会觉得是同一个骨架。
本篇固定用最常见的 CRC-8/SMBUS 参数:生成多项式 POLY=8'h07(对应 x⁸+x²+x+1)、初值 INIT=8'h00。行业里有个公认的自检向量——ASCII 字符串 "123456789" 的 CRC-8/SMBUS 余数必须是 0xF4,这是验证实现对错的第一道关口。
为什么不直接用一位奇偶校验位、而要费这套移位异或?关键在检错能力。一位奇偶只能发现奇数个比特翻转,两个比特同时翻时奇偶性不变、错误漏网;CRC 把整帧映射到一个 8 位余数,相当于给消息加了 8 位冗余,在帧长不超过多项式设计上限时,任意单比特、任意奇数个比特错误、以及长度不超过 8 的突发错误都能稳定检出,两个合法码字之间的最小比特差(汉明距离)显著高于奇偶校验。代价就是这一节描述的反馈移位寄存器——但它在硬件上不过是若干异或门加一组寄存器,频率和面积都很友好,这也是 CRC 成为串行链路标配校验的原因。第四节的 50 组单比特全检出,正是这套冗余能力的直接观测。
二、逐位串行实现:一个可配置反馈移位寄存器
串行版严格照着第一节的图写:时钟沿到来且 bit_valid 有效时,用余数最高位与输入比特异或出反馈位,寄存器左移一位,反馈位为 1 才异或多项式。
// CRC8 逐位串行模板:MSB-first,POLY/INIT 可参数化
module crc8_serial #(
    parameter logic [7:0] POLY = 8'h07,   // CRC-8/SMBUS 多项式 x^8+x^2+x+1
    parameter logic [7:0] INIT = 8'h00
)(
    input  wire       clk,
    input  wire       rst_n,
    input  wire       bit_valid,
    input  wire       bit_data,
    output logic [7:0] crc
);
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n)
            crc <= INIT;
        else if (bit_valid) begin
            if (crc[7] ^ bit_data)
                crc <= {crc[6:0], 1'b0} ^ POLY;  // 反馈位为 1:移位后异或多项式
            else
                crc <= {crc[6:0], 1'b0};         // 反馈位为 0:纯移位
        end
    end
endmodule
最关键的就是 crc[7] ^ bit_data 这个反馈判据。它对应 GF(2) 除法里「当前余数最高位是不是 1」——是 1 才需要减一次生成多项式,而 GF(2) 的减法就是异或。{crc[6:0], 1'b0} 是左移一位、最低位补 0,移出的最高位已经参与过反馈判断,使命结束。
下面的波形展示一个字节逐位进入时的握手节奏:bit_valid 与 bit_data 在时钟沿对齐,每拍移动一位,8 拍之后寄存器里就是这一个字节带来的余数变化。
读这张波形抓两点:一是 bit_valid 只在数据位有效那 8 拍拉高,拉低期间寄存器保持不动,这让上游可以用任意间隙送比特;二是 crc 每拍都按反馈判据更新,没有「攒够一个字节再算」的动作,串行结构天然没有字节边界概念,换字节长度不需要改电路。
三、字节并行实现:把 8 次移位压进一拍
并行版不要时钟,改成一个组合函数:输入「上一拍遗留的余数 crc_in」和「当前字节 data_in」,在内部用一个循环把这一个字节的 8 次移位异或一口气做完,输出新余数。处理多字节帧时,外层把上一字节的输出接回下一字节的 crc_in 即可。
// CRC8 字节并行模板:组合逻辑,1 拍处理 1 字节,可按字节级联
module crc8_parallel #(
    parameter logic [7:0] POLY = 8'h07,
    parameter logic [7:0] INIT = 8'h00
)(
    input  wire [7:0] data_in,
    input  wire [7:0] crc_in,
    output logic [7:0] crc_out
);
    always_comb begin
        logic [7:0] c;
        logic fb;
        c = crc_in;
        for (int i = 7; i >= 0; i--) begin   // MSB-first,与串行版同序
            fb = c[7] ^ data_in[i];
            c  = {c[6:0], 1'b0};
            if (fb) c = c ^ POLY;
        end
        crc_out = c;
    end
endmodule
循环体里的三行和串行版 always_ff 里的分支是同一套运算,唯一区别是这里的 c 是组合临时变量、8 次迭代在一拍内展开,而不是跨 8 个时钟沿。综合工具会把这个固定 8 次的循环完全展开成一层异或网络,因此它的代价是一条较深的组合路径——位宽越大、频率越高,这条路径越可能成为时序瓶颈,这也是并行版吞吐高但要盯时序的原因。
两份实现的取舍可以对照下表,选型时按链路的速率与面积预算判断:
| 维度 | 逐位串行 crc8_serial | 字节并行 crc8_parallel |
|---|---|---|
| 处理节奏 | 1 拍 1 比特,8 拍 1 字节 | 1 拍 1 字节 |
| 时序特性 | 时序路径短,易跑高频 | 组合路径深,需收敛时序 |
| 资源占用 | 一个反馈移位寄存器 | 一层展开的异或网络 |
| 接口形态 | 时钟 + valid + 单比特 | 纯组合,字节进字节出 |
| 典型场景 | SPI、UART、传感器串行帧 | AXI/PCIe 包处理、总线流水 |
| 参数改动 | 改 POLY/INIT 同一处 | 改 POLY/INIT 同一处 |
四、验证:标准向量、200 帧随机对拍与检错
光有代码不算数,测试平台搭了三条互相独立的证据链。第一条是标准向量:把 "123456789" 同时喂给串行 DUT、并行 DUT 和一个用函数写的软件参考模型,三者都必须得到 0xF4。第二条是随机对拍:用固定种子生成 200 帧、长度在 1 到 32 之间随机的帧,让三种实现逐帧比对余数,任何一处不一致立即打印失败帧。第三条是检错能力:在「数据 + CRC」整体上随机翻一个比特,重新求余数,验证余数必然非零(单比特必被检出);再把无错帧带上正确 CRC 整体求余,验证余数归零。
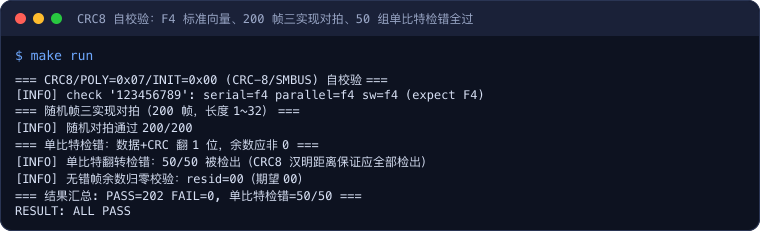
实录里四个关口依次落地:标准向量三处输出都是 f4;200 帧随机对拍 200/200 通过,证明串行与并行在随机长度、随机内容下严格等价;50 组单比特翻转 50/50 被检出,对应 CRC 的汉明距离保证;无错帧追加正确 CRC 后余数 resid=00,这正是接收端判定「无错」的硬件依据。
下面是同一次仿真的原始输出摘录,所有计数都由测试平台自己打印,可对照公开仓里的 testbench 复核:
=== CRC8/POLY=0x07/INIT=0x00 (CRC-8/SMBUS) 自校验 ===
[INFO] check '123456789': serial=f4 parallel=f4 sw=f4 (expect F4)
=== 随机帧三实现对拍(200 帧,长度 1~32) ===
[INFO] 随机对拍通过 200/200
=== 单比特检错:数据+CRC 翻 1 位,余数应非 0 ===
[INFO] 单比特翻转检错:50/50 被检出(CRC8 汉明距离保证应全部检出)
[INFO] 无错帧余数归零校验:resid=00(期望 00)
=== 结果汇总: PASS=202 FAIL=0, 单比特检错=50/50 ===
RESULT: ALL PASS
下图是这次自校验在终端里的完整运行结果,滚动区里能看到从标准向量到最终 RESULT: ALL PASS 的每一段输出,与上面的摘录逐条对应。
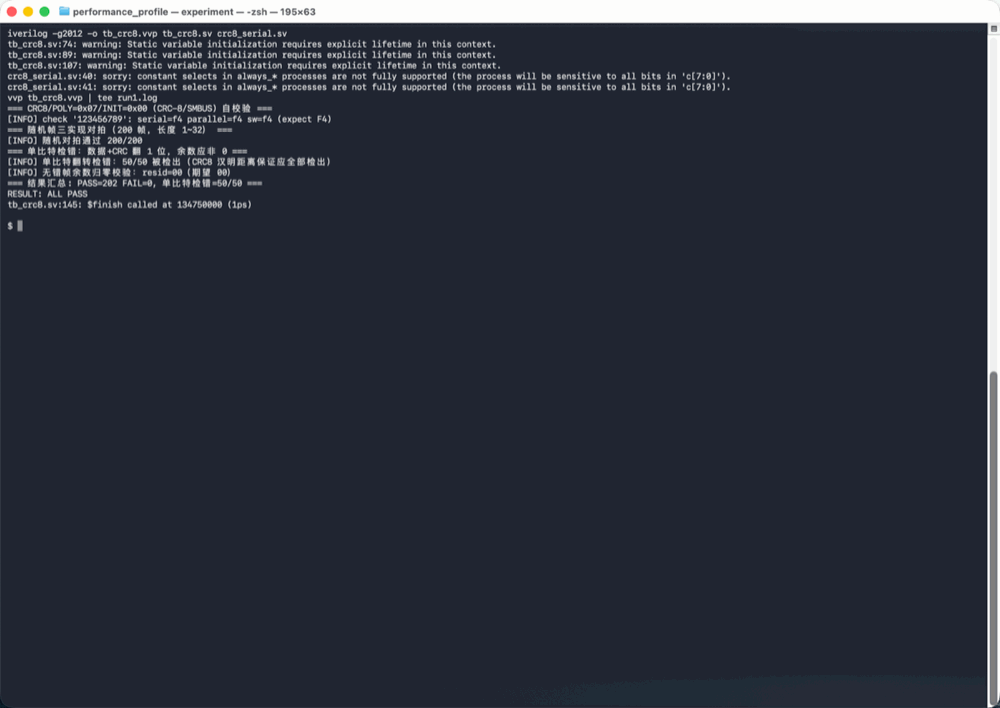
这张终端图的信息量集中在中间两行汇总:PASS=202 FAIL=0 说明标准向量、200 帧对拍和余数归零等断言无一失败,单比特检错=50/50 说明随机注入的 50 个单比特错误全部被余数机制捕获。仿真在 $finish 处正常结束,没有悬挂或超时。
五、使用注意与参数修改
- 换多项式只改
POLY一处。串行版与并行版都通过参数引用POLY,比如要切到 CRC-8/CCITT 的0x8D,实例化时传#(.POLY(8'h8D))即可,移位逻辑一行不动。但务必同时更新测试平台里的标准向量期望值,否则自检会按旧多项式判错。 - 换初值改
INIT。INIT=0x00表示从零余数开始累加;某些标准(如 CRC-8/ROHC)要求非零初值甚至结果异或,需要在参数与最后一级异或上分别处理,不能只改一个常量。 - 位序要和协议一致。本模板是 MSB-first(每个字节从最高位
data[7]送起)。如果协议规定 LSB-first,移位方向、反馈判据和多项式都要按反射口径重写,16 位篇的 ARC 配置专门演示了这套反射处理,见 CRC16 SystemVerilog 模板。 - 并行级联别漏了中间余数。多字节帧调用
crc8_parallel时,必须把上一字节的crc_out接到下一字节的crc_in,第一字节的crc_in接INIT;直接每字节都从INIT起算会得到彼此独立的错误余数。 - 复位释放后第一拍即有效。串行版在
rst_n拉低时把余数清成INIT,复位释放后无需额外初始化周期,但复位期间应当把bit_valid拉住,避免误吃比特。
六、手算示范与常见误区
把电路动作翻译成纸笔运算,能彻底消除「移位异或为什么等于除法」的模糊感。以单字节 0xC2(二进制 11000010)、初值 0x00、多项式 0x07 为例,逐比特走 MSB-first 流程:每步先看当前余数最高位与输入比特的异或,再左移,反馈位为 1 就异或 0x07。
| 步 | 输入位 | 反馈位 crc[7]^bit | 移位后 | 异或 POLY 后 crc |
|---|---|---|---|---|
| 0 | 1(b7) | 0^1=1 | 0x00 | 0x07 |
| 1 | 1(b6) | 0^1=1 | 0x0E | 0x09 |
| 2 | 0(b5) | 0^0=0 | 0x12 | 0x12 |
| 3 | 0(b4) | 0 | 0x24 | 0x24 |
| 4 | 0(b3) | 0 | 0x48 | 0x48 |
| 5 | 0(b2) | 0 | 0x90 | 0x90 |
| 6 | 1(b1) | 1^1=0 | 0x20 | 0x20 |
| 7 | 0(b0) | 0 | 0x40 | 0x40 |
八个比特走完,余数落在 0x40。这张表可以直接拿 testbench 里喂单字节的场景对照——硬件每一拍做的就是表中一行,没有任何隐含的额外运算。新手最常踩的三个误区也列在这里:
| 误区 | 错误做法 | 正确口径 |
|---|---|---|
| 位序弄反 | LSB-first 协议也从 data[7] 喂 | MSB-first 从高位喂,反射协议要先反转字节 |
| 多项式漏最高位 | 把 0x107 写进 8 位常量 | 8 位 CRC 的 x⁸ 项隐含在移位里,POLY 只写低 8 位 0x07 |
| 多字节重启 | 每字节都从 INIT 重新起算 | 上一字节余数接回 crc_in,逐字节级联 |
其中第二条最隐蔽:生成多项式完整写出来是 x⁸+x²+x+1,对应 9 位的 0x107,但最高位 x⁸ 的作用已经由「移出最高位触发反馈」这个动作承担,寄存器只存得下低 8 位,所以参数 POLY 写 0x07 而不是 0x107。几乎所有宽度的 CRC 都遵循这条「多项式常量比完整多项式少一位」的约定。
实验环境
- 机器/系统:Mac mini M4 / macOS 15
- 工具版本:Icarus Verilog 13.0(
iverilog -V输出Icarus Verilog version 13.0 (stable) (v13_0)),编译选项-g2012启用 SystemVerilog - 日期:2026-11-10
- 完整命令:
make run(Makefile 内部依次执行iverilog -g2012 -o crc8.vvp crc8_serial.sv crc8_parallel.sv tb_crc8.sv与vvp crc8.vvp)
代码获取
本文全部代码(串行与并行两份 CRC8 模板、自校验测试平台与 Makefile)已同步到公开仓库 geek-doc.cn/experiments/tpl-crc8-sv,克隆后在该目录执行 make run 即可复现标准向量、200 帧对拍与检错输出。
这一篇在知识体系里的位置
本篇是芯片设计入门簇中「数据校验」节点的 8 位模板页:一位异或奇偶的基础在 比较器与奇偶校验电路,反馈移位寄存器的结构与最长序列性质在 LFSR/PRBS 发生器模板,16 位宽度与输入反射、多参数配置的续篇在 CRC16 SystemVerilog 模板。三篇共用同一套 GF(2) 移位异或骨架,对照阅读能看清「校验」与「伪随机」在硬件上本是同源。
总结
CRC8 的本质是 GF(2) 多项式除法取余,落地到电路只有移位和异或两种动作。逐位串行版用一个可配置反馈移位寄存器、8 拍处理一个字节,面积小、时序松;字节并行版把 8 次移位异或展开成一拍组合逻辑,吞吐高但要盯组合路径。两份代码换多项式、换初值都只动参数,并已通过标准向量 F4、200 帧三实现随机对拍、50 组单比特全检出与无错余数归零四重验证,复制即用。选型只看链路速率与面积预算,算出来的余数没有差别。