setup 修复工具箱:Vt 换型、cell 放大、插 buffer、逻辑重构的选择顺序
上一篇 STA hold 修复:buffer 插法与 VT 类别讲的是时序收敛的「最后一刀」;但在那之前,你得先把 setup 收敛到 WNS/TNS 达标——这才是布线后时序工作量大头的所在。setup 修复手里的牌其实只有四种:把单元换更快的阈值电压版本(Vt swap)、把驱动加大(sizing)、在线中间插 buffer 重驱动、以及改逻辑结构本身。牌少,但出牌的顺序错了,要么功耗面积爆炸,要么把 hold 埋成一片雷区。本篇按工程实战讲:四种手段各自怎么起作用、副作用是什么、选择顺序怎么排,以及和 hold 修复的先后纪律。
本文要回答的问题
- setup 违例的 slack 缺口由哪几部分构成?「路径太长」具体长在哪?
- Vt 换型(HVT→SVT→LVT)为什么是第一优先手段?它的隐性成本是什么?
- cell sizing 放大什么时候有效、什么时候越放大越慢?
- 插 buffer 重驱动和逻辑重构各自解决什么形态的长路径?
- 四种手段的选择顺序怎么排?为什么 setup 必须先于 hold 收敛?
一、setup slack 的缺口解剖:先看清楚慢在哪
setup slack 的简化算式:周期时间减去数据路径延迟(发射时钟延迟 + 触发器 clk→q + 组合逻辑 + 线延迟),再减去捕获触发器的 setup 时间要求和时钟 uncertainty,最后加上捕获时钟延迟。修 setup 就是把这个差值从负掰正,能动手的变量无非三类:
- 缩短组合逻辑延迟:换快单元、改逻辑结构——四种手段都落在这里。
- 缩短线延迟:长线的 RC 在先进节点常常占路径延迟的三到五成,这是插 buffer 的主战场。
- 动时钟侧:useful skew、降 uncertainty——有效但通常由 CTS 和约束侧负责,见 CTS 时钟树,本篇不展开。
动手之前先看违例的形态,不同形态对应完全不同的手段:
| 违例形态 | 报告里的长相 | 首选手段 |
|---|---|---|
| 路径上单元全是 HVT/SVT,级数正常 | 每级延迟均匀偏大 | Vt 换型 |
| 某一级单元驱动小、挂了大负载或长线 | 该级延迟和斜率突然恶化 | sizing 放大 |
| 路径中间有一根横跨模块的长线 | 线上 RC 延迟占大头 | 插 buffer 重驱动 |
| 组合逻辑级数明显超预算(如 40 级以上) | 每级都不慢但级数太多 | 逻辑重构 / 加流水级 |
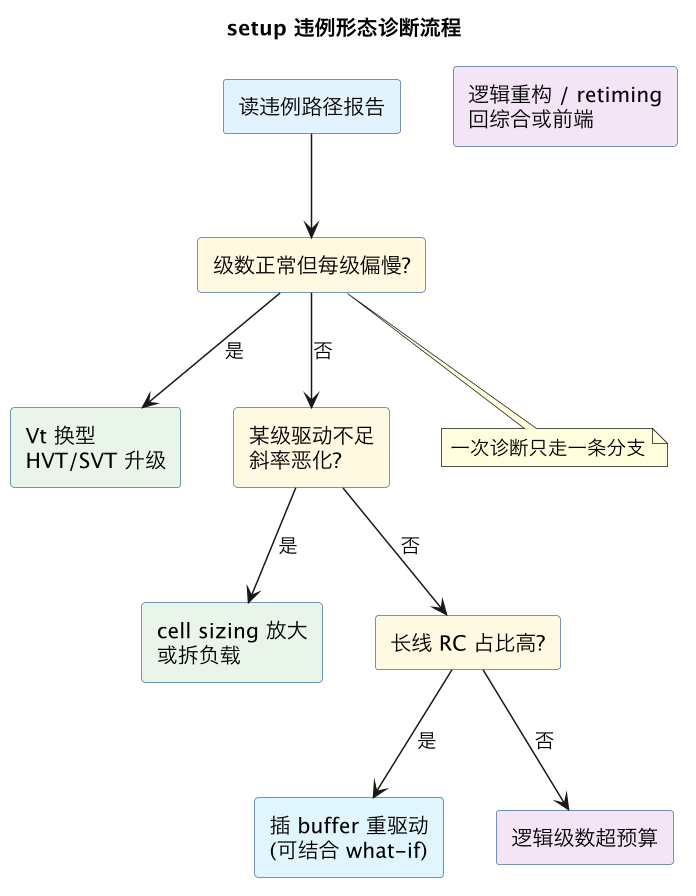
这张诊断图的要点是「先定性再动手」。很多新手看到 WNS(最差负裕量)是 -300ps 就条件反射式全路径 upsize,结果面积涨了 5%、违例只消了一半——因为那条路径的病根是 30 级逻辑,放大驱动救不了结构问题。形态诊断花十分钟,选错手段返工以天计。
二、Vt 换型:零面积的第一张牌,但它在烧漏电
Vt 换型(Vt swap)指把单元换成同族不同阈值电压的版本:HVT(高阈值,慢而省)、SVT(标准阈值)、LVT(低阈值,快而费)。同族单元版图尺寸完全一样,互换不改布局布线,是最干净的 ECO 操作——这一点和 hold 修复里换慢 VT 是同一个机制的镜像。
它排第一优先的理由有三条。零面积零布线扰动:不换 footprint 就不用动 placement,更不用重新绕线,增量 SPEF 提取后时序几乎就是预测值。收益可观:SVT 换 LVT 典型提速 15%-25%,HVT 换 LVT 能到 30%-40%(具体看节点和单元类型,SPEF 寄生提取里的角间差异同样适用于 VT 间差异)。可控性好:可以只换路径末端的关键几级,颗粒度细。
代价集中在一个词:漏电动态化。LVT 单元的亚阈值漏电比 SVT 高 5-10 倍,比 HVT 高出一个数量级以上。一个设计里 LVT 占比每上升 5 个百分点,静态功耗可能涨 20%-30%,直接撞 Voltus/RedHawk 功耗签核的预算和 IR drop 红线。所以工程纪律是:
- LVT 全局占比设上限(常见 5%-15%,功耗敏感设计压到 5% 以内),修复器带 max LVT percentage 约束跑。
- 优先换「违例路径末端」的单元:路径末端单元一变快,整段受益;路径前端的单元往往在多条路径的公共段上,换 LVT 会同时推高这些路径分支的 hold 风险。
- 换 VT 的收益要在所有 setup 角下验证:ss 角低压下 LVT 的相对收益最大,ff 角里差距缩小——但 setup 签核看的是最坏角,所以通常一次换型全角生效。
三、cell sizing 放大:有效区间有限,别和线延迟较劲
sizing(换更大驱动的同功能单元,X1→X2→X4)的直觉是「驱动大跑得快」,但这条直觉只在负载是容性且集中时成立。两个失效场景必须记住:
场景一:自载效应吃掉增益。驱动加大意味着单元自身输入电容也加大,前一级看到的负载变重,前一级变慢。路径上一级驱动的增益被自己制造的负载吃掉一部分,净收益往往只有名义值的一半。级联链上盲目把每一级都 upsize,总延迟反而可能上升——这就是逻辑努力(logical effort)理论说的「每级努力应相近」。
场景二:负载大头是线 RC 时,sizing 事倍功半。长线延迟的主导项是线本身的 R 乘以后端总 C,驱动单元输出电阻从 500 欧降到 250 欧,对总延迟的贡献可能被线电阻的 2k 欧淹没。这时候正确答案不是更大的驱动,而是把线斩断——插 buffer。
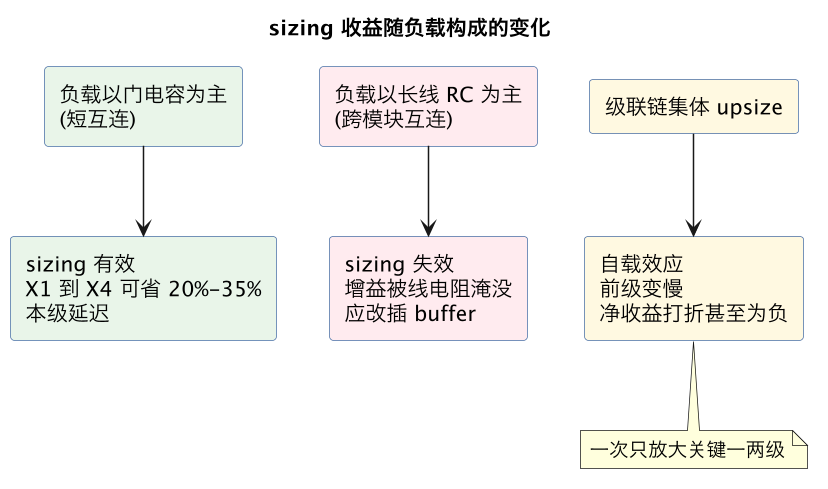
工程上 sizing 的正确姿势:只在「这一级输出斜率明显差、且负载以门电容为主」的位置放大一到两档(X1→X2,很少直接 X4);放大后必须看前一级的延迟变化,前级恶化的量超过本级收益就是亏本买卖。工具的 ECO 修复器会同时评估前后级,手工 what-if 分析时自己要算这笔账,时序 ECO what-if 分析专门讲这个工作流。
四、插 buffer 重驱动:斩断长线,但每插一个都是面积和 hold 债
长线为什么慢,一句话:RC 延迟随长度平方增长。把一根 500 微米的线从中间插一个 buffer 斩成两段,等效延迟大致降一半(理想情况下降到 1/4 加 buffer 自身延迟)。所以在「线延迟占主导」的路径上,插 buffer 是唯一能从根本上解决问题的手段——sizing 只是在和物理规律较劲。
但插 buffer 是四种手段里侵入性最强的一个:
- 要占位置:post-route 阶段插入的单元只能放在空白区,线中段的空白区未必在理想位置,偏了收益打折。
- 要动布线:cell 插进去,原来的线要断开重绕两段,增量布线可能引入新的 DRC 或耦合问题。
- 每个 buffer 都是潜在的 hold 债的反面——其实正好相反:插 buffer 让数据变快,是把路径往 hold 违例的方向推。修的这条路径 setup 变好了,但从同一个发射触发器出发的其他短路径可能因此 hold 违例。这就是为什么 setup 修复必须整体先于 hold 修复(见下一节),也是为什么 setup 修复阶段要克制——能用 Vt 换型解决的别插 buffer。
- 时钟门控使能路径特殊对待:ICG 使能端是半周期检查,插 buffer 的收益和 risks 都翻倍,很多流程把这类 net 列入修复器的 dont_touch,单独处理。
与之相对的「软」手段是逻辑重构(restructuring):把 40 级组合逻辑拍平成 25 级、把串行比较改并行、或者加一级流水。这是唯一能让路径「脱胎换骨」的手段,代价是动 RTL 等价性,要做 Formality LEC,而且往往要回综合重跑一段,迭代周期最长。工程纪律是:post-route 阶段只在前三种手段都穷尽、违例仍在 -100ps 量级时,才升级到逻辑重构;发现成片路径级数超预算,正确动作是把问题反馈给前端和综合,而不是在 ECO 阶段硬扛。
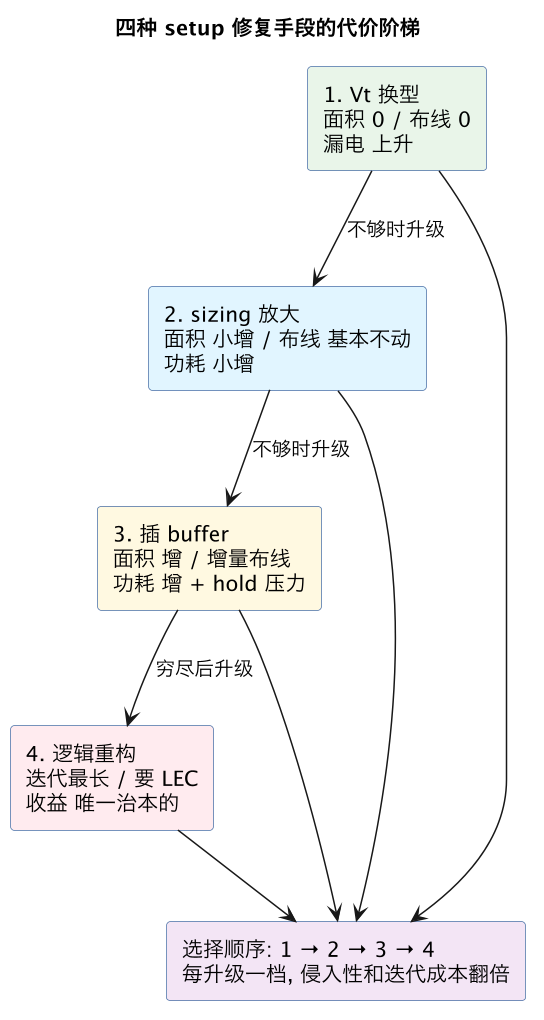
这张阶梯图就是全篇的出招表:从左到右侵入性递增、单条路径收益上限也递增。实际修复器(Innovus 的 ecoTiming、Tempus 的 fixTiming)跑的就是这个顺序的自动化版本——先全局 Vt swap 扫描,再 sizing,再 buffer 插入,最后报出修不动的路径交给人工判断是否重构。
五、与 hold 修复的先后纪律:为什么 setup 永远先走
hold 修复篇里讲过「先 setup 后 hold」的铁律,这里从 setup 修复视角把因果补全:
- setup 修复的所有手段都在让数据变快:换 LVT、放大驱动、插 buffer 斩线——每一项都在压缩数据路径延迟,而数据变快正是 hold 违例的成因。setup 没收敛就修 hold,等于在流沙上盖房。
- setup 修复会制造新的短路径:插 buffer 把一个扇出点变成两个,新单元的 clk→q 路径段变短;逻辑重构拍平级数同样缩短最小延迟。hold 违例数量在 setup 修复轮次后通常上升 20%-50%,这是正常现象,不是修坏了。
- 余量要留双面:修 setup 时不能只盯着把 slack 修到零以上一点点——要在所有 setup 角留出后续 hold 修复要吃的余量(常见纪律是 setup slack 目标 +50ps 到 +100ps,而不是 0)。否则 hold 修复插延迟单元时无处可吃,setup 又得回头返工,时序收敛 ECO 流程里这个来回是项目延期的经典原因。
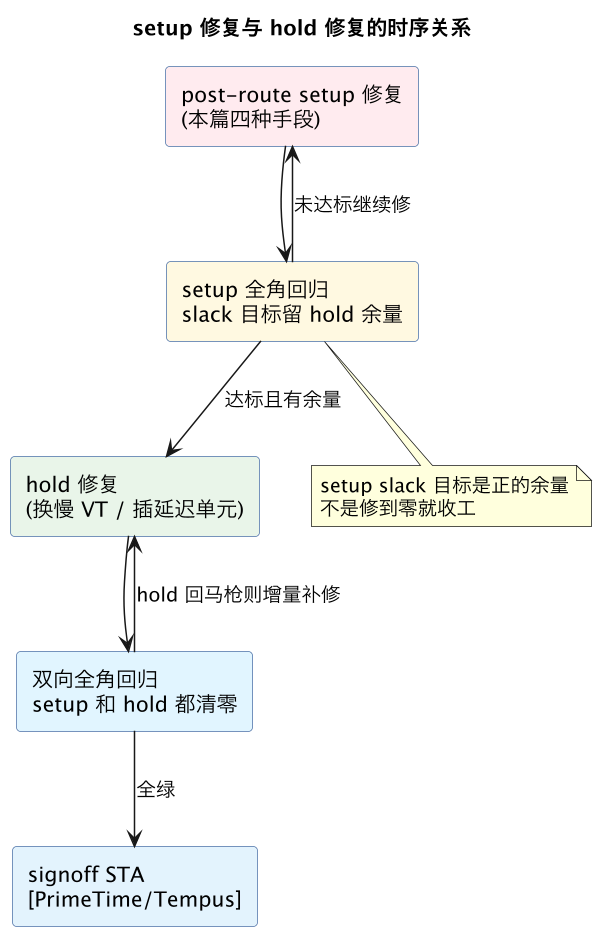
一个实战数字:成熟流程里 setup 修复占整个 post-route 时序 ECO 迭代时间的 60%-70%,hold 修复占 20% 左右,剩下是回归和签核。setup 阶段偷工(比如把 slack 修到 +5ps 就交差),hold 阶段的返工会连本带利讨回来。
六、修完之后的回归清单
在进入清单之前,先补一个贯穿所有手段的实战经验:setup 修复的收益估算要打七折预期。修复器报告里的 estimated slack 用的是修复时刻的寄生近似,真正增量提取 SPEF 反标之后,收益通常缩水 10%-30%——线重绕后实际长度和耦合环境都变了,单元换位置后输入斜率也变了。成熟工程师报修复计划时按七折算:估算能修 -300ps,计划里按 -210ps 排,不够就提前准备第二梯队手段,而不是赌估算值一次命中。另一个细节是多轮小步快跑优于一锤子买卖:每轮只修最差的一批端点(比如 TNS 贡献前 20% 的路径),修完立刻增量 STA 看全局反馈,因为修这批路径会改变相邻路径的负载和耦合,下一批的最优手段可能已经变了。一口气修全部端点再回归,翻车时定位成本指数级上升。
setup 修复动了网表,收尾要过五道闸:
- hold 全角初查:不需要清零(那是 hold 修复阶段的事),但要评估新增的 hold 违例规模,确认在修复器的处理能力内;如果 setup 修复一轮制造了上万条新 hold 违例,说明手段用得太激进(LVT 比例失控或 buffer 插太狠)。
- 电学 DRC:sizing 放大后驱动变强,但新插入 buffer 的扇出、重绕线段的 transition 都要重查。
- 功耗与漏电复算:LVT 占比报告必出,漏电增量对账功耗预算,超标就要回吐一部分 Vt swap(把非关键路径的 LVT 换回 SVT)。
- LEC:逻辑重构必须过 Formality LEC;纯 Vt swap 和 sizing 逻辑等价,但 ECO 脚本接线错误只有 LEC 兜得住。
- SI/串扰复査:重绕的线段换了邻居,先进节点下串扰增量可能让刚修好的路径又变慢,增量 SPEF 提取不能省耦合电容。
五道闸的细节与 hold 修复后的回归高度同构,可以对照 STA hold 修复第六节的回归链一起看——两边合起来就是完整的时序 ECO 收尾纪律,最终汇入 PrimeTime/Tempus 签核。
这一篇在知识体系里的位置
- 上游:违例怎么被报出来见 GBA 与 PBA 分析模式;悲观度建模见 Derate 与 POCV;寄生数据来自 SPEF 寄生提取。
- 同层:姊妹篇 STA hold 修复:buffer 插法与 VT 类别(同一套 VT 机制的镜像);动手前的单路径验证见 时序 ECO what-if 分析;迭代框架见 时序收敛 ECO。
- 下游:功能等价性由 Formality LEC 兜底,功耗账由 Voltus/RedHawk 复核,最终收口于 PrimeTime/Tempus 签核。
总结
setup 修复的出招顺序是代价阶梯:先用零面积的 Vt 换型(代价是漏电和 LVT 占比红线),再 sizing 放大(警惕自载效应和线 RC 主导时的失效),再插 buffer 斩长线(侵入最强、制造 hold 压力),穷尽后才上逻辑重构(要 LEC、迭代最长);全程铁律是 setup 先于 hold 收敛、slack 目标留足 hold 修复要吃的余量——阶梯上每跳一档都要想清楚,因为跳上去容易、退回来难。