Pipeline ADC 级间增益误差:1.5bit 子级、残差传递与冗余位数字校正
更新时间:2026-11-19。无线基站要同时吃下几十兆带宽和十二位以上有效位数,高速串行链路的接收端要在几百 MSPS 下保持线性度,工业成像的多通道前端对速率和精度两头都有要求——这类「速度比 SAR 快、精度比 Flash 高」的空档,长期由流水线 ADC(Pipeline ADC)占据。它的核心思想是把一次转换拆成若干级,每级只做一次粗糙判决并把「没判完的余量」放大后往后传,各级在时钟沿上像流水线一样并行处理不同样本。ADC 家族的整体坐标可先读 ADC 采样 量化:三步转换、Nyquist 定理、量化误差与架构选型,本篇专注流水线内部最关键的非理想项——Pipeline ADC 级间增益误差,以及冗余位和数字校正如何与它配合。
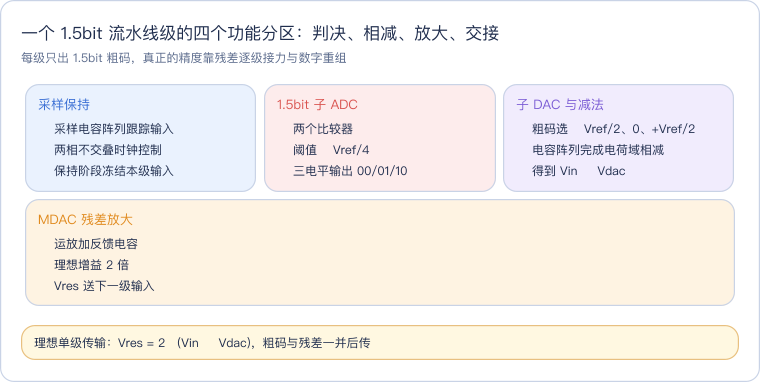
这张概念卡先给出单级的全局坐标:流水线级不是一颗完整 ADC,而是「粗判决 + 残差放大」的接力棒。子 ADC 只回答输入落在三个区间的哪一个,真正精细的信息保存在残差电压里交给后级。后面五节依次回答卡片埋下的问题:三电平判决怎么切、残差公式怎么用、误差怎么沿级联传播、冗余位和数字校准各救哪类场、以及什么场景值得为这套复杂度买单。
本文要回答的问题
- 1.5bit 子 ADC 为什么只有两个比较器却叫 1.5bit,三个判决区间和 ±Vref/4 阈值是怎么定的?
- MDAC 的单级传输函数 Vres = 2·(Vin − Vdac) 在一次真实转换里怎么逐级落地,数字侧又怎么把各级粗码重组成最终码字?
- 级间增益的理想值是 2,实际增益偏离 δ 之后,误差以什么权重沿级联传播,为什么第一级的预算最紧?
- 冗余位(重叠判决区间)能吸收比较器失调和多大范围的增益误差,哪些误差是它兜不住、必须上数字校准的?
- Pipeline 与 SAR、Σ-Δ 在精度、速率、功耗和延迟上各自占据什么区间,工程上怎么选?
一、1.5bit 子级:两个比较器切出三个判决区间
先澄清命名。一个严格的 1bit 量化器只有一个比较器、两个判决区间;1.5bit 级有两个比较器、三个判决区间,输出三电平码 00/01/10,但相邻级的区间是重叠的,信息利用率不到 2bit,业界习惯称 1.5bit/stage。这是流水线 ADC 最经典的单级粒度,在精度、面积和容错能力之间取了平衡。
两个比较器的阈值固定在 −Vref/4 与 +Vref/4(满量程按差分 −Vref 到 +Vref 讨论),判决规则只有三条:输入高于 +Vref/4 判高区间、输出码 10、对应数字 d = +1;低于 −Vref/4 判低区间、输出码 00、d = −1;夹在两阈值之间判中间区间、输出码 01、d = 0。子 DAC 按判决结果从三个参考电平里选一个:d = +1 选 +Vref/2,d = 0 选 0,d = −1 选 −Vref/2。
读图沿数据流向走:蓝色采样节点把输入同时送给红色判决通路和紫色减法通路,判决结果驱动子 DAC 选出参考电平,二者在电荷域相减后由橙色运放放大两倍,绿色残差输出就是下一级的输入。颜色区分的是四类角色——输入、判决、参考运算、输出交接,后面几节的图沿用同一套语义色。
把判决规则和子 DAC 电平代入,单级传输函数分三段:
Vin ≥ +Vref/4 :d = +1,Vdac = +Vref/2,Vres = 2·Vin − Vref
−Vref/4 < Vin < +Vref/4 :d = 0,Vdac = 0,Vres = 2·Vin
Vin ≤ −Vref/4 :d = −1,Vdac = −Vref/2,Vres = 2·Vin + Vref
三段直线在阈值处并不连续地衔接,而是故意留了重叠:理想情况下阈值 ±Vref/4 上,高区间一侧残差为 ±Vref/2,中间区间一侧残差为 ±Vref/2,数值恰好对上;实际电路里比较器有失调、增益有偏差,重叠区间就是给这些非理想预留的纠错余量,第四节会定量展开。残差始终被约束在 ±Vref/2 以内,刚好等于下一级的半满量程,这是增益取 2 倍、子 DAC 取 Vref/2 的根本原因——每一级的输出范围与下一级的输入范围严格匹配。
二、一条残差的完整旅程:Vref=1V、输入 0.62V 的逐级算例
公式要落到数字上才有手感。取 Vref = 1V,差分满量程 −1V 到 +1V,某样本 Vin = 0.62V,连走六级,每级严格套用第一节的三段规则,全部数值均可手算复算。
第一级:0.62V 高于 +0.25V,判 d1 = +1,扣掉 +0.5V 再放大,Vres1 = 2×(0.62 − 0.5) = 0.24V。第二级:0.24V 落在中间区间,判 d2 = 0,Vres2 = 2×0.24 = 0.48V。注意这里残差被放大后重新越过了 +0.25V 阈值——这正是流水线的意义,上一级没分辨开的电压被增益「撑开」后交给后级再判。第三级:0.48V 判 d3 = +1,Vres3 = 2×(0.48 − 0.5) = −0.04V。第四级:−0.04V 在中间区间,d4 = 0,Vres4 = −0.08V。第五级:输入即上一级的 −0.08V,仍在 ±0.25V 的中间区间内,d5 = 0,Vres5 = 2×(−0.08) = −0.16V。第六级:输入 −0.16V 还没越过 −0.25V 阈值,依旧判中间区间,d6 = 0,Vres6 = 2×(−0.16) = −0.32V,残差继续传给末级量化器。注意这里连续三级都判中间区间、只靠增益把微小残差逐级放大,体现的正是后级对前级量化余量的接力分辨。
| 级数 | 输入 Vin(V) | 判决 | 数字 di | 子 DAC(V) | 输出残差 Vres(V) |
|---|---|---|---|---|---|
| 1 | 0.62 | 高区间 | +1 | +0.5 | +0.24 |
| 2 | 0.24 | 中间 | 0 | 0 | +0.48 |
| 3 | 0.48 | 高区间 | +1 | +0.5 | −0.04 |
| 4 | −0.04 | 中间 | 0 | 0 | −0.08 |
| 5 | −0.08 | 中间 | 0 | 0 | −0.16 |
| 6 | −0.16 | 中间 | 0 | 0 | −0.32 |
数字侧的重组规则是按级加权:每级增益为 2,第 i 级数字的输入参考权重为 Vref/2^i,重构电压 Vrec = Vref·(d1/2 + d2/4 + d3/8 + …)。代入本例:只有 d1 与 d3 非零,d1/2 = 0.5,d3/8 = 0.125,其余各级为零,Vrec = 0.5 + 0.125 = 0.625V,与真实输入 0.62V 相差 5mV。这个差值就是六级之后尚未量化的残差量级,末级再接一个 Flash 量化器(结构见 Flash ADC:并行比较阵列、温度计码转二进制与气泡错误)把它吃掉。n 个 1.5bit 级加末级量化,总分辨率约 n+1 位,冗余重叠保证各级 1.5bit 拼接时不丢码。
流水线的另一个关键词是「流水」。每一级在一个时钟周期内完成本级采样与残差建立,下一个周期处理下一个样本,各级同时忙碌,吞吐率由单级建立时间决定而与级数无关,代价是新样本要经过若干级延迟后才输出完整码字。
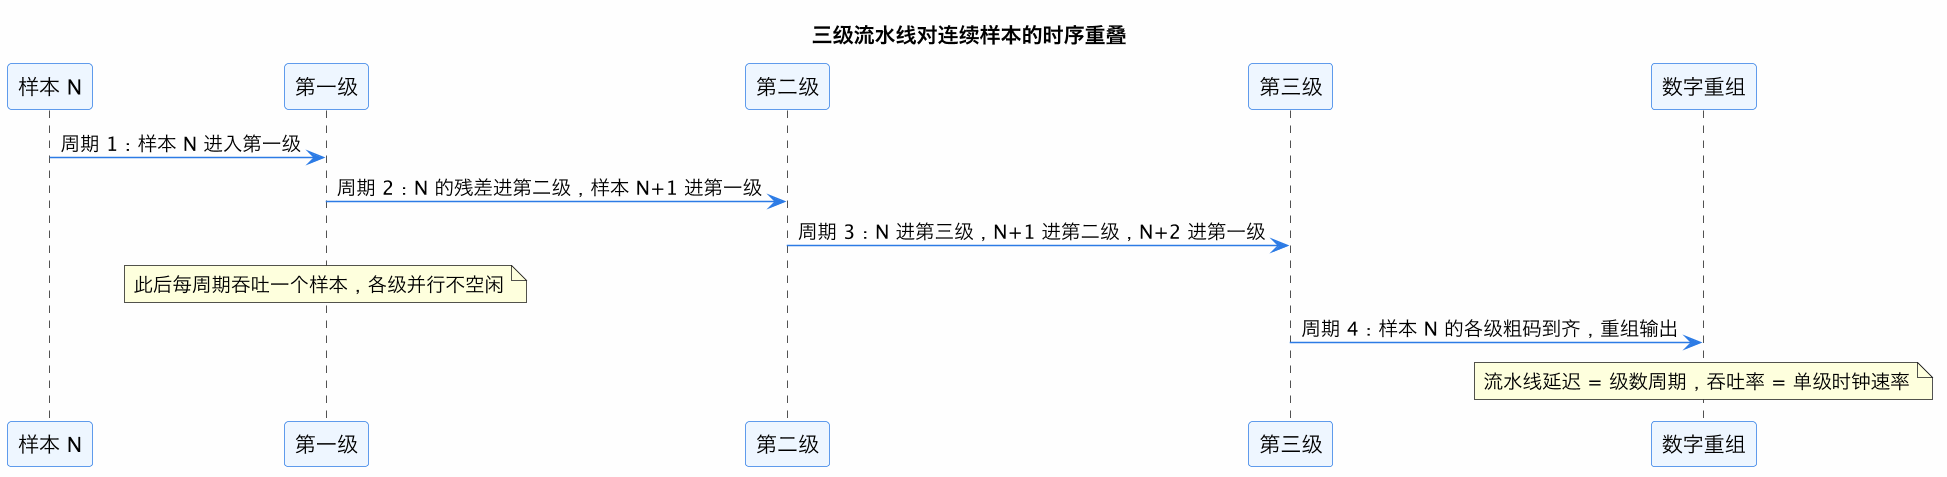
读这张时序图抓住两条线:空间上样本一级级向后走,时间上不同样本占据不同级,周期 3 之后三级全部满载。这种「延迟换吞吐」的组织方式决定了流水线 ADC 的两个工程性格:采样率可以逼近单级运放的建立极限,但输出存在与级数等长的时钟周期延迟,对要求零等待的闭环控制场合要把这个延迟算进环路。
三、级间增益误差:理想增益 2 与实际增益的偏差怎么传播
第一节所有推导建立在 MDAC 增益恰好为 2 上。真实芯片里,增益由采样电容与反馈电容的比值决定(典型开关电容 MDAC 中 G = Cs/Cf),电容失配、运放有限开环增益、建立不充分都会让实际增益变成 G = 2·(1 + δ),δ 就是相对增益误差。
把实际增益代回传输函数,本级残差变为 Vres = 2(1 + δ)·(Vin − Vdac)。数字重组并不知道这个 δ,仍按理想增益 2 反推权重,于是在重构结果里留下一项输入参考误差 ε = δ·(Vin − Vdac)。对第一级,(Vin − Vdac) 的最大幅值是 Vref/2,所以第一级增益误差的最坏贡献是 δ1·Vref/2,直接以全幅比例出现在最终码字里。第二级的误差要先除以第一级增益 2 才折算到输入端,第三级再除一次 2——第 i 级增益误差的输入参考权重按 1/2^(i−1) 递减。

读图沿自上而下的颜色由暖转冷:红色第一级权重为 1,是误差预算的支配项,橙色以后每过一级权重减半,设计资源和校准精度都向前级集中。这也解释了流水线 ADC 的版图惯例——前两级的电容阵列面积最大、匹配做得最讲究,因为后级同样的失配折算到输入端只剩几分之一。
给一组 12 位精度下的预算算例,数字为设计核算示例,非具体产品实测。满量程 2Vpp 时 1 LSB 约 0.488mV,按 Vref = 1V 折算约为 Vref 的 1/4096 ≈ 0.244mV。若第一级电容失配带来 δ1 = 0.5%(深亚微米工艺片上电容自然匹配的常见量级),最坏输入参考误差为 0.005×0.5V = 2.5mV,约合 10 个 LSB,单凭工艺匹配无法达标。若通过校准把第一级增益误差压到残差 δ1′ = 0.02%,最坏误差降到 0.1mV,约 0.4 LSB,才落进 12 位的半 LSB 预算。第二级即便保持 0.5% 失配,折算权重 1/2 后贡献约 1.25mV,仍需纳入预算但压力减半;第三级以后同比例放宽,这就是「校准资源集中砸前级」的定量依据。
| 预算项 | 未校准示例 | 输入参考最坏误差 | 折合 12 位 LSB | 处置 |
|---|---|---|---|---|
| 第一级 δ1 = 0.5% | 电容自然匹配 | 2.5 mV | 约 10.2 LSB | 必须校准 |
| 第一级校准后 δ1′ = 0.02% | 前台或后台校准 | 0.1 mV | 约 0.4 LSB | 入预算 |
| 第二级 δ2 = 0.5% | 权重 1/2 折算 | 1.25 mV | 约 5.1 LSB | 校准或加大电容 |
| 第三级 δ3 = 0.5% | 权重 1/4 折算 | 0.625 mV | 约 2.6 LSB | 可由冗余与后级消化 |
| 比较器失调 100mV | 阈值裕量 ±250mV | 0(被冗余吸收) | 0 | 无需校准 |
| 比较器失调 300mV | 超出 ±250mV 裕量 | 残差越界丢码 | 不可恢复 | 设计不合格 |
四、冗余位吸收什么,数字校准补什么
1.5bit 级最巧妙的地方是重叠判决区间。理想阈值在 ±Vref/4,但只要比较器失调把实际阈值推移到 −3Vref/4 到 +3Vref/4 这个宽窗口内,判决结果即便和理想判决不同,数字重组仍能还原出正确输入——因为相邻两个区间在 Vref/2 的跨度上重叠,一次「本应判中间却判成高区间」的错误,会被后级残差里携带的信息纠正。这就是冗余符号位(redundant sign digit)思想:每级输出的码字不是唯一表示,同一个输入电压存在多种合法级码组合,重组逻辑对组合的选择不敏感。
冗余位能干净吸收的有两类:比较器失调(上表中 100mV 失调对应阈值窗口内的推移,输出误差为零)和小幅噪声导致的偶发判决翻转。它对增益误差的态度要微妙得多:增益偏差首先改变残差斜率,只要残差幅度还撑在 ±Vref/2 的后级输入范围内,就不会发生越界丢码,重叠区间提供了这层「不崩」的保护;但重构权重仍是理想值,增益偏差造成的线性度误差并不会被冗余算法消掉,只会原样保留在传输曲线里。换句话说,冗余位保证「不出硬错误」,但不保证「测得多准」。增益误差、电容失配、运放有限增益这类乘性误差,必须由数字校准估计出真实增益再修正重组权重。
这张图把两条防线的分工画清楚了:绿色理想状态靠工艺匹配逼近,橙色小偏差区由冗余位兜底防止红色越界削顶,紫色校准在不越界的前提下把残留的乘性误差算出来补掉。两条防线缺一不可——没有冗余,比较器失调直接造成丢码;没有校准,精度被电容匹配锁死在十位上下。
数字校准按是否打断正常转换分两条路线。前台校准在上电或空闲时注入精密已知电压,逐级测量真实传输曲线并提取增益与失调参数,精度高、实现直接,代价是转换中断、依赖片上或板载精密参考,且追踪不了工作中的温漂。后台校准在正常转换中注入伪随机抖动或利用冗余通道统计残差分布,参数随数据流持续更新,不打断业务,但算法复杂、收敛需要样本量、对注入幅度与信号统计特性有要求。两条路线的完整代价对比与电路结构可参见 ADC 后台校准架构:不打断转换的伪随机注入、旁路通道与统计校准三条路线的代价与适用。冗余思想在 SAR 架构里同样存在,对照阅读 SAR 冗余校正:非二进制冗余位设计、判决错误容忍与数字校正算法 可以看出同一数学在不同架构下的变体。
还有两类误差是冗余和常规增益校准都兜不住的:参考电压本身的误差会被各级当成标尺原样继承,需要独立的参考缓冲设计(见 ADC 参考缓冲驱动:容性负载、建立精度与噪声预算怎么设计);采样时钟抖动通过输入压摆率转化为电压误差,属于采样环节而非级间环节,机理与预算见 ADC 孔径抖动:采样时钟抖动如何给 SNR 封顶,时钟链路怎么设计怎么测。
五、工程选型:Pipeline、SAR 与 Σ-Δ 各占哪个区间
三种主流奈奎斯特/过采样架构的取舍,本质是「把精度负担放在模拟还是数字、把速度负担放在并行还是串行」。下表给出典型量级区间,具体数字随工艺代、供电电压和设计水平显著漂移,选型时应以目标工艺下的厂商手册与实测为准,表内数值只用于建立量级直觉。
| 维度 | Pipeline | SAR | Σ-Δ |
|---|---|---|---|
| 典型分辨率 | 约 12–16 位 | 约 8–14 位,高阶技术可到 16–18 位 | 约 16–24 位 |
| 典型采样率 | 数十 MSPS 至 GSPS 量级 | 数 KSPS 至数百 MSPS | 数 SPS 至数 MSPS,受过采样比约束 |
| 精度瓶颈 | 级间增益误差、运放建立 | 电容 DAC 匹配、比较器噪声 | 调制器阶数、过采样比、时钟抖动 |
| 延迟特性 | 级数等长的周期延迟,固定可预期 | 单次转换多个时钟周期,无深流水线 | 数字抽取滤波器带来数十至上百周期延迟 |
| 功耗倾向 | 中等,多级运放是主要开销 | 低功耗优势明显,先进工艺受益最大 | 低速下极低功耗,高速过采样功耗陡增 |
| 面积与数字化 | 模拟级占面积,校准逻辑随工艺缩小 | 数字逻辑占比高,工艺微缩友好 | 数字抽取占比高,模拟部分精简 |
| 典型场景 | 通信中频、高速成像、示波器前端 | 传感器采集、多路复用、便携设备 | 音频、称重、精密测量、电能计量 |
选择逻辑可以压缩成三问。第一问带宽:信号带宽超过几 MHz 且要求十二位以上,Σ-Δ 的过采样比通常撑不住,SAR 在高分辨率下电容阵列面积与转换时间互相拉扯,Pipeline 是最顺的选择。第二问延迟容忍度:闭环控制等不了抽取滤波器群延迟的场合排除 Σ-Δ,流水线的固定周期延迟反而容易补偿。第三问工艺与功耗预算:先进数字工艺下 SAR 的数字化优势最大,低速传感器场景优先 SAR;只有在「高速 + 中高精度」交叉地带,Pipeline 多级运放的功耗和面积成本才花得值。多通道更高速率的需求还可以把流水线作为子通道做时间交织,通道间失配的校准见 时间交织 ADC 校准:通道间失配从哪来、数字域怎么补;低速极致精度的另一端接 ΣΔ ADC:过采样调制器、噪声整形与数字抽取滤波器,逐次逼近的工作机理见 SAR ADC:逐次逼近、电容 DAC、采样保持与转换时序。
这一篇在知识体系里的位置
- 上游:ADC 采样 量化:三步转换、Nyquist 定理、量化误差与架构选型 给出采样、量化与架构全景,本篇是其中流水线分支的深水区;Flash ADC:并行比较阵列、温度计码转二进制与气泡错误 对应流水线末级量化器与子 ADC 的基本单元。
- 横向:SAR 冗余校正:非二进制冗余位设计、判决错误容忍与数字校正算法 是冗余位思想在另一架构下的对照;ADC 后台校准架构:不打断转换的伪随机注入、旁路通道与统计校准三条路线的代价与适用 展开本篇第四节的校准路线;时间交织 ADC 校准:通道间失配从哪来、数字域怎么补 是流水线走向更高速率的组合形态。
- 下游与边界:参考链路误差接 ADC 参考缓冲驱动:容性负载、建立精度与噪声预算怎么设计,时钟侧误差接 ADC 孔径抖动:采样时钟抖动如何给 SNR 封顶,时钟链路怎么设计怎么测;架构两端分别接 SAR ADC:逐次逼近、电容 DAC、采样保持与转换时序 与 ΣΔ ADC:过采样调制器、噪声整形与数字抽取滤波器。
总结
Pipeline ADC 把一次转换拆成多级「粗判决 + 残差放大」的接力:1.5bit 级用两个比较器按 ±Vref/4 阈值切出三个区间,子 DAC 按判决选 −Vref/2、0、+Vref/2,MDAC 按 Vres = 2·(Vin − Vdac) 把残差放大两倍交给后级,Vref=1V、输入 0.62V 的六级算例展示了残差如何被逐级撑开判决、各级粗码再按 Vref/2^i 权重重组,流水线时序让吞吐率只取决于单级建立时间、代价是级数等长的延迟。级间增益实际为 2(1+δ) 时,误差以 δ·(Vin−Vdac) 进入残差并按 1/2^(i−1) 的权重向输入端折算,第一级支配整个误差预算,12 位目标下 0.5% 的自然失配贡献约十个 LSB、校准到 0.02% 才压进半 LSB。冗余位靠重叠判决区间吸收比较器失调与偶发判决翻转、并防止小幅增益偏差导致残差越界削顶,但消不掉乘性误差本身,增益与电容失配必须交给前台或后台数字校准修正权重,参考误差与时钟抖动则属于另外两条独立预算。工程选型上,Pipeline 占据数 MHz 以上带宽加十二位以上精度的交叉地带,低速低功耗优先 SAR、低速极致精度优先 Σ-Δ,所有量级数字都随工艺代漂移,落地以目标工艺的手册与实测为准。