Verilator 入门:把 RTL 编译成 C++ 的周期级仿真
上一篇 iverilog 入门:把第一份 Verilog 跑成波形 里,同一个 4 位计数器在 Icarus Verilog 上以 7 毫秒完成编译、由 vvp 事件循环解释执行。本篇是 Verilator 入门的第一站,换一台仿真器跑同一份 RTL:它不走字节码解释,而是先把 Verilog/SystemVerilog 翻译成 C++,再调用系统编译器 g++ 生成原生可执行文件。仿真器的通用四阶段(解析、elaborate、建执行模型、按虚拟时间运行)在 仿真器怎样跑 RTL 里讲过,本篇只盯着 Verilator 这一条链路上真实发生的事,并回答一个工程问题:什么时候该从 iverilog 换到 Verilator,lint 在这条链里为什么值得放在编译之前。
本文要回答的问题
- Verilator 与 iverilog 同样吃
.v文件,两者的执行模型根本差别在哪里? verilator --binary --timing --build一条命令背后,RTL 经历了哪些变换才变成可执行文件?- 同一份 testbench,iverilog 跑出
final_count=11、Verilator 跑出final_count=12,差异的机理是什么,工程上怎样写采样才稳妥? --lint-only不生成任何代码,为什么值得放进提交前自检和 CI?- 编译耗时 3633 ms 对 7 ms,大约五百倍的差距意味着什么,选型信号怎么读?
一、先定位:Verilator 走的是「编译成原生程序」这条路线
开源 RTL 仿真有两条代表性路线。Icarus Verilog 是「编译器加虚拟机」:iverilog 把 RTL 翻译成平台无关的 vvp 字节码,vvp 再用事件循环解释执行,编译以毫秒计,语义严格遵循 IEEE 标准的事件调度区域。Verilator 走得更激进:它把可综合风格的 RTL 整体翻译成 C++ 源码,随后调用本机 g++ 编译链接成一个真正的可执行文件,仿真就是直接运行这个程序。前者像 Java 的 javac 加 java,后者更像把硬件模型编成一个普通的 C++ 工程。
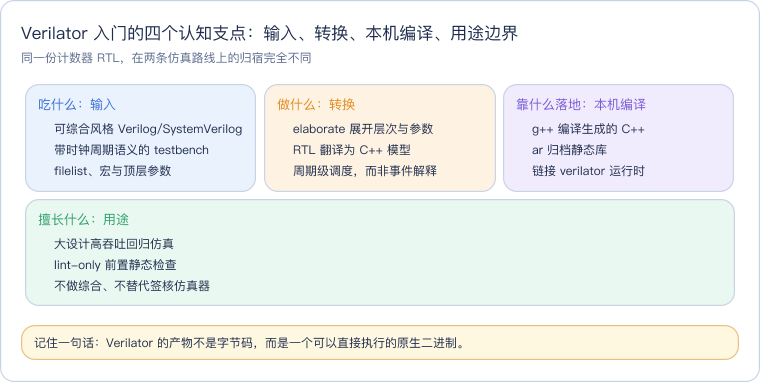
读这张概念卡抓住两层分工:Verilator 自己只负责「RTL 到 C++」的翻译与静态检查,后半段的编译、归档、链接全部交给系统工具链(g++、ar、make)。这也解释了它的两个性格特征——首次编译慢,因为要走完一整套 C++ 工程构建;运行快,因为执行的是本机机器码,没有解释器开销。需要强调的是,Verilator 面向的是可综合风格 RTL 与周期级(cycle-based)仿真,语言覆盖面与事件调度精度和商业签核仿真器不同,仿真器怎样跑 RTL 第五节的误区表里专门点出「Verilator 能平替所有仿真器」是不成立的。
二、一条命令跑通:--binary 与四个关键选项
实验工程只有两个源文件:counter.v 是带使能与同步复位的 4 位计数器,tb_counter.v 是产生 100 MHz 时钟、驱动复位使能并打印 12 拍轨迹的 testbench。与 iverilog 的「编译、执行两条命令」不同,Verilator 可以用一条命令完成从源码到运行的全部动作。
verilator --binary -j 2 --timing --build -Wno-fatal \
    counter.v tb_counter.v --top-module tb_counter
./obj_dir/Vtb_counter
跑完后产物落在 obj_dir/ 目录,可执行文件按顶层模块命名为 Vtb_counter,直接执行就开始仿真。每个选项都对应一个具体的工程语义,入门阶段至少要分清下面这张表。
| 选项 | 作用 | 不写会怎样 |
|---|---|---|
--binary | 生成 C++ 后自动构建出可执行文件,一步到位 | 默认只生成中间产物,需要自己写 C++ 外壳和 Makefile |
--timing | 启用延时与事件调度,支持 testbench 里的 #5、@(posedge clk) 等时序写法 | 遇到 # 延时控制直接报错,老版本 Verilator 根本不接受时序 testbench |
--build | 翻译完成后自动调用 make 执行编译 | 只生成 Makefile 和源码,要人手动进 obj_dir 敲 make |
-j 2 | 透传给 make 的并行编译任务数 | 单线程编译,大设计明显更慢 |
-Wno-fatal | 警告不致命,构建继续 | 默认配置下任何 warning 都会让命令以非零码退出 |
--top-module tb_counter | 指定顶层是 testbench 而不是计数器 | 多模块工程可能选错顶层,符号入口对不上 |
其中 --timing 是本篇实验能成立的前提。testbench 里用 always #5 clk = ~clk 造时钟,#5 是典型的延时控制;Verilator 传统上主打周期级仿真,早期版本只接受不带时序控制的写法,5.020 版本在 --timing 开关下支持了事件调度语义,让同一份教学 testbench 能被两套工具接受。-Wno-fatal 的存在则与第四节的 TIMESCALEMOD 警告直接相关:本次构建确实产生了警告,但实验希望跑完整个流程观察输出,所以显式让警告降级为非致命。
三、RTL 怎样变成可执行文件:C++ 翻译与 g++ 管道
Verilator 入门最值得建立的画面,是这条「Verilog 进、原生程序出」的管道。Verilator 前端先做词法语法分析和 elaborate,展开参数、层次例化,然后把 RTL 的行为语义翻译成一组 C++ 文件;系统 C++ 编译器接手后,逐个编译成目标文件,归档成静态库,最后与 Verilator 运行时(verilated.cpp 等)链接成 Vtb_counter。
这张图的关键看点是角色交接点:第二个节点之后就没有 Verilog 的事了,后半程完全是标准 C++ 工程构建。日志里 make: Entering directory 之后的输出逐字印证了这条管道,下面是本次构建的原始记录摘录。
make: Entering directory '/work/repo/experiments/iverilog-verilator-first-lesson/rtl/obj_dir'
/usr/bin/python3 /usr/share/verilator/bin/verilator_includer -DVL_INCLUDE_OPT=include Vtb_counter.cpp Vtb_counter___024root__DepSet_hdc9f34cf__0.cpp Vtb_counter___024root__DepSet_ha161471a__0.cpp Vtb_counter__main.cpp Vtb_counter___024root__Slow.cpp Vtb_counter___024root__DepSet_ha161471a__0__Slow.cpp Vtb_counter___024root__Syms.cpp > Vtb_counter__ALL.cpp
Archive ar -rcs Vtb_counter__ALL.a Vtb_counter__ALL.o
g++     verilated.o verilated_timing.o verilated_threads.o Vtb_counter__ALL.a    -pthread -lpthread -latomic   -o Vtb_counter
make: Leaving directory '/work/repo/experiments/iverilog-verilator-first-lesson/rtl/obj_dir'
对照图读这段日志:完整日志里还能看到三条 g++ -Os ... -fcoroutines 分别编译 verilated.o、verilated_timing.o 与 verilated_threads.o,它们是提供事件调度、线程和时间上下文的运行时库;verilator_includer 把生成的多个 C++ 单元合并成 Vtb_counter__ALL.cpp,随后由 g++ 编成同名目标文件;ar -rcs 把它归档成静态库;最后一行 g++ 把运行时、静态库和 pthread 链接成 Vtb_counter。注意这些编译开关里的 -DVL_TIME_CONTEXT 与 -fcoroutines,它们正是 --timing 模式的落地形式——延时调度需要时间上下文,协程用来表达等待 #5 这样的挂起语义。作为对照,iverilog 链路里完全没有 g++ 这一段,vvp 字节码由解释器直接消费,两条路线的成本结构差异在这一步就已经注定。
四、12 行轨迹与 final_count=12:两套采样口径对照
构建完成后执行 ./obj_dir/Vtb_counter,testbench 的 $display 逐拍输出。下面是本次运行 Verilator 段的真实终端记录。
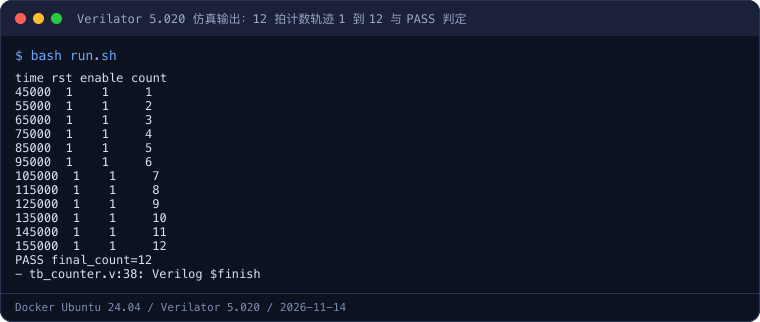
终端卡里时间戳同样从 45000 走到 155000,间隔 10000(即 10 ns、100 MHz 时钟的一个周期),rst 与 enable 全程为 1;与 iverilog 段唯一的不同是计数值:Verilator 打印 1 到 12,终值检查 PASS final_count=12,结束行为是 tb_counter.v:38: Verilog $finish。同一个 testbench、同一个 DUT,12 次读取为什么整体错位一拍?根因在「时钟沿后立即采样」这个边界写法上,两套工具的观测口径不同。
读这张对照图盯住红色读取点与橙色更新点的先后:Icarus 严格按 IEEE 事件调度区域,testbench 在 active 区的 $display 先执行,DUT 的非阻塞赋值更新排在 NBA 区,所以每次读到的都是上一拍留下的值,12 次读取依次是 0 到 11;Verilator 在 --timing 模式下对这份 testbench 的调度把寄存器更新对本轮读取变为可见,于是每次读到的都是本拍自增后的新值,1 到 12。两套结果都自洽、都通过了各自的检查,这不是谁有 bug,而是「沿后零延时采样」落在了调度区域的边界上。实验工程用条件编译宏把两套预期隔离开。
`ifdef VERILATOR
if (count !== 4'd12)
    $fatal(1, "counter mismatch: verilator expected 12, got %0d", count);
`else
if (count !== 4'd11)
    $fatal(1, "counter mismatch: iverilog expected 11, got %0d", count);
`endif
VERILATOR 宏由 Verilator 在编译期自动预定义,同一份 testbench 因此能在两条路线上各自判定 PASS。但宏隔离只是让对拍实验成立的手段,不是工程推荐写法。真正稳妥的 testbench 习惯是让驱动与采样错开一个小延时:时钟沿之后先 #1 再读信号,等所有调度区域尘埃落定,读到的必然是本拍稳定值,从根上消除对调度口径的依赖。iverilog 侧的 active/NBA 机理在 iverilog 入门:把第一份 Verilog 跑成波形 第三节有完整铺垫,可以对照阅读。
| 观察项 | Icarus Verilog 12.0 | Verilator 5.020(--timing) |
|---|---|---|
| 执行模型 | vvp 字节码加事件循环解释 | RTL 转 C++ 后 g++ 编译为原生二进制 |
| 沿后读取时机 | active 区,先于 NBA 更新 | 更新对本轮读取可见 |
| 12 次读取的值 | 0 到 11 | 1 到 12 |
| 终值与判定 | final_count=11,PASS | final_count=12,PASS |
| 工程含义 | 零延时采样依赖调度区域 | 同样的边界写法换工具即错位 |
五、lint 的前置价值:不生成代码,先拦截问题
Verilator 不只是仿真器,它还是一个非常严格的 RTL 静态检查器。--lint-only 模式下它只做前端解析、elaborate 与规则检查,不生成 C++、不调用 g++、不产生任何构建产物,因此速度极快,最适合挂在提交前自检和 CI 的冒烟环节。本次实验单独对计数器源文件跑了一次全量警告检查。
verilator --lint-only -Wall counter.v && echo "lint: counter.v 无告警"日志对应输出是 lint: counter.v 无告警:-Wall 打开全部警告族,单文件检查干净通过。这一步的价值要和构建日志里的另一条记录合起来看。第二节那条 --binary 命令虽然最终构建成功,但开头其实打了一段 TIMESCALEMOD 警告:counter.v 没有写 `timescale,而 testbench tb_counter.v 写了 `timescale 1ns/1ps,同一设计里各模块时间尺度声明不一致,Verilator 按 IEEE 1800-2017 3.14.2.3 给出提示。
%Warning-TIMESCALEMOD: counter.v:4:8: Timescale missing on this module as other modules have it (IEEE 1800-2017 3.14.2.3)
    4 | module counter #(
      |        ^~~~~~~
                       tb_counter.v:4:8: ... Location of module with timescale
    4 | module tb_counter;
      |        ^~~~~~~~~~~
这正是 lint 类检查最擅长提前暴露的那类问题:不影响语法、不阻止仿真,却会在多文件工程里埋下时间单位歧义。单文件 lint 之所以干净,是因为冲突需要两个模块同时在场才成立;把两个文件一起交给 verilator --lint-only -Wall,无需编译就能在几秒内看到同一条告警。本次 run.sh 用 -Wno-fatal 让警告不致命、流程继续,而在真实工程里更常见的纪律是反过来:CI 中不加 -Wno-fatal,任何警告都以非零退出码拦下提交,逼开发者显式 lint_off 或补齐 timescale。这条警告的完整机理与修复写法见 Verilator TIMESCALEMOD 警告排查。
| 检查形态 | 命令形态 | 是否生成代码 | 适用位置 |
|---|---|---|---|
| 全量 lint | --lint-only -Wall <全部源文件> | 否 | 提交前钩子、CI 冒烟,毫秒级反馈 |
| 构建仿真 | --binary --build | 是,完整 C++ 管道 | 本地回归、定时流水线 |
| 警告策略 | 默认致命,-Wno-fatal 降级 | — | 调试期可降级,主干保持致命 |
六、3633 ms 对 7 ms:五百倍差距背后的选型信号
实验对两条路线各跑了三回合编译,用毫秒墙钟计时、取中位数。iverilog 段的原始记录如下。
== 4. 编译耗时对照(各 3 次,毫秒墙钟取中位)==
iverilog run1: 7 ms
iverilog run2: 6 ms
iverilog run3: 7 ms
iverilog median: 7 ms
同一份日志里 Verilator 三回合分别是 3689、3612、3633 ms,中位 3633 ms。3633 除以 7 大约是 519 倍,说「五百倍量级」是准确的。但这个数字不能读成「Verilator 慢、不好用」——两边买到的东西根本不同。iverilog 的 7 ms 只换来一份字节码,后续仿真要靠 vvp 逐条解释;Verilator 的 3.6 秒买来的是原生机器码,运行期没有解释器开销,设计越大、周期数越多,这笔一次性编译投资摊得越薄。
| 维度 | iverilog 更顺手的信号 | 该换 Verilator 的信号 |
|---|---|---|
| 设计规模 | 单模块、小练习、教学实验 | 上万行 RTL、多核或 SoC 级子系统 |
| 仿真时长 | 几十上百拍,人工看日志 | 几十万到上亿周期的长回归 |
| 反馈方式 | 改完即跑,编译 7 ms | 可接受秒级编译,换运行期高吞吐 |
| 语言需求 | 完整事件语义、testbench 写法自由 | 可综合风格为主,时序控制可被 --timing 覆盖 |
| 在流水线里的角色 | 本地自检、语法与调度语义学习 | 回归主力、lint 门禁、协同仿真加速 |
一条实用的渐进路线是:入门阶段写 testbench、学事件调度、跑小实验,留在 iverilog,反馈最快、概念最标准;同一个测试开始要跑几十万周期、仿真时间以分钟计时,再带着原封不动的 RTL 迁移到 Verilator,让它承担高吞吐回归与 lint 门禁;等到需要签核口径、完整 SystemVerilog/UVM 生态时,再上商业仿真器。而「综合之后变成多少个门」已经超出仿真器职责,属于 Yosys 入门 的话题。
实验环境
- 机器/系统:Docker Ubuntu 24.04.5 容器(linux/amd64),宿主机 Intel i7-9750H,容器可见 12 vCPU;纯命令行环境。
- 工具版本:Verilator 5.020 2024-01-01 rev (Debian 5.020-1);同容器 Icarus Verilog 12.0 (stable) 仅作对照。
- 日期:2026-11-14。
- 完整命令:
bash run.sh,脚本内依次执行 iverilog 对照仿真、verilator --binary -j 2 --timing --build -Wno-fatal counter.v tb_counter.v --top-module tb_counter加./obj_dir/Vtb_counter、verilator --lint-only -Wall counter.v,最后对两套工具各跑三回合计时取中位。
代码获取:本实验完整代码(
rtl/counter.v、rtl/tb_counter.v)、run.sh与实测输出见公开仓库 derekzhuo/geek-doc.cn 的experiments/iverilog-verilator-first-lesson/。克隆后进入该目录执行bash run.sh即可复现本篇全部输出与计时数字。
这一篇在知识体系里的位置
本篇是开源 EDA 入门系列的第二篇仿真器文章,向上承接 从 RTL 到 GDS 的流程全景与 仿真器怎样跑 RTL 的通用四阶段模型。横向对照看,同一份计数器 RTL 的字节码解释路线在 iverilog 入门:把第一份 Verilog 跑成波形,仿真通过之后的逻辑综合在 Yosys 入门。继续深挖 Verilator 本身,TIMESCALEMOD 这类警告的排查与修复读 Verilator TIMESCALEMOD 警告排查;想补仿真基本概念(testbench、DUT、激励与检查),读 仿真是什么。
总结
Verilator 入门的核心认知是路线之差:它把可综合 RTL 翻译成 C++,再借 g++、ar 与运行时链接成原生可执行文件,用秒级首次编译换周期级仿真的高吞吐,并附带一个毫秒级、不生成代码的 lint-only 静态检查门禁。 本次计数器双轨对照里,Verilator 5.020 编译中位 3633 ms、约为 iverilog 7 ms 的五百倍,12 拍轨迹打印 1 到 12、final_count=12 与 iverilog 的 0 到 11、final_count=11 同为沿后零延时采样在不同调度口径下的确定结果,工程上统一以沿后 #1 采样规避;小模块与语义学习留在 iverilog,大设计长回归与 lint 门禁交给 Verilator,就是这条入门路线最清晰的分工。