SystemVerilog randomize with 作用域规则:内联约束的变量解析顺序、this 与 super 及局部名冲突的典型坑
更新时间:2026-10-06。写过
item.randomize() with { addr == addr; }的人,多半经历过那个百思不解的时刻:约束明明写了自己的地址,随机出来的值却对不上,仿真器还不报任何错。这不是求解器疯了,是 SystemVerilog 内联约束(inline constraint)的作用域规则在起作用——randomize() with {}大括号里的名字解析走的是一条「先对象后外围」的两段式路径,和直觉里的「就近原则」恰好相反。本站的 SystemVerilog 约束完全指南 和 约束随机验证 讲约束体系,SV constraint mode 与内联约束 讲内联约束的开关管理;本文只钻一个语言细节:with块里每个名字到底解析到谁,以及由此引发的四类高频坑和写法规范。
本文要回答的问题
randomize() with {}里的标识符按什么顺序解析?为什么说它和直觉相反?- 「先对象后外围」规则下,
addr == addr为什么能编译通过还悄悄生效? - this、super、局部变量、函数参数四类名字在内联约束里各有什么冲突形态?
local::限定符解决什么问题,它自己的坑又是什么?- 团队写法规范怎么定,才能让内联约束的作用域问题在评审期就被拦住?
一、两段式解析:先在被随机化对象里找,找不到再去外围
SystemVerilog LRM 给内联约束定的解析规则只有一句话,但杀伤力极大:**with 块里的未限定标识符,首先在被随机化对象的类作用域里查找;只有对象里不存在这个名字,才到外围词法作用域(随机化调用所在的 task/function/模块)里查找。**注意这个顺序和普通表达式求值正好相反——普通代码里局部变量遮蔽类成员,内联约束里类成员遮蔽局部变量。
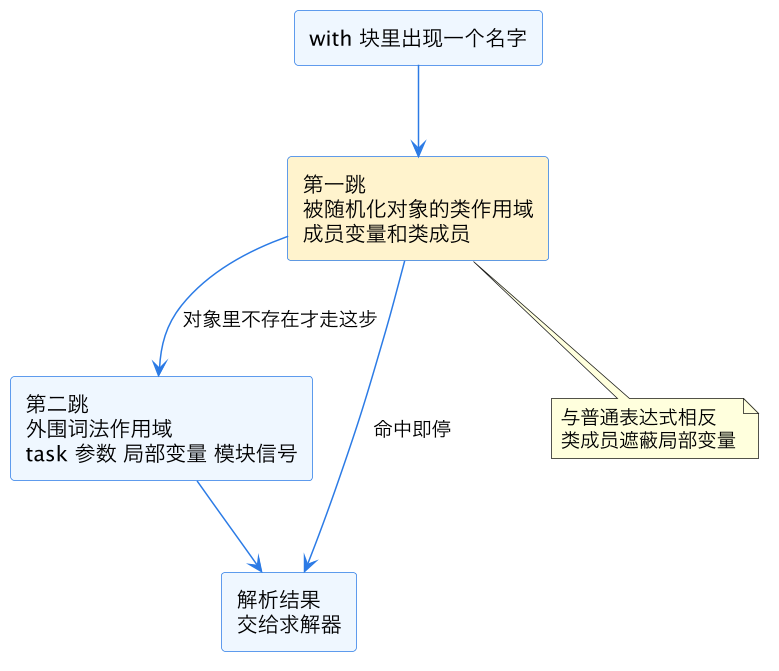
用一个具体例子把规则钉死。假设事务类 txn 里有成员 addr,随机化调用所在的 sequence 体里也有局部变量 addr:
class txn extends uvm_sequence_item;
  rand bit [31:0] addr;
endclass

task body();
  bit [31:0] addr = 32'h1000;
  item.randomize() with { addr == addr; };   // 两边都是 item.addr
endtask
直觉上 addr == addr 右值应该是局部变量(就近),实际按两段式规则,with 块里两个 addr 都先命中 item.addr——约束退化成「item.addr 等于它自己」,恒真、恒满足、等于没约束。仿真器不会报任何警告,因为这在语言层面完全合法。这就是内联约束最阴险的地方:作用域错了不报错的概率远大于报错的概率,约束悄悄变松,覆盖率悄悄缺洞,几周后某个边界场景打不到才回头发现。约束调试求解器失败 里有一类「求解器从不失败但结果从来不对」的症状,根因一半以上是这里。
从求解器视角再看一眼这条规则,能把它记得更牢。randomize() with 的语义是「把 with 块拼进对象的约束集合,整体交给求解器」——也就是说 with 块里的表达式在编译期就被改写成了对象约束的一部分,它的词法环境从「调用处」切换成了「类内部」。这个改写一旦理解,很多表面奇怪的现象就都顺理成章:为什么块里能直接写 foreach (data[i]) 而不用带对象前缀(因为它就在类里),为什么块里写不了 return、不能引用 automatic 变量的非常量别名(因为求解器看到的是类约束),以及为什么嵌套 randomize(with 块里再对成员对象 randomize)的作用域会再切一层。规则只有一条,但它在「编译期把代码搬进类里」这个机制下会派生出五六种表象,遇到怪事先问「这句话被搬进类里之后是什么意思」,多半能自问自答。
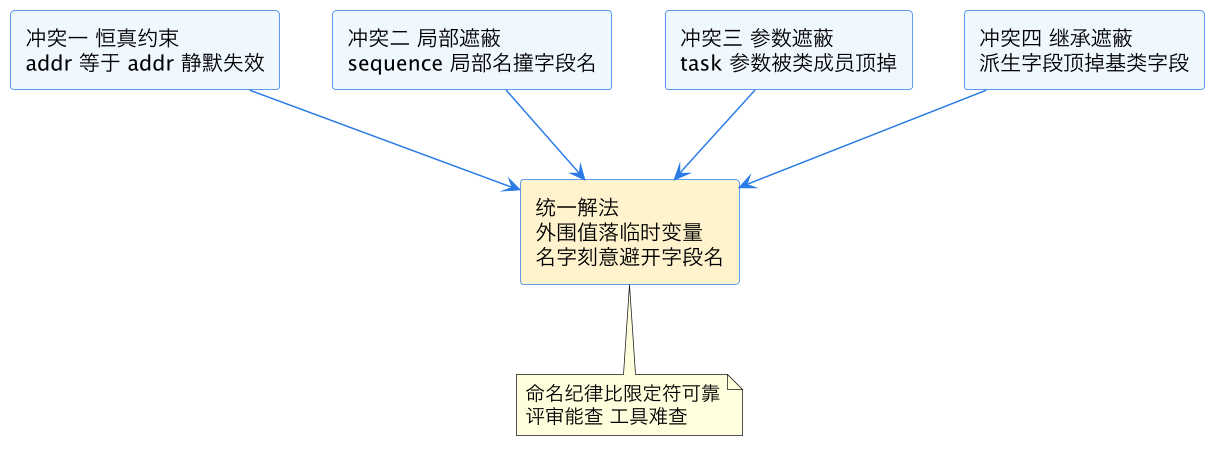
二、四类名字冲突:this、super、局部变量、函数参数
两段式规则下,冲突按名字来源分四类,各有各的形态和解法。
| 名字来源 | 冲突形态 | 典型症状 | 正确解法 |
|---|---|---|---|
| 类成员本身 | 左右同名恒真约束 | 约束静默失效 | 外围值先存临时变量再引用 |
| 局部变量 | 被类成员遮蔽 | 随机值不随局部值走 | 用不同名临时变量承接 |
| 函数参数 | 被类成员遮蔽 | 参数传进去约束不生效 | 参数改名或临时变量 |
| this 与 super 链 | 派生类遮蔽基类成员 | 约束作用在错的字段上 | 显式 super 引用或改名 |
第一类(类成员与自身同名的恒真约束)上面已经看过,标准解法是外围值先落临时变量:
bit [31:0] want_addr = 32'h1000;
item.randomize() with { addr == want_addr; };
want_addr 在 item 类作用域里不存在,两段式解析第二跳才命中外围——约束这才真正生效。这个写法还有个别名叫「shadow 隔离」,是内联约束工程规范的第一条。
第二类和第三类本质相同,都是外围名字被遮蔽。反直觉之处在于:sequence 里最常见的命名习惯——局部变量就叫 addr、len、data——恰好和事务类字段全面撞车,所以这类坑在 sequence 代码里的出现频率远高于 testbench 其它部分。UVM sequence driver scoreboard 的 sequence 写法规范里建议局部变量统一加 l_ 前缀,一半原因就是为了躲开这条解析规则。
遮蔽还有一个更隐蔽的子形态:名字当时不冲突,后来才冲突。sequence 写的时候事务类没有 priority 字段,with 块里引用外围局部变量 priority 一切正常;三个月后有人给事务类加了个 rand int priority,所有老 sequence 里的内联约束在同一次编译后集体改语义——解析从外围跳到了新加的类成员。这是「先对象后外围」规则最伤人的长期效应:给事务类加 rand 字段是一个会影响所有内联约束的破坏性动作。防御办法一是前面说的命名避让纪律(字段加前缀或用下划线风格区分),二是给回归套件配「随机结果分布快照」——关键 sequence 的字段分布在 CI 里留基线,字段一加、分布一歪,diff 立刻报警,不用等覆盖率缺洞。
第四类涉及继承链:派生类重新定义了与基类同名的字段(合法的成员遮蔽)时,with 块里的名字解析到派生类版本。如果本意是约束基类字段,需要显式写——但注意内联约束里 super.xxx 的写法多数仿真器支持度参差,更稳的做法是在类里给基类字段加访问函数,或者干脆在派生类里用不同名。SV 约束继承与覆盖 讲的继承侧约束规则在这里和作用域规则叠加,是内联约束坑密度最高的交叉地带。
三、local:: 限定符:官方解法与它自己的坑
LRM 其实提供了一个官方逃生通道:local:: 限定符,强制名字解析跳过对象作用域、直奔外围词法作用域:
item.randomize() with { addr == local::addr; };语义清晰、意图显式,按理说该大力推广。但工程现实让它始终没能成为主流解法,原因有三。其一,工具支持史参差不齐——local:: 是 1800-2012 才补进标准的澄清,老版本仿真器和老代码库对它的处理有差异,跨工具项目不敢依赖。其二,它只能解「指向外围」这一半问题,不能解决「名字撞了但两边都想要」的复杂表达(比如约束里同时引用 item.addr 和局部 addr),那种场景还是得靠临时变量。其三,可读性两极分化:不熟悉这条规则的 reviewer 看到 local:: 反而要查手册,而临时变量写法 addr == want_addr 望文生义。
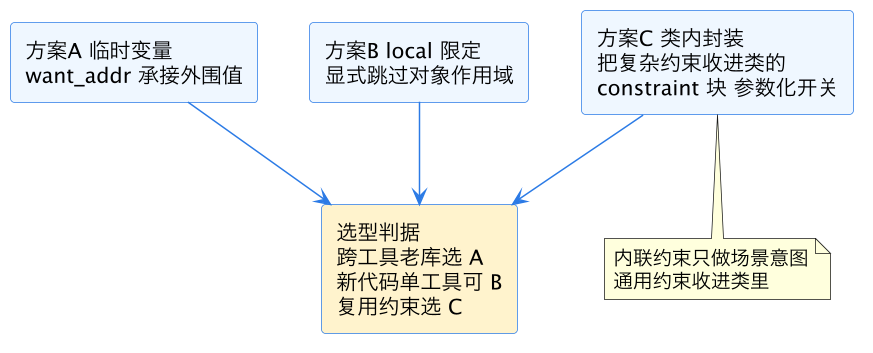
方案 C 值得多说一句,因为它触及内联约束的定位问题。本站在 UVM 事务抽象与 driver 里强调过约束分层纪律:合法约束(保证事务合法)写进类的 constraint 块,场景意图(这次就要边界地址)用内联约束叠加。作用域问题主要发生在内联这一层,因为类内 constraint 块的作用域天然就在类里、没有外围干扰。所以一个根治思路是:内联约束里只出现简单比较,复杂表达式一律收进类内约束加 constraint_mode 开关——内联块越短,作用域出错的面越小。SV solve before 与 soft 顺序 里的 soft 约束机制和这个分层正好配合:类内 soft 写默认合法范围,内联硬约束做场景收紧,两层各管各的作用域。
四、工程规范:让作用域坑死在评审期
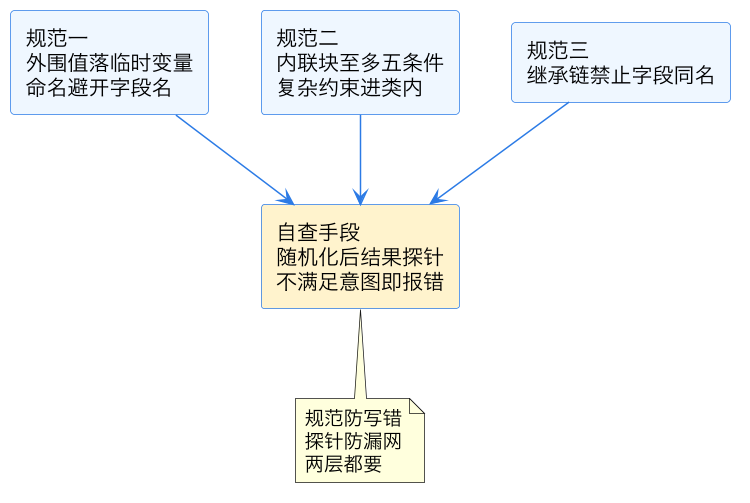
作用域问题靠调试是被动的——它静默、不报错、埋得深。主动防线是三条写法规范加一条自查手段。
三条规范。第一,内联约束引用的外围值必须先落临时变量,且临时变量命名禁止与事务类任何字段同名(推荐 want_、cfg_ 前缀);这条直接消灭冲突一、二、三。第二,内联约束单块不超过五个条件,超出的部分收进类内 constraint 用 mode 开关管理;这条控制爆炸半径。第三,继承链上禁止字段同名遮蔽,派生类新增字段必须新名;这条消灭冲突四,顺带让 SV OOP 基类派生句柄 的多态代码更好读。
一条自查手段:给关键内联约束配「约束有效性探针」——随机化后立刻 $isunknown 加范围断言检查被约束字段,比如约束 addr == want_addr 后紧跟一句 if (item.addr !== want_addr) uvm_error`。这看起来啰嗦,但它把「约束静默失效」从「几周后覆盖率缺洞才发现」变成「第一次跑就炸」。随机稳定性与 seeding 提醒过随机结果依赖 seed,探针检查正是对抗 seed 依赖的确定性防线——无论随机化求出什么,结果必须满足意图,这是可以在每次仿真里确定检查的事实。
最后提醒一个组合坑:内联约束的作用域规则和 SV dist 权重验证 里讨论的分布验证叠加时,错误的解析不仅丢掉约束,还可能悄悄改变分布形状——比如本来想 addr dist {l_addr := 8, others := 2},解析错位后变成对对象自身的恒真引用,dist 整个失效而代码看起来一切正常。分布类内联约束因此是探针检查的最高优先级对象。
还有一个分布更广的变体值得单独点名:randomize() with 里调用函数。LRM 允许 with 块里出现函数调用,函数按普通语义求值,但函数体内的名字解析不走两段式——函数是独立编译单元,内部作用域规则照常。这就造成一个阅读陷阱:同一个名字,写在 with 块里解析到对象成员,写进被调函数里解析到外围,review 时稍不留神就把两者混为一谈。工程规范里建议 with 块里调用的函数一律无副作用、参数显式传全,不在函数里反向依赖「外围恰好有个同名变量」——这类隐式耦合在 SV 约束求解器性能 关注的求解效率上也是负分项,函数调用会迫使求解器按过程式求值、丢掉部分约束传播机会。
这一篇在知识体系里的位置
本篇属 chip-design/verification 目录约束随机线的语言细节深文,上承 SystemVerilog 约束完全指南 与 约束随机验证,横向衔接 SV constraint mode 与内联约束 的开关管理、SV 约束继承与覆盖 的继承侧规则、SV solve before 与 soft 顺序 的求解顺序,问题排查侧接 约束调试求解器失败,应用层落在 UVM 事务抽象与 driver 的约束分层纪律与 SV dist 权重验证 的分布校验。
总结
randomize() with 的作用域规则是一条反直觉的两段式解析:块内名字先在被随机化对象的类作用域里找、找不到才去外围找,于是 addr == addr 这类写法恒真生效、局部变量和函数参数被类成员静默遮蔽、派生类字段顶掉基类字段,且全程不报错;工程上的标准解法是外围值先落命名避让的临时变量、内联块保持短小、复杂约束收进类内 constraint 块,local:: 限定符是官方逃生通道但受工具史和可读性限制难当主力,最后必须用随机化后结果探针把「约束静默失效」变成「首次跑即报错」——记住「先对象后外围」这六个字,内联约束最玄学的那类 bug 就永远进不了你的代码库。