AOCV 表生成:从 SPICE 仿真到 derate 表标定与签核前校验全流程
更新时间:2026-10-03。AOCV(Advanced On-Chip Variation,先进片上偏差建模)是先进工艺节点签核时序的标配:OCV 与 AOCV 的深度降额概念 那篇讲的是「为什么用」和「怎么用」,偏概念与使用侧;这一篇讲的是表的「出生证明」——derate 系数到底怎么从 SPICE 仿真和签核工具里生成出来,depth(路径逻辑级深度)和 distance(物理跨度)两个维度怎么标定,以及表格交付签核之前怎么证明它是对的。表错一格,全芯片几千条路径的悲观度一起错,所以 AOCV 表生成不是一个交付动作,而是一条带校验闭环的产线。读这篇之前建议先回顾 MMMC 与 OCV 寄生参数 的偏差建模背景,以及 Signoff STA 与 PrimeTime 的签核环境。
本文要回答的问题
- 一张 AOCV 表的两个维度(depth、distance)分别在建什么物理效应,为什么不能只用全局 flat derate?
- 从 SPICE 统计仿真到 derate 系数,中间的特征化数据通路长什么样,谁在哪个环节说了算?
- depth 维度的标定点怎么选,级数越深 derate 越接近 1 的物理原因是什么?
- distance 维度怎么和版图实际跨度对上,分箱粒度多大才够用又不至于表爆炸?
- 表生成完之后,签核前必须过哪些校验——蒙特卡洛对拍、单调性、覆盖率、工具加载自检各查什么?
一、为什么是表:两个维度背后的物理
先回忆问题的起点。片上偏差(OCV)指同一片晶圆、同一颗芯片上,两个理论上相同的晶体管因为工艺涨落表现出的参数差异。传统的 flat OCV 用一对全局 derate 系数(比如数据路径 1.08、时钟路径 0.98)给所有单元一刀切地加悲观度。这在 90nm 时代够用,到了 28nm 以下就明显失真:一条 3 级的小路径和一条 40 级的大路径,偏差累积方式完全不同——级数越多,各级的随机涨落越倾向于互相抵消(统计平均效应),固定的 8% 悲观度对长路径纯属浪费;同样,跨半个 die 的路径和挤在 50 微米内的路径,面对的系统性梯度(cross-die 的掺杂梯度、掩膜版曝光梯度、温度梯度)也完全不同,距离越远,系统性分量越大,derate 越该紧。
AOCV 的解法就是把「一刀切」换成「按路径属性查表」:一张二维(或两个一维)表,横轴是路径深度(stage count / depth,即时序弧经过的单元级数),纵轴是路径物理跨度(distance,通常取路径起点到终点的曼哈顿距离或包围盒对角线),每个格子存一个 derate 系数。签核工具分析一条路径时,先数它多少级、量它跨多远,查表得到这条路径专属的悲观度。depth 维度吸收随机分量的平均效应,distance 维度吸收系统性梯度分量——两个维度不是拍脑袋分的,它们各对应一类物理机制。
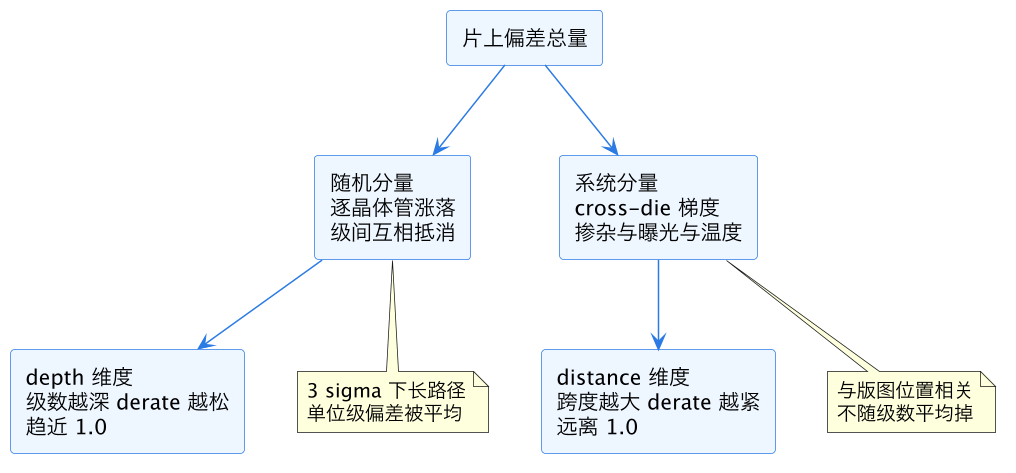
这张图是整张 AOCV 表的「世界观」:偏差拆成随机和系统两个分量,各自映射到一个表维度。读图时注意一点——depth 和 distance 不是对称的:随机分量随级数以接近 1/sqrt(N) 的速度被平均,所以 depth 轴的 derate 曲线下降很快;系统分量几乎不随级数衰减,只随距离增长,所以 distance 轴是另一套标定逻辑。后面两节分别展开。
二、生成数据通路:从 SPICE 到表格文件
AOCV 表的原料是延迟分布数据,产出是签核工具能加载的表格文件(PrimeTime 是 AOCV 格式文件,Tempus 是对应的 liberty 扩展或独立文件)。中间的产线分四步。
第一步,选代表性电路模板。不是对每个单元都仿真,而是挑一组「特征化测试电路」:通常是不同驱动强度的反相器链、NAND/NOR 链、以及不同线长负载的级联结构,覆盖设计里实际出现的 slew 范围和负载范围。模板选得偏,表就偏——这是生成质量的第一道关口。
第二步,SPICE 统计仿真。对每个模板跑蒙特卡洛或参数化扫描:器件模型用 foundry 提供的带 mismatch 与 local variation 的统计模型(和 Liberty 特征化流程 用的同一套 PDK 模型,但这里要开统计开关),仿真几百到几千次抽样,得到每级延迟的分布。同时做敏感性分解:把距离相关的系统性参数(比如跨 die 的 Vth 梯度带)单独扫描,把纯随机分量分离出来——这一步的分解质量直接决定两个维度能不能干净地各管各的。
第三步,换算成 derate 系数。对每条模板路径,比较「3-sigma 统计签核口径的延迟」和「名义延迟」,比值就是该级数下的 derate。把不同模板、不同级数、不同距离分箱的结果汇总、插值、拟合,填成表。
第四步,格式转换与交付。签核工具(PrimeTime 侧常见做法是用其自带的 AOCV 表征 utility 或厂商/内部脚本)把拟合结果写成工具格式,带 object type(lib cell / net / clock / data)、delay type(cell / net)、路径类型(rise/fall、early/late)等限定字段。
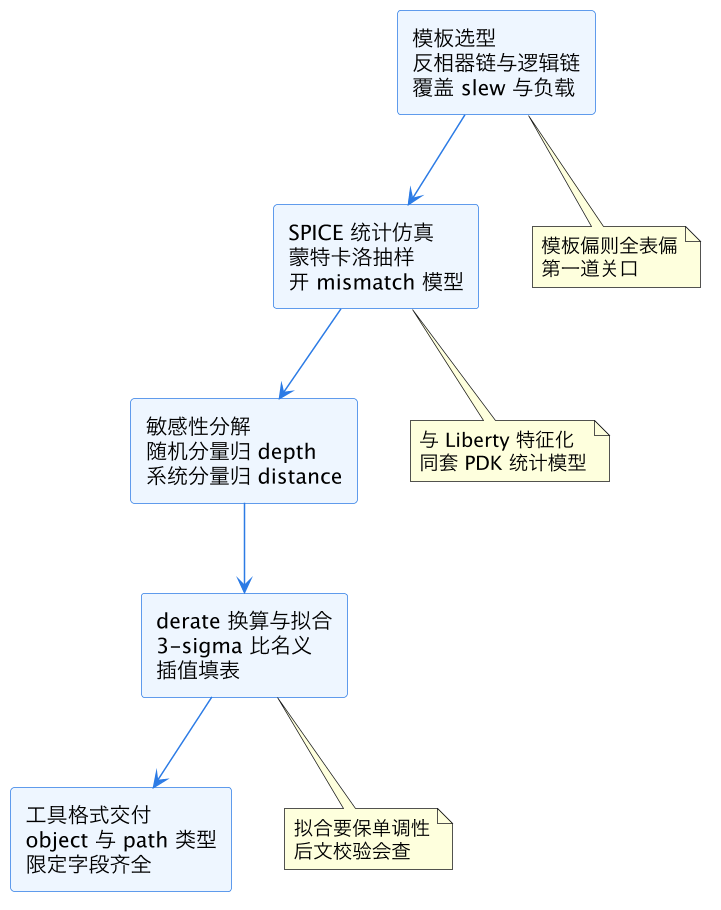
这张图是生成产线的全貌。要盯住的工程质量点在中间两步:敏感性分解如果切不干净(随机分量里残留系统性趋势,或反过来),两个维度就会互相「抢」悲观度,表现为表里出现反直觉的凹凸;拟合步骤如果用了过激的外推,表边缘格子(很深的级数、很远的距离)会出现比中心格子还松的怪值。这两个毛病都是签核前校验要抓的,第四节细讲。
三、depth 与 distance 维度怎么标定
depth 轴的标定逻辑是统计平均。设每级延迟的随机偏差(归一化标准差)为 sigma_1,N 级串联、各级偏差独立同分布时,总延迟的相对标准差约为 sigma_1 / sqrt(N)。3-sigma 签核口径下,derate 大致按 1 + 3 × sigma_1 / sqrt(N) 的形状随级数下降。所以标定时 depth 轴的采样点不需要均匀:级数小的区间(1 到 10 级)derate 变化剧烈,要密排(每 1-2 级一个点);级数大的区间(20 级以上)曲线已经很平,5 到 10 级一个点就够。典型先进工艺节点下,1 级的 cell derate 可能在 1.15-1.25,10 级降到 1.05 左右,30 级以上基本贴到 1.02-1.03 的平台。表不能无限延伸,超出最深采样点的路径由工具按最深档取值——这是「表外路径怎么算」的答案,也提示标定时最深档必须采到真正收敛的平台区,否则长路径全被错杀。
distance 轴的标定逻辑是系统性梯度。从 foundry 的 process variation data 或 testchip 实测里提取 cross-die 参数梯度(比如每毫米 Vth 漂移多少毫伏),折算成延迟对距离的敏感性。分箱粒度是核心工程决策:箱子太粗(比如只有「< 500 微米」和「>= 500 微米」两档),中长距离路径被一档拉平,精度浪费;箱子太细(每 50 微米一档),表项爆炸且很多格子根本没有足够仿真样本支撑,插值噪声反而大。经验做法是按设计的实际尺寸定 3-6 档:最大档覆盖 die 对角线,中间档按梯度曲线变化率大的区间加密。还要注意 distance 的度量口径必须和签核工具一致——多数工具用路径起点与终点的曼哈顿距离或包围盒对角线,生成侧如果用欧氏距离标定而工具按曼哈顿查表,系统性错配就来了。
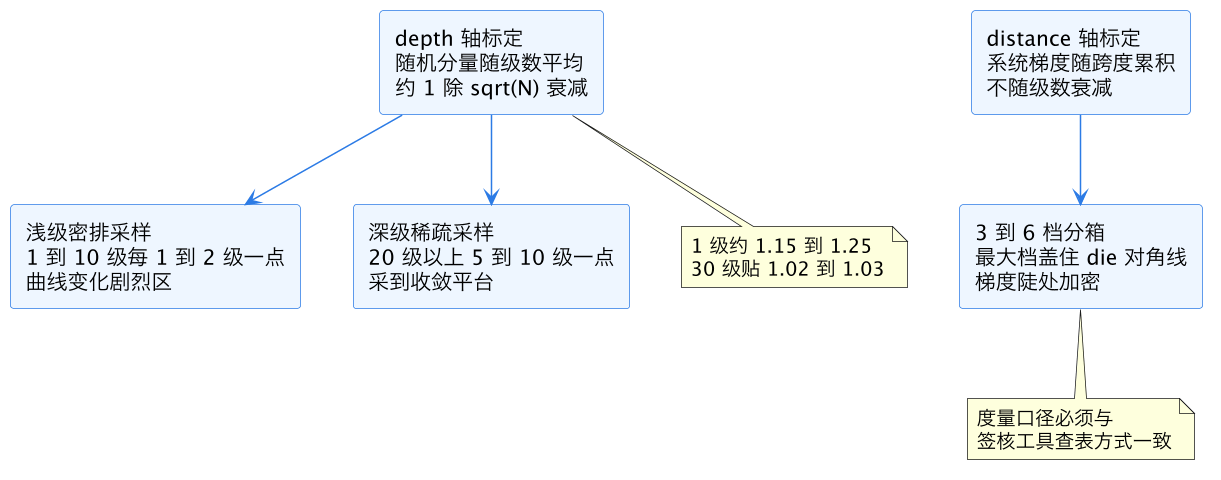
这张图把两个维度的标定策略并排摆开。核心记忆点:depth 轴是「曲线拟合」问题(按 1/sqrt(N) 的已知形状采样),distance 轴是「分箱覆盖」问题(按梯度分布和 die 尺寸切档)。表格的每一个格子都是这两条轴标定结果的乘积(或合成,视工具的 derate 合成规则),轴定错了,格子全错。
| 标定决策 | 定粗了的后果 | 定细了的后果 | 经验起点 |
|---|---|---|---|
| depth 采样密度 | 浅级路径 derate 跳变、时序忽松忽紧 | 仿真量爆炸、拟合过平滑 | 1-10 级密排,20 级以上稀疏 |
| depth 最深档 | 长路径全取错值(偏松或偏紧) | 浪费仿真在深区 | 采到 derate 变化小于 0.5% 的平台 |
| distance 分箱数 | 中距路径被一档拉平 | 空格子多、插值噪声大 | 3-6 档,随 die 尺寸定 |
| distance 度量口径 | 与工具查表系统性错配 | ——(不存在过细) | 照抄签核工具文档的口径 |
四、签核前校验:怎么证明表是对的
表生成完只是半成品,交付签核前必须过一组校验,每一组对应一类失效模式。
第一类校验:蒙特卡洛对拍(Monte Carlo vs AOCV)。挑几十条代表性真实路径(覆盖不同级数、不同距离、不同时钟域),用 SPICE 或统计 STA 引擎(比如 POCV/LVF 口径,见 SOCV 与 LVF 矩方法 和 derate 建模与 POCV)算出 3-sigma 延迟作为金标准,再让签核工具加载这张 AOCV 表算同一路径的延迟,两者偏差应落在工程容差内(常见判据:数据路径延迟偏差 < 2-3%,且方向一致——AOCV 只允许比金标准略悲观,不允许乐观)。系统性乐观是最危险的失效,意味着签核在放水。
第二类校验:单调性与平滑性。固定 distance 扫 depth 轴,derate 必须单调不降地趋近 1(级数越多越松,反向即错);固定 depth 扫 distance 轴,derate 必须单调不增地远离 1(距离越远越紧)。出现凹凸说明敏感性分解或拟合出了问题。顺带查表值范围:所有系数必须落在物理合理区间(比如 cell derate 不小于 1.0、不大于浅级 3-sigma 上界)。
第三类校验:覆盖率。用真实设计的时序路径分布做直方图,确认 99% 以上的路径级数和跨度落在表的定义域内;表外路径虽然工具会按边缘档取值,但如果占比可观(比如超过 1%),说明表的设计域定小了。
第四类校验:工具加载自检。把表喂给 PrimeTime(read_aocvm)后用 report_aocvm 类的报告核对:对象类型映射对不对(clock/data、cell/net、rise/fall 各自的表是否都加载上了)、单位对不对(距离单位是微米还是毫米,历史上翻过车)、对拍几条手工计算的路径验证工具查表插值和预期一致。配合 CRPR 时钟重汇聚 检查,确认 derate 没有在公共时钟段被错误地叠加——CRPR 会削掉公共段的悲观度,表生成侧如果按全路径标定而工具按 CRPR 后口径应用,会双重计悲观。
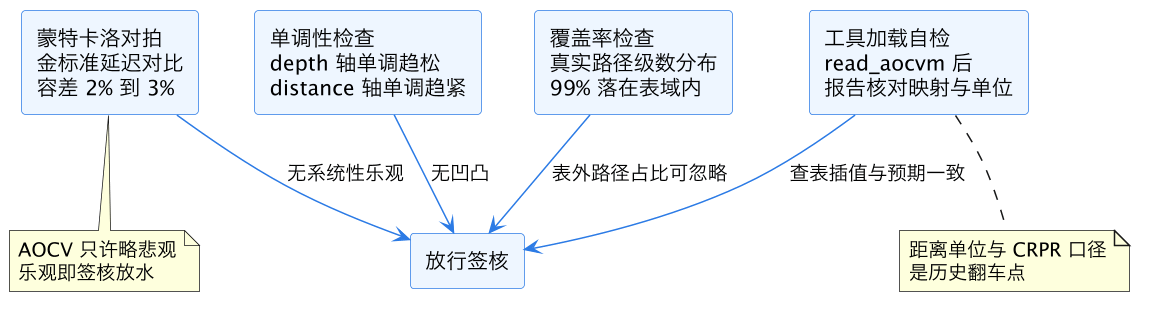
这张图是四道校验闸门,全部绿了表才能进签核。实战里最常见的放行拦路虎是蒙特卡洛对拍不过:偏差方向不一致时,先怀疑模板选型是否覆盖了失败路径的 slew/负载区间,再怀疑两个维度的敏感性分解是否干净,最后才怀疑拟合——排查顺序反过来会浪费大量重仿真。
五、表的运维:版本、corner 与流程集成
AOCV 表不是一次性产物。它挂在 PDK 统计模型版本上——模型升级(foundry 每季度或每半年更新 mismatch 参数),表必须重生成并重对拍;它也挂在 corner 上——每个签核 corner(SS/TT/FF 乘以电压温度组合)各有一张表,不能拿 TT 的表给 SS 用,这和 数据流 X2 之 corners 与 MMMC 的多角分析框架对齐:AOCV 表文件是 MMMC 配置里和 .lib、SDC 并列的输入。流程集成上,表文件要进版本管理、进 签核收敛数据流 的交付清单,任何 ECO 后重签核(见 Signoff 收敛 ECO)都用同一版本的表——混用不同版本表的签核结果不可比,QoR 趋势图会骗人。
还有一个方向性判断要知道:AOCV 正在被基于矩的统计方法(LVF/SOCV)逐步取代,后者直接在 .lib 里携带每级延迟的统计矩,不再查表。但 AOCV 因工具成熟、表文件轻、流程惯性大,在相当长的过渡期里仍是主力——这也是为什么「会生成、会校验 AOCV 表」至今仍是签核工程师的硬技能。
这一篇在知识体系里的位置
本篇是 eda/ 目录签核线的「表生成侧」专文,与概念使用侧的 OCV 与 AOCV 深度降额 互补:那篇回答「为什么查表、怎么查」,本篇回答「表怎么造、怎么验」。上游接 Liberty 特征化流程(同一套 PDK 统计模型)与 Liberty NLDM/CCS 时序模型(名义延迟的载体),横向连接 derate 方法学谱系的 derate 建模与 POCV、SOCV 与 LVF 矩方法,校验环节依赖 CRPR 时钟重汇聚 的口径,落地侧进 Signoff STA 与 PrimeTime、MMMC 配置 与 签核收敛数据流。读完本篇,一张 AOCV 表从 SPICE 网表到签核报告里的每个 derate 数字,你都能说出它的来历。
总结
AOCV 表生成是一条「模板选型 → SPICE 统计仿真 → 随机/系统敏感性分解 → 按 depth 与 distance 两维标定拟合 → 工具格式交付」的产线:depth 轴吸收随机分量的 1/sqrt(N) 平均效应(浅级密排采样、采到收敛平台),distance 轴吸收 cross-die 系统性梯度(3-6 档分箱、度量口径与签核工具一致);表交付签核前必须过四道校验——蒙特卡洛对拍只许略悲观不许乐观、两轴单调性无凹凸、真实路径覆盖率 99% 以上、工具加载后映射与单位核对无误——并按 PDK 模型版本与 corner 逐张重生成、进版本管理随 MMMC 配置一起交付,才能保证几千条路径查出来的每一个 derate 系数都有出生证明。