vectorless IR 分析:无向量与有向量 IR-drop 的取舍、覆盖率与悲观度
本篇是电源完整性签核的纵深篇。工具链全景(PrimePower/Voltus/RedHawk、SAIF/FSDB 反标、EM 收口)见 功耗签核工具,电源网格规划见 floorplan 与电源规划。本篇只聚焦一个问题:IR-drop 分析的活动率激励从哪来——不喂向量的 vectorless 模式与反标仿真波形的 vector-based 模式,各自把什么算准了、把什么算悲观了。
本文要回答的问题
- vectorless IR 分析不喂向量,活动率是怎么「编」出来的?
- vector-based 模式用真实仿真波形,为什么还可能漏掉峰值?
- 两种模式在覆盖率与悲观度上的根本差异是什么?
- 设计早期、签核期分别该用哪种模式,怎么组合?
- vectorless 结果偏悲观时,工程上怎么把它「拧回」合理区间?
一、IR-drop 为什么离不开活动率
IR-drop 的本质是电流流过电源网络的电阻产生的压降。动态功耗 P∝αCV²f 里的 α(活动率,一个时钟周期内信号翻转的概率)直接决定每个实例在每一拍抽多少电流。同一块电路,α=0.1 和 α=0.5 的电流差 5 倍,算出来的压降天差地别。
问题在于:签核工具面对的是几亿个实例,活动率必须逐实例给出。这数据只有两个来源——要么从仿真波形里量出来(vector-based),要么按统计规则编出来(vectorless)。两种来源决定了两种模式的全部分歧。
先给一个量级感受:一个中等规模 SoC 顶层大约 5000 万实例,动态 IR 求解时每个实例每一拍都是一个电流源。手工指定活动率完全不可行,所以两种模式本质上都是在回答「这 5000 万个 α 从哪来」。业界经验值是:处理器核心在全速跑 Dhrystone 类负载时平均翻转率约 0.15~0.25,视频编解码数据通路可到 0.3 以上,而配置寄存器、调试逻辑常年低于 0.01。同一片芯片内部差异就有一个数量级以上——这就是为什么「用一个默认翻转率代表全芯片」必然失真,也是 vectorless 需要精心校准的根本原因。
还要注意静态 IR 与动态 IR 对活动率的依赖程度不同:静态 IR 用平均电流,vectorless 的均值估计通常够用;动态 IR 要抓纳秒级的瞬时塌陷,依赖时间相关的翻转事件,这正是 vectorless 天然给不出、只能靠峰值因子近似的地方。本篇后面谈覆盖率时,默认语境是动态 IR——它是签核里真正的难点。
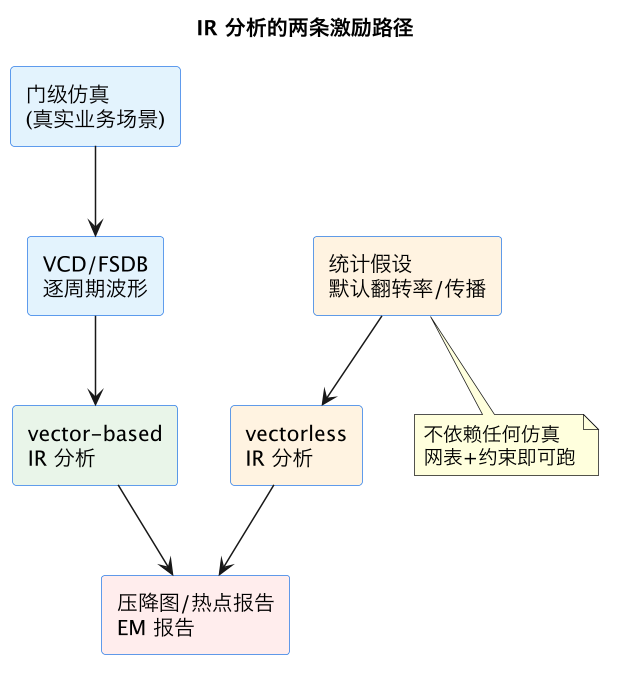
上图里左支是 vector-based:仿真产出逐周期波形,反标到门级网表,每个实例的活动率都是「量出来的」。右支是 vectorless:工具从时钟、SDC 约束和默认翻转率出发,沿组合逻辑逐级传播出每个 net 的翻转率估计,是「算出来的」。两条路径最终汇入同一个电阻网络求解器,产出压降图。
二、vectorless:活动率是怎么编出来的
vectorless 模式的核心是一套活动率传播引擎,步骤大致是:
- 起点给定:所有时钟按 SDC 定义的频率取 100% 翻转率(时钟每周期必翻);输入端口给一个默认翻转率(常见 0.1~0.2)或用户指定的场景翻转率。
- 逐级传播:组合逻辑按布尔函数传播——与门输出翻转率受输入相关性抑制,或门、异或门各有传播公式;时序单元的输出按输入活动率与状态概率折算。
- 状态概率:除翻转率外还要估计每个信号停在 0/1 的概率(影响内部功耗与泄漏加权)。
- 时钟门控处理:ICG(集成时钟门控单元)的使能活动率决定下游寄存器被「冻结」的比例,这是 vectorless 最容易悲观或乐观的分歧点。
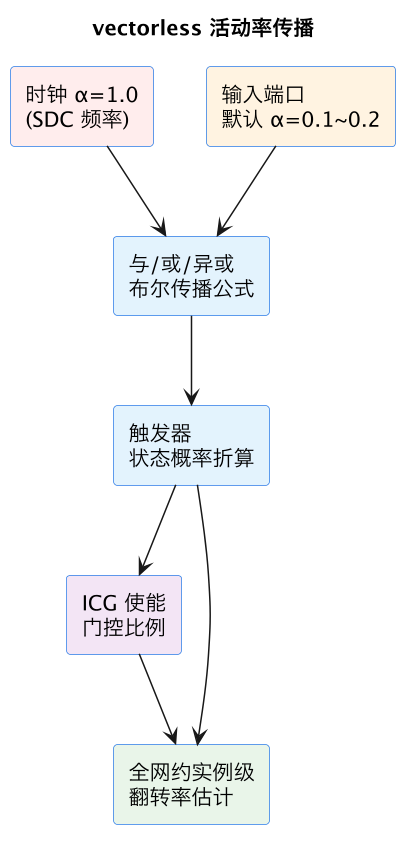
传播出来的结果有几个固有特征:它不知道数据的相关性(总线高位在真实业务里可能整小时不动,工具却按独立随机信号给翻转率)、不知道模式(处理器在 idle 与全速译码时活动率差一个数量级,工具只给一个均值)、对 deep 组合逻辑趋于高估(glitch 翻转的传播模型通常偏保守)。这些特征叠起来,就是后面要谈的悲观度来源。
举个具体例子:一个 64 位地址总线,真实业务里高 32 位在很长一段时间内是常量(访问集中在几个内存区域),但 vectorless 会把 64 根线都按默认翻转率算。假设默认 0.1,工具就认为这 64 根线每周期平均翻转 6.4 次,而实际可能只有低 16 位在动、平均 1.6 次——仅这一条总线,电流就被高估 4 倍。芯片里这样的总线有几百条,误差会层层累加。反过来,vectorless 也有低估的角落:如果 SDC 里漏定义了某个派生时钟,对应时钟域的活动率会被当成 0,那个域的 IR 直接消失——所以跑 vectorless 前先做约束完整性检查(时钟定义、ICG 使能、case analysis)是硬性前置步骤,漏约束造成的乐观比传播模型的悲观危险得多。
三、vector-based:真实波形为什么也可能漏峰
vector-based 模式把门级仿真的 VCD/FSDB 波形反标到网表,每个实例在每一纳秒翻转了几次都是实测值。精度是它的强项,但它的软肋在场景代表性:
- 窗口太短:一次动态 IR 分析通常只取几十到几百纳秒的仿真窗口,而真实芯片的峰值电流事件可能几小时才出现一次(比如中断风暴叠加 DMA 全速)。
- 场景选错就全盘偏乐观:用 idle 场景的波形做签核,压降当然漂亮,但毫无意义。向量必须覆盖「最坏合理业务」——全核满负荷、外设全开、PLL 锁定后的稳定大电流。
- 反标映射损耗:RTL 仿真出的波形映射到门级网表时,综合改名、优化掉的寄存器会造成活动率丢失,映射率掉到 90% 以下就要警惕。
- glitch 覆盖:门级仿真能捕捉毛刺翻转,RTL 仿真不能——用 RTL 波形做动态 IR,瞬时电流尖峰会被系统性低估。
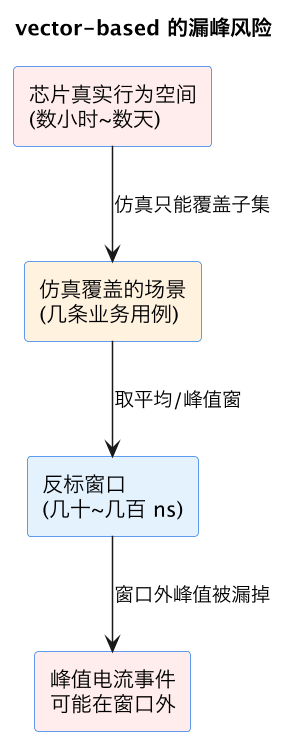
一句话:vector-based 把「被测到的部分」算得很准,但测不到的部分它就当不存在。它的悲观度低、覆盖率低;vectorless 恰好相反。
工程上补救场景代表性的办法是多向量签核:不只跑一条「最坏场景」,而是跑一组场景——全速计算、内存搬运、外设并发、睡眠唤醒瞬态——每个场景各出一张压降图,然后取包络(envelope,逐点取最坏值)作为最终签核依据。包络图比任何单一场景都更接近硅后实测。代价也很直白:每个场景都要一次门级仿真加一次动态 IR 求解,周期以天计。所以场景怎么选成了真正的手艺活——选少了漏峰,选多了跑不完。常见做法是先用 vectorless 的全芯片热点图缩小嫌疑区域,再针对热点区域反推「什么样的业务能激发这个区域的并发翻转」,有的放矢地设计仿真场景,这比拍脑袋堆场景高效得多。
另一个常被忽视的细节是反标窗口的对齐:动态 IR 要取波形里电流最大的窗口,而不是开头随便截取一段。仿真前几微秒往往是复位和初始化,活动率异常高但没有业务意义;直接全窗口取峰值会把复位瞬态当成签核结论,白白制造假超标。规范做法是先出平均电流随时间的曲线,人工确认窗口落在稳定业务段。
四、覆盖率与悲观度:两种模式的根本对照
| 维度 | vectorless | vector-based |
|---|---|---|
| 活动率来源 | 统计传播(时钟 100%、端口默认值、布尔公式) | 仿真波形实测反标 |
| 覆盖率 | 全网约 100% 实例,无遗漏 | 只覆盖仿真激励到翻转的逻辑 |
| 时间相关性 | 无(平均行为)或粗略峰值因子 | 有逐周期事件,可抓瞬时塌陷 |
| 悲观度 | 偏悲观(高估 1.2~2 倍常见) | 接近真实,但依赖场景 |
| 运行门槛 | 网表+约束即可跑,几小时出结果 | 需先跑通门级仿真并反标,周期长 |
| 适用阶段 | floorplan/早期电源规划、签核兜底 | 签核期平均功耗与动态 IR 定案 |
悲观度的具体来源值得拆开看,因为工程上「拧回去」就靠逐项核对:
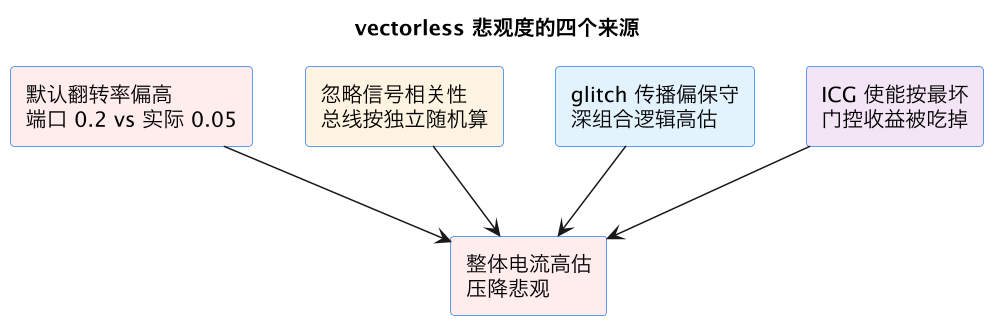
逐项对应的修正手段是:用真实业务的统计翻转率替换端口默认值(很多团队用历史项目的实测均值);对已知低活动总线(配置寄存器、调试口)单独指定翻转率;给 ICG 使能一个合理的活动率而非最坏的 100%;用 vector-based 结果校准 vectorless 的全局缩放因子。校准之后,vectorless 从「只能看相对热点」升级为「绝对值也可参考」。
五、工程上怎么组合:阶段化的双轨策略
实际项目里两种模式不是二选一,而是按阶段分工:
- floorplan 阶段(门级网表都还没有,或只有初版):只能跑 vectorless。用保守假设定电源网格密度、stripe 宽度、焊盘数量——这个阶段宁可悲观,因为网格布少了后期加不动。
- place & route 后:vectorless 快速扫一遍全芯片热点图,定位需要加 decap(去耦电容)的区域;同时启动门级仿真,为 vector-based 准备波形。
- 签核期:vector-based 用代表性场景定案平均功耗与动态 IR;vectorless 作为兜底检查——它覆盖仿真没激励到的逻辑,防止「仿真没跑到的地方其实有热点」。
- 差异仲裁:两种模式结果差 30% 以内算正常;vectorless 高出 2 倍以上,先查翻转率假设再查网格;vector-based 反而更高,说明仿真场景里确有极端并发,要信 vector-based。
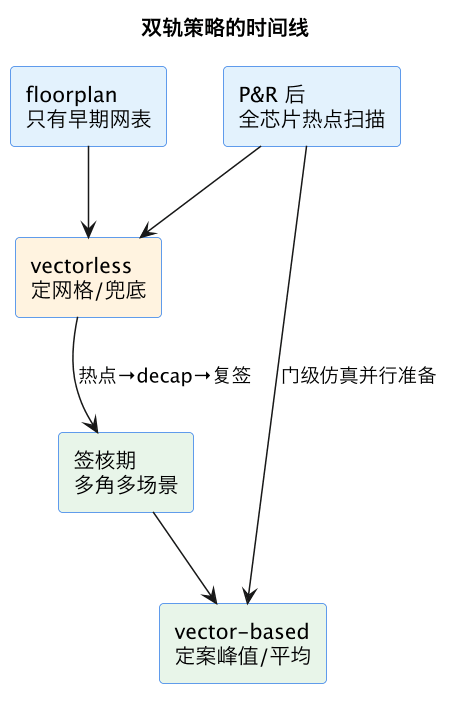
这条时间线里有一个容易踩的坑:floorplan 阶段按 vectorless 悲观值布的网格,签核期 vector-based 结果宽松之后不要回头拆网格——硅后实测的峰值往往比任何仿真都狠,网格余量是电源完整性里最便宜的保险。反过来,签核期发现 vector-based 也超标,修复手段(局部 decap、错峰、时钟门控)落地后必须两种模式都重跑一遍才算闭环。
最后一层联动是和时序签核的闭环。IR 压降让单元实际供电低于标称电压,单元变慢,STA 若不考虑这个降额就是乐观的。先进流程会把 vector-based 动态 IR 的逐实例压降反标进时序(IR-aware STA),或用热点区域的最大压降做统一的电压降额。这里两种模式的分工同样清晰:降额值取 vector-based 场景包络的实测压降,vectorless 的全覆盖结果用来确认没有仿真之外的更坏角落。改网格、加 decap 之后寄生参数变了,时序和 IR 要一起重签——这个回路在收口阶段通常会转 2~3 轮,预留好迭代时间比纠结单轮精度更重要。
六、这一篇在知识体系里的位置
本篇上接 功耗签核工具(工具链与 SAIF/FSDB 反标的完整流程)与 floorplan 与电源规划(电源网格怎么布),下接活动数据格式篇 VCD/SAIF 活动数据(波形到翻转率的格式细节)。概念侧的电压降物理背景见芯片设计知识树的电源完整性条目;时序侧,IR 压降最终以电压降额形式进入 STA 签核,见 静态时序分析。
总结
vectorless IR 分析用时钟全翻、端口默认值加布尔传播公式编出全网活动率,换来无需仿真、几小时全覆盖的速度与 100% 实例覆盖,代价是忽略信号相关性和业务模式导致的 1.2~2 倍悲观;vector-based 反标门级仿真波形,把测到的部分算得很准,却受限于场景代表性与反标窗口,漏峰风险在窗口之外。工程上的正确姿势是双轨:floorplan 期用 vectorless 保守值定电源网格,P&R 后用它扫全芯片热点并校准翻转率假设,签核期用 vector-based 的代表性场景定案、用 vectorless 兜底仿真未覆盖的逻辑,两者差异超 2 倍时逐项核对翻转率、门控使能与网格假设,修复后双模式复签闭环——网格余量宁可留多,因为硅后峰值永远比仿真狠。