AXI-Stream 位宽适配:窄到宽聚合、宽到窄拆分与反压下的 RTL 结构
更新时间:2026-09-25。本文是「集成电路大类 · 芯片设计」序列的一篇数据通路中级文。AXI4、AXI4-Lite、AXI4-Stream 三份规约的关系见 AXI4-Lite 从机设计、AXI4 总线基础 与 AXI4-Stream 与 DMA;配套的宽到窄专题见 AXI-Stream 位宽适配器(downsize 专篇)。
本文要回答的问题
- 窄口连续来的多个拍,凭什么规则攒成一个宽拍?帧尾落在半中间怎么办?
- 一个宽拍拆成多个窄拍时,一拍多发的节奏与 TLAST 位置怎么定?
- 下游反压时,转换器两侧的 ready 如何互相牵动,寄存器切片和 skid buffer 加在哪?
- 比例不是 2 的幂、甚至不是整数倍(如 24 位对 32 位)时,电路怎么处理?
- 聚合器与拆包器的 RTL 内部,到底有哪些寄存器和计数器?
一、问题的起点:字节率守恒
DMA 常用 512 位接口批量搬运,加速器内部只吃 64 位;传感器输出 8 位码流,却要拼成 64 位写入内存。每一级都按自己的面积、频率和带宽需求选择最舒服的数据宽度,宽度不一致的接缝处就放一个位宽适配器(width converter):窄到宽叫聚合器(upsizer),宽到窄叫拆包器(downsizer)。
适配器的第一性原理是字节率守恒:每秒通过接口的字节数 = 位宽(字节)× 拍速。窄口高频多拍与宽口低频少拍可以等价,但适配器只能改变宽度与拍速的配比,改变不了平均字节率。窄口喂不饱宽口时,宽口一定稀疏;宽口供给超过窄口消化能力时,窄口一定反压。理解这一点,后面所有时序现象都不用背。
给一组具体数字感受配比:32 位接口跑 250 MHz,峰值是 1 GB/s;128 位接口只需跑 62.5 MHz 就能达到同样字节率。聚合器在这条链路里要做的事,就是把每 4 个 250 MHz 的窄拍换成 1 个 62.5 MHz 的宽拍——若两侧同频,则宽口每 4 拍才出现 1 个有效拍,其余 3 拍空闲,这不是设计缺陷,而是宽度换算的必然结果。反之,拆包器把一个宽拍重新展开成连续 4 个窄拍,窄口拍速必须是宽口的 4 倍才不积压。
二、窄到宽聚合:攒拍寄存器 + 拍数计数
以 32→128 位、比例 R=4 为例。聚合器内部有两样东西:一个宽位宽的攒拍寄存器(pack),一个记录「当前宽拍已收几个窄拍」的计数器(beat_cnt,0 到 R−1)。
// 窄拍握手时,按 beat_cnt 写入对应的 32 位槽,keep 同步合并
integer i;
always @(posedge clk or negedge rst_n) begin
  if (!rst_n) begin
    beat_cnt <= 0;
    pack     <= 128'd0;
    pack_keep<= 16'd0;
  end else if (s_valid && s_ready) begin
    pack[beat_cnt*32 +: 32] <= s_data;
    pack_keep[beat_cnt*4 +: 4] <= s_keep;
    beat_cnt <= (s_last || beat_cnt==R-1) ? 0 : beat_cnt + 1;
  end
end
聚合器输出一个宽拍有两个触发条件,二者是「或」的关系:
- 攒满触发:beat_cnt 计到 R−1,四个窄拍齐全,输出一个完整宽拍,m_keep 全 1(假设窄拍本身无空字节)。
- 帧尾触发:没攒满就收到 TLAST,必须立刻把半成品输出——缺失的高位槽位用 TKEEP=0 标记,TLAST 随这个残拍一起发出。不能等后面的拍来补齐,因为下一帧的第一个拍属于新帧,补进来就把帧边界抹掉了。
下图是聚合器的内部结构,注意帧尾通道(s_last)直接参与输出仲裁:

反压下的行为要分阶段看:宽拍还没攒满时,聚合器可以持续吃窄拍,此时宽口 m_valid 为低;一旦宽拍形成,只有宽口 m_ready 为高才能把它推走并清空攒拍寄存器——注意窄口 s_ready 在这几拍必须拉低,否则新来的窄拍会覆写尚未输出的槽位。
s_ready 的完整表达可以写成:宽拍未形成时恒为 1(只要复位完成就照单全收);宽拍已形成时等于 m_ready(宽口收得下才继续)。注意这里已经隐含了一条从 m_ready 到 s_ready 的组合路径,R 越大、槽位译码与 keep 合并逻辑越复杂,这条路径越长,这正是第五节要插入缓冲的直接原因。另外,残拍输出后 beat_cnt 必须归零、pack_keep 建议同步清零——虽然新帧写入时会覆盖对应槽位,但残留的 keep 位若未被覆盖(例如新帧第一拍又触发更早的残拍),会把上一帧的幽灵字节带进新宽拍。
零长帧是个边界中的边界:若上游在某拍同时给出 s_valid、s_last 且该拍 TKEEP 全 0,聚合器应不应该输出一个 keep=0、last=1 的空宽拍?规约不禁止,但必须与下游约定一致。多数 DMA 用它显式表达零长度 buffer,验证环境里应当定向构造这种激励,而不是假设它永远不会出现。
三、聚合时序:攒拍、残拍与反压停顿
下图是 32→64(R=2)的波形。窄口依次送出 A0、A1(第 0 帧的两个窄拍)、A2、A3、A4(第 1 帧,A4 带 TLAST 且只有 2 个有效字节)。宽口在攒满后输出 W0;A4 触发残拍 W1,其高 32 位 TKEEP=0。中间宽口反压一次,可以看到窄口在同一周期被顶住。
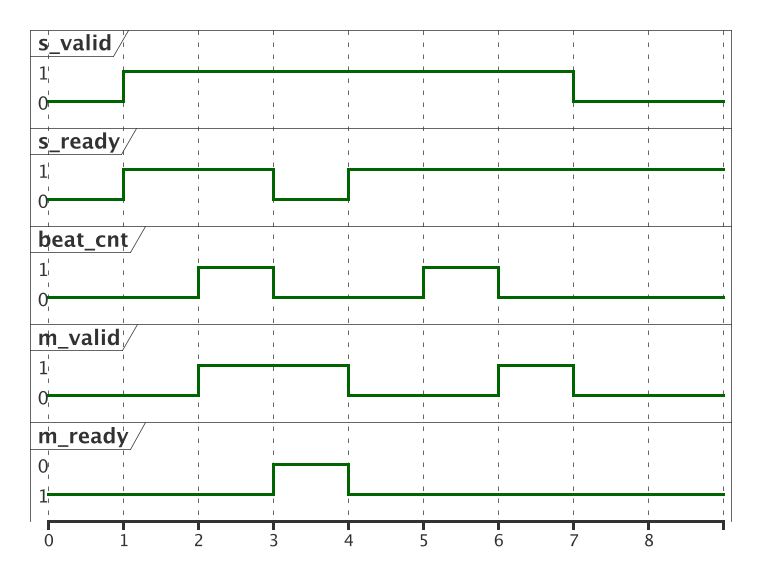
逐拍读图:T1 收下 A0,beat_cnt 进到 1;T2 A1 握手后宽拍 W0 形成,m_valid 拉起;T3 宽口反压(m_ready=0),W0 出不去,s_ready 同拍拉低,上游 A2 被顶在接口上保持不动——这就是反压沿转换器反向传播;T4 宽口恢复,W0 输出,s_ready 恢复,A2 在这拍才被收下;A2、A3 攒成下一个宽拍;A4 带 TLAST 到达后,T6 输出残拍 W1,高半槽 TKEEP=0、TLAST=1。整个过程中 TVALID「置起不许撤」,停滞只靠 ready 表达。
四、宽到窄拆分:锁存、切片选择与帧边界
64→32(R=2)方向反过来:拆包器先锁存一个完整宽拍到 hold 寄存器,再用选择计数器 sel(0 到 R−1)依次把各切片驱动到窄口,连续发完一个宽拍对应的全部窄拍后,才接收下一个宽拍。
// 宽拍锁存:仅在最后一个窄拍被收走、或当前无输出时换新
wire pop_last = m_valid && m_ready && (sel == R-1);
assign s_ready = (!m_valid) || (m_ready && sel==R-1);

always @(posedge clk) if (s_valid && s_ready) begin
  hold      <= s_data;
  hold_keep <= s_keep;
  hold_last <= s_last;
end

// sel 计数:每发走一个窄拍加一,发完归零
always @(posedge clk) begin
  if (m_valid && m_ready)
    sel <= (sel==R-1) ? 0 : sel + 1;
end

assign m_data = hold[sel*32 +: 32];
assign m_keep = hold_keep[sel*4 +: 4];
帧边界有两个细节,是拆包器验证中最常失败的点:
- TLAST 只在最后一个有效窄拍上拉起,条件是 hold_last 且当前切片是「最后一个 TKEEP 不全为 0 的切片」,而不是简单的 sel==R−1。残宽拍的高位切片 TKEEP 全 0,这些空拍不发,否则下游会收到不存在的假拍,DMA 的 buffer 长度也会算错。
- 一个宽拍的多个窄拍不可被抢占,必须按低到高的顺序连续发完。中途若插入别的帧数据,字节顺序和 TID 保序全部破坏。因此 s_ready 只在最后一个窄拍被收走的周期才对宽口开放。
下图给出拆包器的 RTL 结构:

「最后一个有效切片」在 RTL 里不需要复杂状态机:宽拍被锁存后,对每一段 keep 做归约或(|= 到 1 位),从最高槽位向下找到最后一个非零段的编号 last_valid_sel,它可以在锁存当拍组合算出并寄存;之后 m_last = hold_last && (sel == last_valid_sel),而 sel 在到达这个编号后直接归零、不再向更高的空切片推进。这样既不发空拍,也不会把一个宽拍拖成 R 个周期。
TID、TDEST、TUSER 在一帧之内保持不变、跨帧才可改变,因此锁存宽拍时要把它们一并寄存,随该宽拍拆出的所有窄拍下发。拆包专篇 AXI-Stream 位宽适配器(downsize) 里有残拍 keep 计算的完整代码。
五、反压下的寄存器切片与 Skid Buffer
转换器两侧 ready 的关系不是直连:聚合器攒满后 s_ready 受 m_ready 支配,拆包器未发完时 s_ready 必须为低。若直接把远端 ready 和内部计数做成长组合串,路径是 m_ready → s_ready → 上游 valid → …,链路一长频率就垮,极端情形还会和上游的 valid 逻辑构成组合环路。
工程上的标准做法是在输入、输出端各加一级缓冲,把长组合路径切断:
- 寄存器切片(register slice):一级带反压能力的流水寄存器,valid/ready 在本拍就地终结,时序路径不再跨越模块边界,代价是一拍延迟。
- Skid Buffer:两拍深度的半拍缓冲,正常时数据直通(零延迟),下游突然反压的那一拍把正在通过的数据「滑」进影子寄存器保存,既不丢数又切断了 ready 的反向组合路径。
缓冲在链路里的摆放位置有讲究:输入 skid 紧贴窄口,ready 只由 skid 的占用位(一格影子寄存器是否已存)驱动,远端 m_ready 经过 skid 后不再直接暴露给上游;输出寄存器切片放在核心与宽口之间,valid 在本拍就地寄存。两级缓冲把整条链路切成「上游 ↔ skid」「skid ↔ 核心」「核心 ↔ 切片」三段,每段的握手只跨一级寄存器,静态时序分析里不再出现跨越多个模块的 valid/ready 路径。
这就是商用 width converter IP 提供「lightweight / registered」两档配置的原因:轻量档省面积但允许气泡、ready 路径长;注册档加 skid 与切片,吞吐接近无气泡、频率高,代价是几拍延迟和少量寄存器。握手与反压的完整规则见 valid/ready 握手、AXI-Stream 反压握手时序 与 Skid Buffer 实现;多拍延迟的插桩见 AXI 寄存器切片。
选哪一档可以按数据通路的位置判断:位于 DMA 与计算核之间、长期满带宽跑的主通路,值得用注册档换取频率和无气泡吞吐;位于配置、状态等偶发流量的支路上,轻量档省下的寄存器更实在。档位选择本质是面积换时序,不存在免费的零气泡。
还要再强调一次第三节波形揭示的事实:如果两侧平均带宽本身不匹配,加多少 skid 都只是吸收瞬时抖动,补不了持续缺口。窄口长期供给不足时,宽口必然周期性空泡;持续的速率差要用弹性 FIFO 乃至跨时钟的异步 FIFO 来吸收,见 异步 FIFO 与 CDC。
六、比例问题:2 的幂、整数倍与非整数倍
| 比例类型 | 例子 | 实现方式 |
|---|---|---|
| 2 的幂倍 | 32→128(R=4) | beat_cnt/sel + 固定 barrel mux,最简单最常见 |
| 整数非 2 幂 | 32→96(R=3) | 同样计数,只是槽位数为 3,mux 输入多一档 |
| 非整数比 | 24↔32 位 | 字节 lane 粒度重排,按 LCM 宽度循环 |
| 互含非整数倍 | 40↔24 位 | 累积字节缓冲 + 按目的宽度切的 FIFO 式通用方案 |
非整数比是本节唯一需要新结构的情形。以 24 位对 32 位为例:24=3 字节、32=4 字节,二者的最小公倍数 LCM 是 12 字节(96 位),即 4 个 24 位拍 ↔ 3 个 32 位拍构成一个大循环。电路不能再按「整拍入槽」工作,而是维护一个字节粒度的累积缓冲和一个字节填充指针:输入拍的 3 个有效字节按指针连续写入缓冲,缓冲中攒够 4 个字节就切出一个 32 位拍,指针取模回卷;反方向同理。

这个循环在拍级节奏上不是整齐的「一拍换一拍」:24→32 方向,前 3 个输入拍分别攒出 3、2、1……个输出拍的节奏交错,平均 4 个输入拍对应 3 个输出拍,但任何一个 4 拍窗口内都可能出现某拍连发、某拍停顿。因此字节方案的输出侧天然带气泡,不能用「每 R 拍 1 个」的整数模型去检查性能,只能在 LCM 大循环上核对总字节数。仿真里至少要跑满若干个完整 LCM 循环,再在循环中途插入 TLAST 和随机反压,才能暴露指针回卷与残帧叠加的 bug。
AXI4-Stream 规约允许任何 8 位整数倍的数据宽度,非整数比在协议上完全合法;但字节 lane 展开会带来大量字节粒度的写使能和更宽的 mux,面积与功耗都不划算。所以架构设计时应尽量把两侧宽度选成 2 的幂,把非整数比留给确实无法回避的接口(某些传感器、串行协议解帧侧)。帧边界在字节方案里同样按字节传递 TKEEP:残帧的最后一个目的拍只置位实际存在的字节 lane,TLAST 挂在该拍上。两端宽度互不含整数倍关系时(例如 40 位对 24 位,LCM=120 位,循环长达 15 个字节槽),直接展开 LCM 缓冲代价过大,通用 IP 通常退化为一个浅 FIFO:输入按字节写入、输出按目的宽度读出,指针不再追求在固定周期回卷,而是由读写两端水位自由推进。这种 FIFO 式实现面积可控、天然支持反压,代价是延迟不固定。
七、验证清单与常见的坑
- 残拍 TKEEP 错:聚合时把缺失字节置成 1,下游读到未初始化垃圾;拆分时多发全 0 空拍或把 TLAST 挂在空拍上。
- TLAST 丢失或错位:聚合残帧没有立即输出,拆分后最后有效拍没带 last——DMA 无法关闭 buffer,帧长全部错位。
- 拆包中途被抢占:一个宽拍未拆完就放行 s_ready 接收新宽拍,字节顺序与 TID 保序被破坏。
- 反压丢数据:寄存器使能只写了
m_ready而非m_valid && m_ready,停滞拍被误清空。 - ready 组合环路/长路径:s_ready 直接由远端 m_ready 与计数器组合驱动,频率差甚至环路;加 skid buffer 以本地状态为支点断开。
- TID/TUSER 跨帧串台:sideband 没有随宽拍锁存,多流复用时一帧的标记发到另一帧。
- 误以为适配器能补带宽:字节率守恒不可违背,持续速率差只能靠 FIFO 或重新设计时钟频率解决。
这一篇在知识体系里的位置
- 协议基础:AXI4-Lite 从机设计、AXI4 总线基础、AXI4-Stream 与 DMA
- 同主题深文:downsize 拆包专篇、AXI 寄存器切片
- 握手与时序:valid/ready 握手、反压握手时序、Skid Buffer 实现
- 速率匹配与互连:异步 FIFO 与 CDC、AXI Crossbar
总结
AXI-Stream 位宽适配按字节率守恒做宽度换算:聚合器用攒拍寄存器加拍数计数,攒满 R 拍或提前遇 TLAST 就输出一个宽拍、缺失字节槽置 TKEEP=0;拆包器锁存宽拍后按 sel 连续切片发出、TLAST 只挂最后一个 TKEEP 非零的窄拍且空拍不发;反压时 ready 反向组合传播,用 skid buffer 和寄存器切片切断长路径并吸收气泡,但补不了持续带宽差;非整数倍比例退到字节 lane、按 LCM 宽度循环填充与排空。