UVM auto predict:RAL 镜像更新的自动与显式两条路怎么选
更新时间:2026-10-01。前面 UVM RAL desired 与 mirror 语义 讲清了寄存器模型里两个值的分工,UVM RAL frontdoor 与 backdoor 讲了读写访问的两条通路。这一篇回答紧接着的问题:镜像(mirror)值靠什么保持新鲜——让 sequence 自己更新(auto predict),还是接总线 monitor 被动观察(explicit prediction),两条路的连线方法、适用场景和踩坑实录。
本文要回答的问题
- UVM auto predict 到底在哪一行代码把镜像更新掉,它看见了什么、看不见什么?
- 显式 prediction 需要哪几个组件、怎么把 monitor 的 analysis port 接到 predictor?
- 同一环境里两条路怎么选,混用会怎样?
- 镜像不一致(mirror mismatch)报出来,先怀疑预测路径还是先怀疑 RTL?
一、镜像为什么需要「预测」:问题本身
UVM 寄存器抽象层(RAL,Register Abstraction Layer)给每个寄存器维护两个值:desired(期望写入值)和 mirrored(认为 DUT 当前值)。desired 好理解——sequence 调 write() 就把它改了。mirrored 难办:它声称代表 DUT 里的真实值,但寄存器模型在 Testbench 里,DUT 在 RTL 里,中间隔着一条总线。DUT 的值变了,模型不会自己知道。
而 mirror() 检查、get_mirrored_value() 采样、scoreboard 比对,全都依赖 mirrored 是准的。镜像一旦失真,后面所有基于镜像的验证逻辑都是在和一个幻觉对话。所以必须有一条「预测路径」:看到一次真实的寄存器访问,就把镜像同步更新一次。UVM 提供了两条标准路径,auto predict 和 explicit prediction,区别只在一件事上——谁看到的访问算数。
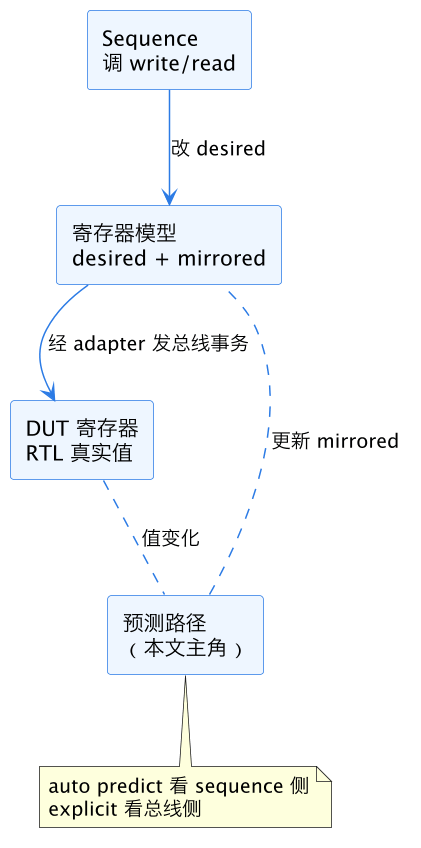
上图把位置关系摆清楚:预测路径是 DUT 到镜像之间唯一的回传通道。两条路线的差别就是这条通道架在哪——auto predict 架在 sequence 的发送侧,explicit prediction 架在总线的观察侧。
二、auto predict:最省事的一条路
auto predict 的开启只有一行:
// 在 env 的 build_phase,对整个 reg block 或单个寄存器开
regmodel.default_map.set_auto_predict(1);
// 或者在某个 map 上开
regmodel.APB.set_auto_predict(1);
开完之后,每当 sequence 通过 reg.write() / reg.read() / reg.update() 完成一次 frontdoor 访问,UVM 在访问结束的那一刻直接用 sequence 侧拿到的数据更新镜像:write 就把写入值抄进 mirrored(受字段访问策略约束,比如 W1C 字段做相应变换),read 就把读回值抄进去。不需要 monitor、不需要 predictor、不需要任何额外连线。
它的本质假设是:sequence 发起的访问一定会成功落到 DUT 上,且 DUT 不会背着模型改值。这个假设在很多场景成立,但也正是它的三个盲区:
- 总线错误看不见。sequence 发出一笔写,总线上被 SLVERR 拒绝,或者 adapter 把地址转错了——auto predict 只看 sequence 侧「发出去的值」,照样把镜像更新成期望成功后的样子。镜像和 DUT 从此分叉。
- 非 RAL 路径的访问看不见。另一个 VIP master(比如 DMA 引擎的激励)直接驱动总线写同一个寄存器,或者 RTL 内部逻辑自己改状态寄存器(中断标志位、计数器溢出清位)——sequence 完全没参与,镜像自然不更新。
- 后门访问默认不预测。backdoor 的 write/read 走
uvm_reg_backdoor,虽然它会自己同步镜像,但与 frontdoor 的 auto predict 路径是两套逻辑,混用时容易记错谁更新了谁,后门路径的细节见 UVM RAL frontdoor 与 backdoor。
还有一个隐蔽的语义坑:auto predict 发生在访问完成的回调里,用的是 sequence 侧的数据,而不是总线侧的回读。对 write() 来说,镜像被更新成「你写的值」;可如果 DUT 的字段带写副作用(比如写 1 清零的 W1C,或者只保留低 4 位的掩码字段),auto predict 会按字段访问策略做模拟计算——这套模拟逻辑和 RTL 的实现是两份代码,任何一份理解偏了,镜像就和 DUT 错位。read() 稍好,因为读回值来自 DUT,但读事务的镜像更新只发生在 sequence 显式调 read() 时;scoreboard 自己用 peek() 或底层 sequence 绕过 RAL 发总线读,镜像依旧纹丝不动。换句话说,auto predict 的正确性不仅依赖「访问成功」,还依赖「所有访问都从 RAL 的 frontdoor 过一遍」——环境里有任何一条旁路,镜像就开始撒谎。
什么时候用 auto predict 够用?环境只有一个 agent 通过 RAL 访问 DUT、寄存器几乎都是纯软件可读写的配置寄存器、总线上不会有错误注入——典型的 IP 级配置寄存器回归就长这样。省下的 predictor 连线和 monitor 依赖是真金白银的简洁。
三、explicit prediction:接总线 monitor 的标准接线
显式预测把「更新镜像」的依据从 sequence 侧挪到总线侧:不管谁发起的访问,只要 monitor 在总线上看见了一笔真实完成的寄存器事务,就用它更新镜像。这需要三个角色配合:
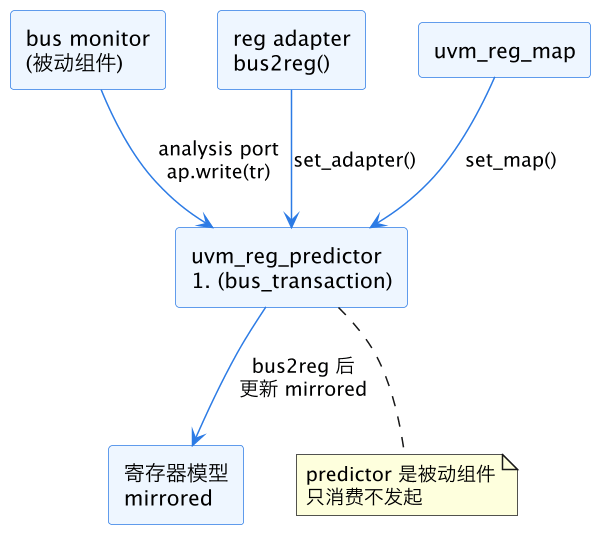
上图是显式预测的标准连线图,对应的 env 代码:
class my_env extends uvm_env;
  apb_agent              apb_agt;
  my_reg_model           regmodel;
  reg2apb_adapter        adapter;
  uvm_reg_predictor#(apb_transaction) apb_pred;

  virtual function void build_phase(uvm_phase phase);
    super.build_phase(phase);
    apb_agt  = apb_agent::type_id::create("apb_agt", this);
    adapter  = reg2apb_adapter::type_id::create("adapter");
    apb_pred = uvm_reg_predictor#(apb_transaction)::type_id::create("apb_pred", this);
  endfunction

  virtual function void connect_phase(uvm_phase phase);
    // 1. predictor 需要知道用哪个 map 做地址翻译
    apb_pred.map     = regmodel.APB;
    // 2. predictor 需要 adapter 把总线事务翻译成 uvm_reg_bus_op
    apb_pred.adapter = adapter;
    // 3. monitor 的 analysis port 连到 predictor 的 bus_in
    apb_agt.monitor.ap.connect(apb_pred.bus_in);
    // 注意:开了显式预测就不要再开 auto predict
    // regmodel.default_map.set_auto_predict(0);  // 默认即 0
  endfunction
endclass
三步连接缺一不可,每一步少了都对应一种经典故障:忘了 set_map——predictor 收到事务不知道查哪张地址表,镜像完全不更新且不一定报错;忘了 set_adapter——bus2reg 没法执行,同样静默失败;忘了 connect——predictor 是个死组件,环境里一切看起来正常,只有 mirror() 检查莫名失败。
预测器收到一笔总线事务后的处理流程值得展开:adapter 的 bus2reg() 把 APB/AHB 事务翻译成通用的 uvm_reg_bus_op(地址、数据、读/写、字节使能);predictor 拿地址去 map 里查命中哪个寄存器;命中后按字段访问策略更新 mirrored——RW 字段直接抄、RO 字段只在读事务时抄、W1C 字段按写一清零规则算。没命中的地址会被静默丢弃,这是「镜像不更新」排查时容易漏的一环:地址映射表本身错了,predictor 查不到寄存器,什么都不说。
四、两条路对比:选择依据一张表
两条路的根本差异是「信任谁」:auto predict 信任 sequence 的意图,explicit prediction 信任总线的事实。把选择依据归拢成一张表:
| 维度 | auto predict | explicit prediction |
|---|---|---|
| 更新依据 | sequence 发出的值 | monitor 观察到的实际事务 |
| 总线错误/重试 | 看不见,镜像照更 | 看得见,只预测成功事务 |
| 非 RAL 路径访问 | 看不见 | 看得见 |
| RTL 内部改寄存器 | 看不见 | 看得见(若会上总线) |
| 需要 monitor | 不需要 | 需要,且必须被动监听全流量 |
| 需要 adapter | 需要(frontdoor 用) | 需要(predictor 复用同一个) |
| 连线成本 | 一行 set_auto_predict(1) | map/adapter/connect 三步 |
| 典型场景 | 单一 master 的 IP 级配置回归 | 多 master、有中断/状态寄存器的系统级环境 |
有三类寄存器几乎强制要求显式预测。一是中断状态寄存器:RTL 收到中断源就置位,软件写一清零——DUT 侧的变化 sequence 完全不知情,auto predict 下镜像永远是旧的,mirror() 必炸。二是被多 master 共享的寄存器:比如两个核都能写的 mailbox,各自的 UVM 环境里 sequence 只知道自己写了什么,必须靠 monitor 看全量总线流量。三是错误注入场景:序列故意制造 SLVERR,auto predict 会把失败的写也预测成成功,显式预测配合带 status 判断的 adapter 才能预测对。
反过来,显式预测也有自己的前提:monitor 必须真的能看到所有相关流量。如果环境里某些寄存器走另一条总线(比如配置走 APB、状态走内部接口),那条总线上没有 monitor,显式预测照样有盲区——这时常见的折中是对该寄存器块单独写一小段预测逻辑(scoreboard 里手工调 predict()),或者在 sequence 里读写后手动 reg.predict(value) 兜底。
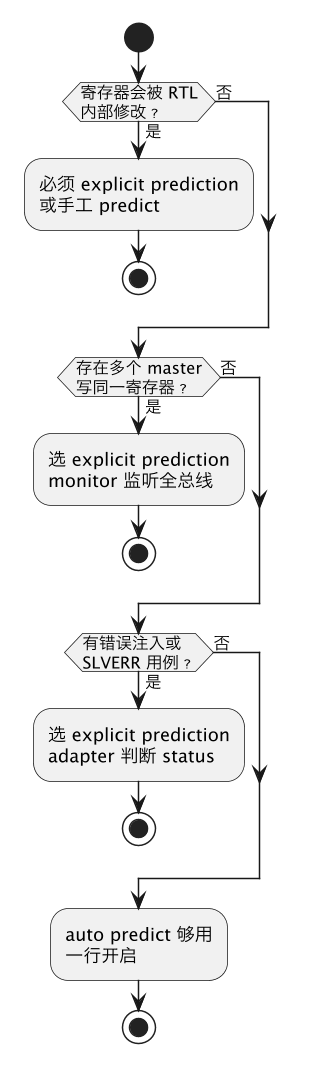
这张决策流程图可以直接贴进团队的环境搭建 checklist:三个问题按顺序问,任何一个答「是」就走向显式预测,都答「否」才用 auto predict。实际项目里系统级环境几乎都是显式预测收尾,auto predict 更多出现在 IP 级早期、monitor 还没就位的过渡阶段。
显式预测还有一层容易踩空的语义:predictor 预测的是 bus 事务,不是 RAL 事务。monitor 看到一笔 32 位写,predictor 就更新一次;一笔 burst 写拆成多拍,每一拍都会触发一次预测。这带来两个实操后果。一是字段级的字节使能(WSTRB)必须在 adapter 的 bus2reg 里正确翻译成 uvm_reg_bus_op 的 byte_en,否则 predictor 会把没被选中的字节也当成写入了——自制 adapter 里这是仅次于 status 处理的第二高发 bug。二是同一拍里 monitor 采样到的「写地址」和「写数据」若被拆成两个 analysis 事务发出,predictor 会预测两次、第二次用错误地址查 map 直接丢弃——monitor 侧必须保证「一笔完整事务一个 item」,这是写 bus monitor 的通用纪律,但挂 predictor 后违反它的代价从「scoreboard 比对乱」升级为「镜像静默失真」。
另外一个工程问题:多 map 场景。寄存器块同时挂在 APB 和 AHB 两张 map 上(双接口 IP 常见),predictor 的 set_map 只能给一张。正确做法是每个接口的 monitor 各挂一个 predictor 实例,各自 set_map 指向自己的 map——两个 predictor 实例互不知道对方存在,但它们最终更新同一份镜像,这正好是我们想要的「总线事实决定镜像」。
五、镜像不一致排查:先怀疑预测路径
uvm_reg::mirror(UVM_CHECK) 报 mismatch 时,报错信息长这样:
UVM_ERROR: Register "regmodel.CTRL.STATUS" value read from DUT (0x00000005)
does not match mirrored value (0x00000004)
先别急着怀疑 RTL。经验上 mismatch 的一半以上是预测路径的问题,按下面的顺序查命中率最高:
- 两条预测路同时开了。环境里既
set_auto_predict(1)又挂了 predictor——同一笔访问被预测两次。对 RW 字段无害,对 W1C、WO、带 side-effect 的字段就是双倍副作用,镜像直接算错。这是最经典的混用事故,检查方法很简单:全环境 grepset_auto_predict,开了显式预测就必须是 0。 - monitor 采样时机偏了。explicit 预测下,monitor 在地址相位就把事务发出来了,而 mirror 检查在数据相位后跑——predictor 还没更新镜像。表现为「偶发」mismatch,重跑 seed 又好了。修法是确认 monitor 在事务完成(PREADY 握手)后才
ap.write()。 - 地址没命中。predictor 静默丢弃查不到的事务。把
uvm_reg_predictor的 verbosity 调到 UVM_HIGH,或在 adapter 的bus2reg里加打印,看丢的是哪些地址——十有八九是 map 的基地址配错,对照 UVM 寄存器块与 map 结构 里的地址叠加规则查。 - RTL 真改了值。状态位、计数器、中断标志——这些字段镜像就该跟不上。正解不是关掉检查,而是把这类字段的 compare 关掉:
field.set_compare(UVM_NO_CHECK),让 mirror 只查软件可控字段,或者像前面说的转显式预测加手工兜底。 - adapter 的 status 处理。总线返回 SLVERR 时
bus2reg应该把 status 置成UVM_NOT_OK,predictor 默认不预测失败事务——如果自制 adapter 忘了这个分支,失败写也被预测,镜像又一次「谎报成功」。
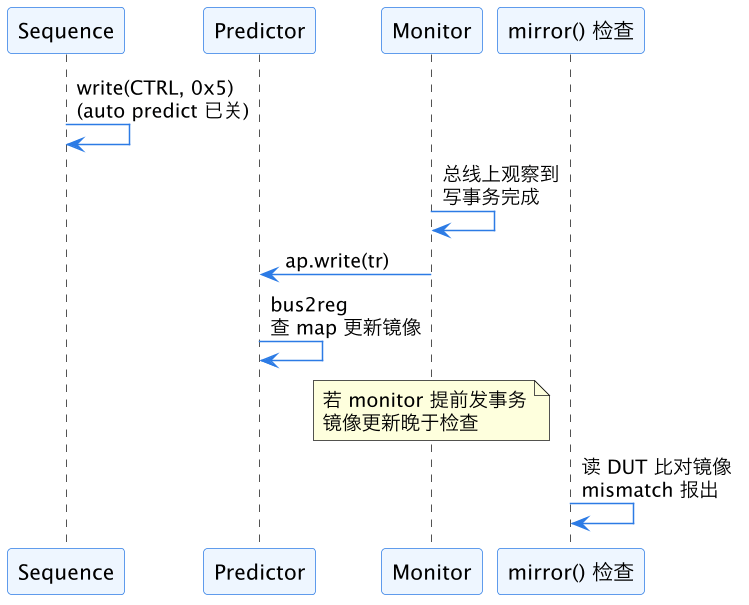
上图把时序竞争画出来:正常的显式预测链条是「monitor 观察 → predictor 更新 → mirror 比对」,任何一环顺序颠倒(monitor 提前发、检查跑得太快)都会出现偶发 mismatch。排查时把 predictor 和 mirror 的时间戳对齐打印,谁先谁后一目了然。
排查时还有两个工具性问题值得提前布防。一是给环境加一条「镜像健康度」自检:仿真结束时对关键寄存器做一次 mirror(UVM_CHECK) 终态检查,很多 mismatch 是运行中逐渐累积的,终态一次全亮出来,比散落在 log 中间的报错好定位得多。二是善用 predictor 的回调扩展:uvm_reg_predictor 本身只是个 uvm_subscriber,继承它重写 write() 或干脆在 pre_predict 回调里插桩,可以把每笔预测的寄存器名、旧值、新值打进 log——镜像失真的排查从「大海捞针」变成「看回放」。这个调试 log 建议在环境搭建第一天就加上,开关用 plusarg 控制,平时关、出问题时开,一次仿真的预测流水全部落盘,事后回放比加打印重跑省事得多。
六、工程实践:一个环境里的推荐姿势
综合下来,中大型环境值得照抄的姿势是:默认显式预测 + auto predict 全局关闭 + 手工 predict 兜底特殊路径。显式预测挂主总线 monitor,覆盖 90% 的访问;RTL 内部会改、且变化不上总线的寄存器(比如纯内部计数器),在该寄存器的 field 上 set_compare(UVM_NO_CHECK) 并配一段 scoreboard 逻辑在关键事件后手工 predict();sequence 里所有 backdoor 访问后紧跟一次显式 predict(),不让后门绕过预测路径。这样一个环境里「镜像怎么更新」只有一套心智模型,新人不用猜这个寄存器走的是哪条路,出了问题也有统一的排查入口——先看预测 log,再看 monitor 事务,最后才怀疑 RTL。
性能上也别忽视:显式预测意味着每笔总线事务都要过一遍 bus2reg 和 map 查找,大带宽总线(AXI 上跑满 outstanding)环境里 predictor 的查询开销可观。优化手段是给 predictor 前置一个地址过滤器——monitor 侧只把落在寄存器地址段的事务送进 bus_in,数据段流量直接丢掉,predictor 的压力通常能降一个数量级。
这一篇在知识体系里的位置
本篇是 UVM RAL 系列的预测机制篇。前置阅读:UVM RAL desired 与 mirror 语义(两个值是什么)、UVM RAL frontdoor 与 backdoor(访问怎么发出去)、UVM 寄存器块与 map 结构(predictor 查的那张地址表)。后续可接:UVM 寄存器覆盖率采样(预测路径顺带驱动覆盖率)、UVM 寄存器模型集成(整个模型挂进环境的完整流程)。
总结
UVM auto predict 是「sequence 发了什么就信什么」的一行开关,适合单 master 纯配置寄存器的简单环境;显式 prediction 用 uvm_reg_predictor 接总线 monitor 的 analysis port,靠「总线上真实发生了什么」更新镜像,是多 master、中断状态位、错误注入场景的唯一正确姿势——两条路绝不能同时开,镜像 mismatch 先查预测路径再怀疑 RTL。