状态机编码怎么选:binary/gray/one-hot 三编码 × 三规模综合实测
更新时间:2026-11-05。本文是「芯片设计 · 入门层」的一篇参数实测文。姊妹篇 状态机编码怎么选的四状态入门实测 在一台四状态 FSM 上演示了
fsm_encoding属性怎么影响综合结果,并抓到旧版 Yosys 不识别 gray 的静默降级;本篇把问题推进一层:不再只看一个规模,而是让同一台参数化 FSM 在 4、8、16 三档状态数下分别以 binary、gray、one-hot 三种编码落地,凑成 3×3 共九组真实综合加时序分析,回答「状态数涨到什么规模时,该换编码」。FSM 的基础概念(状态、Moore/Mealy、状态怎么数)见 有限状态机入门。
本文要回答的问题
- 状态机编码怎么选,能不能不靠经验法则,而按状态数量化出一条切换规则?
- binary、gray、one-hot 三种编码,在 4/8/16 态下触发器、单元数、面积实测各差多少?
- 同一份 RTL、同一个标准单元库、同一条 10 ns 时钟约束下,三种编码的 setup slack 谁更从容?
- gray 编码在什么规模下反超 binary,又在什么规模下被 binary 反超?
- 教学库的绝对频率数字能不能直接拿去做工程判断?不能的话,这些数据该怎么读?
先放一张结论卡,四个数字全部来自后文九组综合的真实输出:
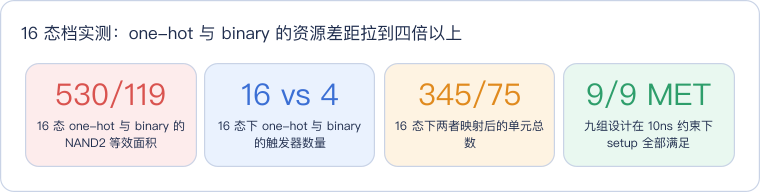
读这张卡抓两条主线:第一,状态数到 16 时,one-hot 用 16 个触发器对抗 binary 的 4 个,连带把单元总数和面积推到四倍以上,这是「one-hot 触发器随状态数线性膨胀」最直接的账单;第二,九组设计的 setup 检查全部 MET,说明在这条教学流程里没有谁撞穿时钟周期,编码之争比的是余量大小和资源代价,不是能不能跑。下面按实验设计、等价性、资源、时序、选型五段展开。
一、实验设计:同一份参数化 RTL,只换两个参数
对照实验最怕「设计不一样」。本次九组数据来自同一个模块 fsm_walker,RTL 一字不改,只通过两个参数生成全部变体:NSTATES 控制状态数(4/8/16),ENC 控制编码(0=binary,1=gray,2=one-hot)。模块实现的是一台有界线性往返控制器:状态 S0 到 S(N-1) 排成一条直线,go 有效时向前走一步并在末态钳住,back 有效时向后退一步并在 S0 钳住,两者都无效则停留,back 优先级高于 go。
module fsm_walker
#(
    parameter integer NSTATES  = 8,
    parameter integer ENC      = 0     // 0=BIN, 1=GRAY, 2=ONE-HOT
)(
    input  wire clk,
    input  wire rst_n,      // 同步复位,低有效
    input  wire go,         // 向前走
    input  wire back,       // 向后退(优先级高于 go)
    output wire at_first_o, // 状态 == S0
    output wire at_last_o,  // 状态 == S(NSTATES-1)
    output wire at_mid_o,   // 状态 == S(NSTATES/2)
    output wire busy_o      // 状态 != S0
);
    localparam integer W  = $clog2(NSTATES);
    localparam integer SW = (ENC == 2) ? NSTATES : W;
状态向量位宽由参数决定:binary 与 gray 都取 $clog2(NSTATES) 位,one-hot 直接取 NSTATES 位。编码函数 enc(i) 在 elaborate 阶段把状态下标 i 翻译成对应码值——binary 取二进制原值,gray 按相邻码只翻一位的公式逐位异或,one-hot 把 1 左移 i 位。注意一个刻意的设计选择:所有合法转移都是相邻转移或原地停留,这正是 gray 编码安全且占优的前提条件,如果状态机到处跳变,gray 的单位翻转优势就不存在了。
综合没有依赖综合器的 FSM 重编码,而是走 synth -nofsm,让 RTL 里参数化展开的编码原样进入映射,再经 dfflibmap 与 abc 映射到教学标准单元库。这样做避开了姊妹篇里「综合器不认 gray、静默降级成 one-hot」那类工具行为干扰——九组设计的编码差异全部由源码参数严格保证。
读这张图抓住一条主干:九组变体从同一份 RTL 分叉,先过行为等价性检查确认功能一致,再各自走完综合和静态时序分析,最后汇进同一张九行 CSV。每个环节对所有变体都是同一套工具、同一份库、同一条约束,这是「差异只能归因于编码」的实验纪律。
教学库只有四类单元:触发器 DFF_P、二输入与非门 NAND2_X1、反相器 INV_X1 和缓冲器 BUF_X1,延时是标量常数,不对应任何真实工艺。因此必须先声明口径:本文的绝对频率、绝对面积数字没有工程意义,只回答「同库同约束下,三种编码的相对差异与随状态数的变化趋势」。时钟约束由一条 SDC 给出,九组完全相同:
create_clock -name clk -period 10.0 [get_ports clk]二、行为等价性:同激励下三种编码逐拍一致
比资源之前先证明「比的是同一个东西」。测试平台用 generate 对 4、8、16 三档各例化 binary、gray、one-hot 三个实例,喂同一路确定性激励:先连续前进到末态验证钳位,再连续退回 S0 验证首端钳位,最后是 16 拍 go/back 混合流,其中专门覆盖两者同时有效、back 胜出的优先级场景。每个时钟沿对四个输出逐拍比对,任意一位不一致立刻 $fatal 终止。
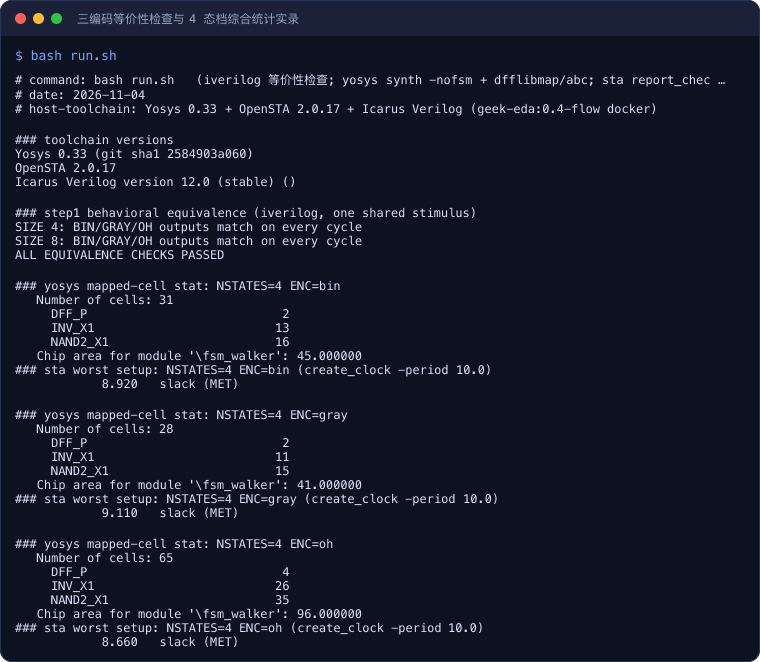
读这份实录先看开头三行:工具版本是 Yosys 0.33、OpenSTA 2.0.17、Icarus Verilog 12.0,全部来自同一容器镜像,九组实验没有混过工具链。等价性段打印了 SIZE 4、SIZE 8 两路逐拍一致的结论,收尾的 ALL EQUIVALENCE CHECKS PASSED 是总判定——16 态实例的比对语句同样每拍执行,只是它的汇报语句排在仿真结束时刻之后,没轮到打印,但只要出现过一拍不一致,$fatal 会在总判定之前直接终止仿真。等价性成立意味着后面九组资源和时序数字,比较的是功能严格相同的九个电路。
再补一句为什么激励要这样设计。前进 20 拍对 16 态档都足够从 S0 一路走到末态,末态钳位、首态钳位、中途后退、go 与 back 同时有效这四类边界情形全部覆盖,三个实例连的是同一组 reg 信号、同一个时钟,不存在「各吃各的激励」的空间。这种「一份激励、并列例化、逐拍对拍」的结构,比分别跑三组波形再人工核对可靠得多——任何一组编码在边界上行为漂移,都会在当拍被比对逻辑抓住并终止仿真,不会带着功能差异进入后面的资源对比。
三、综合资源对比:触发器账单与 one-hot 的线性膨胀
九组综合的资源数据全部落在 results.csv 里,面积单位是教学库的 NAND2 等效面积:
| 状态数 | 编码 | 触发器 DFF_P | 单元总数 | NAND2 等效面积 |
|---|---|---|---|---|
| 4 | binary | 2 | 31 | 45 |
| 4 | gray | 2 | 28 | 41 |
| 4 | one-hot | 4 | 65 | 96 |
| 8 | binary | 3 | 54 | 82 |
| 8 | gray | 3 | 49 | 75 |
| 8 | one-hot | 8 | 155 | 236 |
| 16 | binary | 4 | 75 | 119 |
| 16 | gray | 4 | 86 | 138 |
| 16 | one-hot | 16 | 345 | 530 |
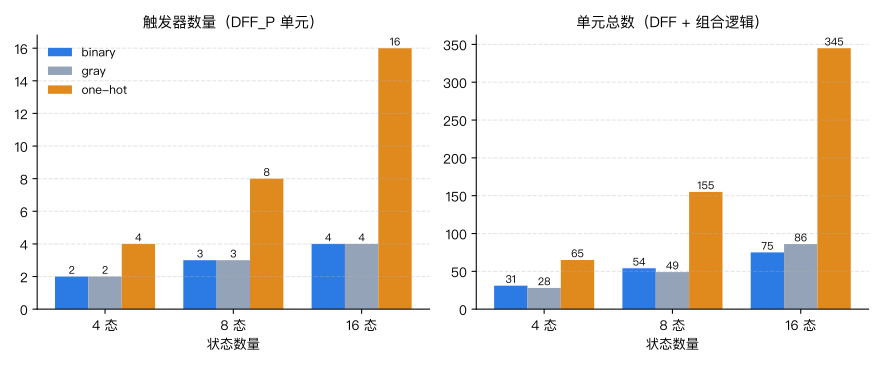
这张图左半是触发器、右半是单元总数,读它抓三条趋势。第一,触发器数严格服从编码的数学结构:binary 与 gray 都是 ceil(log2 N),4/8/16 态对应 2/3/4 个,增长极慢;one-hot 是 N 个,4/8/16 态对应 4/8/16 个,状态数翻倍它就翻倍。第二,one-hot 的单元总数 65、155、345,随状态数近似线性暴增——摊到每个状态约 16、19、22 个单元,斜率稳定;binary 的 31、54、75 是明显的亚线性增长,状态数从 8 翻到 16 时单元只涨了四成。第三,面积比随规模一路走高:one-hot 对 binary 的面积倍数在 4 态是 96/45≈2.1 倍,8 态是 236/82≈2.9 倍,16 态达到 530/119≈4.5 倍。规模越大,one-hot 的资源学费越贵。
gray 与 binary 的关系更微妙,出现了一次交叉。4 态和 8 态两档,gray 都是三者中最小的:28 对 31、49 对 54 个单元,面积也分别省 4 个和 7 个等效门。原因在相邻转移——每次状态变化只翻一位,gray 的次态函数比 binary 少一层译码纠缠。但 16 态档反转:gray 单元 86 对 binary 的 75、面积 138 对 119,gray 反而更大。状态位宽到 4 位后,gray 编码侧的逐位异或展开和状态比较逻辑开始吞掉它在翻转率上的节省,这是本篇数据里最反直觉、也最有决策价值的一个拐点。
16 态 one-hot 那组的 stat 与 STA 摘段原样如下,单元构成只有触发器、反相器和与非门三种,账目干净可核:
### yosys mapped-cell stat: NSTATES=16 ENC=oh
   Number of cells: 345
     DFF_P                          16
     INV_X1                        128
     NAND2_X1                      201
   Chip area for module '\fsm_walker': 530.000000
### sta worst setup: NSTATES=16 ENC=oh (create_clock -period 10.0)
            7.780   slack (MET)
345 个单元里 16 个是触发器,剩下 329 个全是组合逻辑——one-hot 虽然省掉了二进制译码器,但每个状态位都要一个独立的次态与或项,状态一多,组合门照样堆成山。这也解释了为什么「FPGA 偏爱 one-hot」是有前提的:FPGA 的触发器挂在 LUT 后面、边际成本低,而在标准单元口径下,每个触发器都是实打实的面积。
把九组 stat 里的反相器和与非门拆开看,趋势更刺眼。one-hot 的组合门(INV 加 NAND2)数量从 4 态的 61 个涨到 16 态的 329 个,五倍以上;binary 同口径只从 29 个涨到 71 个,两倍出头。gray 介于两者之间,16 态时组合门 82 个,已经高于 binary 的 71 个——它在小规模省下的那几个门,到 4 位状态位宽时连本带利还了回去。换句话说,one-hot 的账单不是只在触发器一栏,组合逻辑那一栏同样随状态数近乎线性地涨。
四、时序对比:slack 排序随规模换人
九组设计在同一条 10 ns 时钟下的最差 setup slack 如下,全部 MET:
| 状态数 | binary slack (ns) | gray slack (ns) | one-hot slack (ns) |
|---|---|---|---|
| 4 | 8.920 | 9.110 | 8.660 |
| 8 | 8.700 | 8.890 | 8.180 |
| 16 | 8.400 | 8.220 | 7.780 |
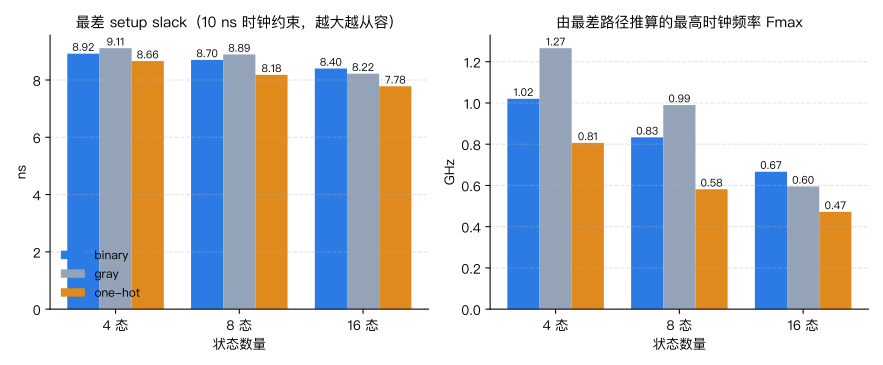
这张图左半是 slack 柱,右半是按 Tmin = 9.9 − slack(10 ns 周期减 0.1 ns 触发器建立时间)折算的 Fmax,右图排序与左图完全一致,因为只是同一组数据的单调换算。读趋势看三点。第一,小规模 gray 时序最好:4 态 9.110 ns、8 态 8.890 ns 都是同档第一,与它单元数最小互相印证——相邻单 bit 翻转让组合路径更短。第二,16 态换成 binary 第一:8.400 ns 对 gray 的 8.220 ns,资源上的交叉点与时序上的交叉点落在同一档,gray 的译码展开同时亏了面积和路径。第三,one-hot 在三个规模下 slack 全部垫底(8.660、8.180、7.780 ns),且随规模下降最快。
one-hot 时序垫底这件事需要拆穿一层纸面印象。教科书常说「one-hot 组合逻辑只有一级与或,时序最好」,那是在 FPGA 的 LUT 结构里成立;本次是标准单元库映射,16 态 one-hot 的最差路径在 STA 报告里是一条交替穿过多级 NAND2_X1/INV_X1 的长链,数据到达时间约 2.12 ns(9.9 − 7.78),而同档 binary 只有约 1.50 ns。每个次态项虽然浅,但状态位 fanout 巨大,缓冲和合并路径叠起来反而更深。这就是为什么本文反复强调口径:换一种器件结构,排序可能重排。
当然也要说清差距的量级。九组 slack 全落在 7.78 到 9.11 ns 之间,最大极差只有 1.33 ns,对 10 ns 周期而言谁都没有逼近违约。折算 Fmax 只是为了读图直观——例如 16 态档 binary 约 0.67 GHz、one-hot 约 0.47 GHz——这些绝对值建立在标量延时教学库上,不能当真实工艺的频率预期,可信的是同口径下的相对排序和它随状态数的走向。
还要说清 slack 差距在真实设计里意味着什么。1.33 ns 的极差在 10 ns 周期里看似温和,但真实工艺的时序预算要分给布线延时、时钟抖动、多层级联路径,教学库里这些都被理想化了,留给编码选择的余量通常远没有这么宽裕。同一条路径在更紧的约束下,最先违约的就是 slack 垫底的那一版——本文九组全部 MET,不代表把周期压到 3 ns、5 ns 时排序不变。读这类数据的正确姿势是看「余量排序」和「排序随规模怎么换位」,而不是盯着绝对值判断谁能跑多快。
五、选型结论:按状态规模给规则,而不是背口诀
把九组数据折成可执行的决策规则。前提声明:以下规则来自单一教学标准单元库、单一线性往返 FSM 拓扑,适合做 ASIC 标准单元流程的一阶判断;FPGA 与复杂跳转拓扑需要另行实测。
| 状态规模 | 首选编码 | 实测依据(本库口径) | 主要权衡 |
|---|---|---|---|
| 4 态及以下 | gray,binary 紧随 | gray 面积 41 最小、slack 9.110 最大 | 三者差距很小,团队规范统一用 binary 也不亏 |
| 8 态左右 | gray | 面积 75 对 binary 82,slack 8.890 仍领先 | 要求转移以相邻为主,乱跳型状态机 gray 优势消失 |
| 16 态及以上 | binary | 面积 119 全场最小、slack 8.400 反超第一 | 译码逻辑随规模加深,上百态要配合综合器状态分配优化 |
| 任意规模的 one-hot | 仅限特殊理由 | 面积倍数 2.1→2.9→4.5 随规模恶化 | 非法状态易检测、FPGA 触发器富裕时才划算 |
三条从数据里长出来的提醒。其一,「FPGA 用 one-hot、ASIC 用 binary」这句口诀在本文数据里只剩后半句:标准单元库下 one-hot 即便在 4 态也付出两倍面积,且时序从未领先,选它必须有明确理由——比如安全关键场景要监控 one-hot 不变量(任意位翻转立刻破坏「恰有一位为 1」),或者目标器件的触发器确实廉价。其二,gray 的优势有适用边界:它同时要求相邻转移和中小规模,16 态档实测已经被 binary 双反超,不要把「gray 省翻转」当成无条件成立的信仰;跨时钟域传状态、追求低翻转功耗的场景仍优先 gray,但那是另一类约束在主导。其三,编码决策要和复位、非法态恢复一起看:one-hot 复位到 ...0001 需要置位端,binary 清零即可,配套的安全写法可以直接套用安全状态机 Verilog 模板,更系统的三段式与编码方法论见有限状态机设计。
最后给一条可操作的工程动作:改编码参数重新综合一遍的成本在本实验里只是一轮脚本,真正项目里也应当用自己的工艺库把关键 FSM 各综合一遍,用你自己的 stat 和 report_checks 数字替代表格里的教学库数字——方法和参数矩阵照抄本篇即可,结论数字必须以你的实测为准。
实验环境
- 机器/系统:Linux 主机上的 Docker 容器(镜像 geek-eda:0.4-flow),全程同一镜像、同一工具链。
- 工具版本:Yosys 0.33 (git sha1 2584903a060)、OpenSTA 2.0.17、Icarus Verilog 12.0 (stable),照抄运行日志头部真实输出。
- 日期:2026-11-04。
- 完整命令:
bash run.sh(脚本内部先跑 iverilog/vvp 行为等价性检查,再对 4/8/16 三档 × binary/gray/one-hot 三编码共九组变体依次执行 Yosyssynth -nofsm+dfflibmap+abc映射与 OpenSTAreport_checks,汇总成work/results.csv)。
代码获取
本实验的参数化 RTL、测试平台、教学 liberty、约束与一键脚本已同步到公开仓库:derekzhuo/geek-doc.cn 的 experiments/param-fsm-binary-onehot/。克隆后进入该目录,在装有 geek-eda:0.4-flow 镜像的机器上执行 make run(等价于 bash run.sh)即可复现等价性检查、九组综合与时序分析;跑完后用 python plot.py 可从 work/results.csv 重新生成正文引用的两张数据图。
这一篇在知识体系里的位置
- 入门承接:有限状态机入门:状态、状态图,Moore 与 Mealy 的区别(状态、状态表与编码的基础概念);
- 姊妹实测:状态机编码风格实测:binary/one-hot/gray 三种编码 yosys 综合资源对照(单规模、聚焦
fsm_encoding属性与 gray 静默降级); - 设计方法:有限状态机设计方法论(三段式写法与编码风格的适用场景总论);
- 安全配套:安全状态机 Verilog 模板:两段式、默认分支与非法态恢复(编码选定后的复位与非法态恢复写法)。
总结
状态机编码怎么选,让九组同口径实测说话:binary/gray 的触发器按 ceil(log2N) 慢涨、one-hot 按 N 线性膨胀,16 态时 one-hot 面积 530 对 binary 119、单元 345 对 75,代价四倍以上;gray 在 4/8 态凭相邻单 bit 翻转拿下面积与时序双优,16 态被 binary 双反超——标准单元口径下的量化规则是小中规模优先 gray、16 态及以上转 binary、one-hot 只留给非法态检测等特殊理由。教学库的绝对频率无工程意义,可信的是同库同约束下的相对趋势,换工艺请照参数矩阵自己重跑一遍。