FPGA 进位链:加法为什么快——LUT 管逻辑、CARRY4 管算术的分工
写过几个 FPGA 模块的人多半有过这个朴素的惊讶:一行 sum <= a + b;,32 位宽,综合出来居然能在一个时钟周期内轻松收敛,时序报告上这条路径并不显得特别长。LUT 不是只能查表实现任意函数吗?加法的进位要一位一位往高位传,32 位岂不是要串 32 级逻辑?答案是:算术根本没有全走 LUT。每个 slice 里除了 LUT 和触发器,还蹲着一条专用的 FPGA 进位链(carry chain)——Xilinx 7 系列上它叫 CARRY4,是与可编程布线矩阵平行存在的一条专用纵向硬件。基础概念篇 LUT 与 FF 深入 讲过 LUT 怎么查表实现任意函数,本篇专讲它的搭档:算术在硅片上走的那条捷径。芯片整体资源版图可对照 FPGA 架构基础。
先用一张流程卡给出全篇骨架:从 RTL 上的一个加号开始,到它在芯片上变成纵向摆放的进位硬件,中间经过哪几次翻译。
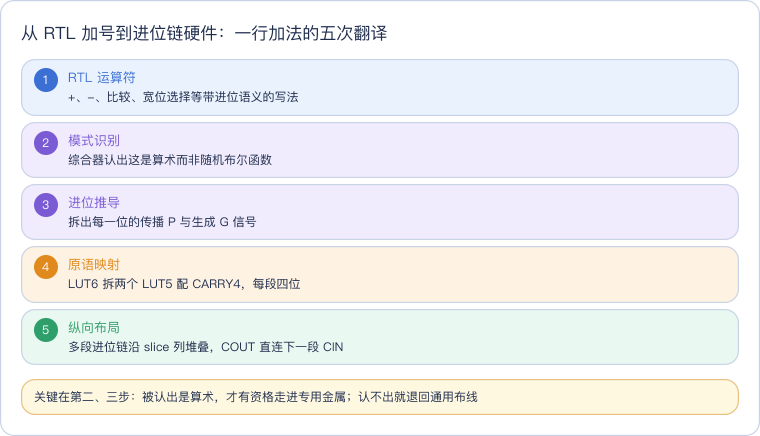
读这张卡抓住一条主线:能不能享受进位链,取决于综合器是否把你的代码识别成了进位结构。后面的章节就是逐步展开这张图——先看没有进位链的世界有多慢,再看 CARRY4 的硅片长相,最后讲哪些写法能被识别、哪些自作聪明的写法会把捷径堵死。
本文要回答的问题
- 如果不用任何专用硬件,只用 LUT 搭一个 32 位加法器,延迟为什么会随位宽线性恶化?
- CARRY4 在 slice 里长什么样?LUT6 拆成两个 LUT5 与进位硬件是怎么配合算出和的?
- 逐位进位不是很慢吗,进位链凭什么快?它内部是纯行波进位还是带超前进位?
- 除了加减法,比较运算、宽位多路选择为什么也会被综合器映射到 FPGA 进位链?
- 手写门级全加器、用 LUT 手工级联进位,为什么通常比直接写加号更慢?
一、不要会怎样:用 LUT 搭加法,进位穿开关矩阵
先看没有专用进位硬件的世界。一位全加器很容易塞进 LUT:三个 1 位输入 A、B、Cin,两个输出和 S 与进位 Cout,各自是三输入布尔函数,一个 LUT6 装两个这样的小函数都绰绰有余。于是一个 32 位加法器可以这样「纯 LUT 化」:32 个全加器并排放,第 0 位的进位输出接到第 1 位的进位输入,一级一级串到最高位。
逻辑上完全正确,物理上却慢得要命。问题不在全加器本身——每一位的查表延迟都一样短——问题在进位信号走的路。LUT 的输出要进入另一个 LUT 的输入,必须先离开这个 slice,进入通用布线矩阵:信号穿过一个个可编程开关(每个开关是一枚导通电阻不小的传输管),沿水平、垂直布线通道绕到目的地。32 位行波进位意味着最低位产生的进位要这样连续跳 31 次,而且每一跳的布线延迟往往比 LUT 本身的延迟还大。
这张对比图里红色是「纯 LUT 行波进位」,绿色是 FPGA 进位链的真实形态,差别只有一个:进位信号离不离开专用通道。左侧每一位的进位都要绕行通用布线、穿过可编程开关,总延迟约等于位数乘以「单跳布线 + LUT」延迟;右侧进位被关进一条专用的纵向金属链,每经过一位只穿过一个专门为它摆放的进位 MUX,不进开关矩阵、不与数据走线抢资源。两种做法用到的晶体管数量差不多,速度差距却可以按倍数计——这正是 FPGA 要在通用结构之外单独塞一条算术通道的原因。
再深想一层:随机逻辑之所以必须走开关矩阵,是因为它的连接关系在出厂后才由比特流决定,必须「哪儿都能去」;而加法进位的连接关系是固定且可预知的——永远从低位指向相邻高位。对这种永远不变的连接,最省的办法就是直接放一条金属线。这就是理解 FPGA 进位链的总纲:连接模式固定的东西,不值得占用宝贵的可编程性。
二、CARRY4 在 slice 里的纵向版图
具体到 Xilinx 7 系列,一个 slice 里有 4 个 LUT6、4 个触发器和 1 个 CARRY4,即一段进位链正好处理 4 位。CARRY4 物理上紧贴 LUT 列摆放,进位方向是纵向的:进位从下方相邻 slice 的 COUT 进入本 slice 底部的 CIN,在本段内自下而上穿过 4 级,再从顶部 COUT 出去,交给上方 slice 的 CIN。布局器因此总倾向于把宽加法涉及的 slice 沿同一列上下码放,让进位全程走直线。
读这张版图抓三点。第一,蓝色 LUT 列与橙色 CARRY4 是并排的两类硅片资源,分工明确:LUT 负责产生与数据相关的控制信号,CARRY4 负责让进位纵向跑。第二,进位链的入口和出口都在 slice 边界上,COUT 到上一段 CIN 是硬连线,因此 32 位加法在 7 系列上是 8 个 CARRY4 沿列串接,进位路径上不经过任何通用布线开关。第三,LUT6 的「一拆二」能力在这里被精准利用:加法只需要 LUT 当一个 LUT5 用(两个数据输入加进位相关的小函数),拆出来的另一半还可以顺便服务求和异或,这就是为什么进位加法几乎不浪费 LUT。
本位和的布尔式是 S = A xor B xor Cin。LUT 这边先算出 P = A xor B(传播信号:这一位若 A、B 相异,低位来什么进位就原样向上传什么),CARRY4 内部每一级再做一次 XOR 把 P 与到达此级的进位异或,即得到本位和。进位本身则由一个二选一 MUX 决定:若该位「生成」进位(A、B 都为 1),强制向上送 1;若「杀死」进位(A、B 都为 0),强制送 0;否则(P=1)把低位进位原样传上去。
| 该位输入 (A,B) | 语义 | 进位 MUX 向上送什么 | 本位和 |
|---|---|---|---|
| 00 | 杀死(kill) | 固定 0 | 等于 Cin |
| 01 或 10 | 传播(propagate) | 原样传 Cin | Cin 取反 |
| 11 | 生成(generate) | 固定 1 | Cin 取反 |
这张表就是一位加法的全部秘密:和永远是 P xor Cin,进位永远在「0、1、传上来的值」之间三选一。不同厂商、不同代际的进位单元名字和段宽不同(Intel 器件里叫 carry chain / fast carry,段宽随代数变化),但「LUT 产 P/G、专用 MUX 链传进位」这套结构是通用的。
三、段内不是纯行波:进位 MUX 链与超前进位段
「逐位 MUX 传进位」听起来仍然是行波进位,为什么不慢?两个层面的答案。
单级延迟极低。 行波进位真正贵的是每一级之间的通用布线跳变;进位 MUX 链里没有开关矩阵,级与级是硅片上紧挨的专用晶体管,每过一位的代价只是一个 MUX 的裸延迟,比一次 LUT 加布线跳变小得多。于是「线性增长」没有消失,但斜率被压得很平——8 个 CARRY4 串 32 位在典型设计里仍是一条可以接受的组合路径,宽到上百位才会成为时序瓶颈,那时该考虑的是流水线(见 流水线与资源优化)而不是自己改进位结构。
段内带有先行的味道。 CARRY4 并非四个孤立全加器的机械堆叠:传播与生成信号在段内并行地由 LUT 同时备好,进位 MUX 的选择在整段里是统一设计的,部分版本的进位结构对段内进位做了局部先行(carry lookahead)式的组织。可以把它理解成「段内高速、段间直连」:4 位一段的边界由硬件定死,段内用专门优化的选择逻辑尽快把进位推到段尾,段与段之间再用 COUT/CIN 金属相接。到了 UltraScale,进位单元扩为 CARRY8,一段处理 8 位,段宽翻倍、布局更紧凑,跨代思路不变:更宽的先行段、更短的纵向相对路径、依旧与 LUT 列并排。Intel(原 Altera)器件的叫法不同,在自适应逻辑模块里以进位级联链实现,段的切分随代数变化,但「LUT 产控制信号、专用链传进位、沿列纵向直通」这三条完全对应,学会一家再看另一家的库手册不会有障碍。具体某代器件的段宽与进位组织,以该代的库指南为准,本文只给定性结构。
工程上还要建立一个量级直觉:进位链的延迟与位宽近似成正比,但因为每一位只是一个专用 MUX,斜率很平,常见总线位宽(16、32、64 位)下它通常不是关键路径;真正要警惕的是上百位的宽累加、宽比较,尤其是操作数本身还要先走一大段 LUT 逻辑和长布线才抵达进位链入口——此时总路径是「数据准备 + 链」两段之和,瓶颈往往在前者。看到进位链路径违例,先问操作数能不能提前一拍寄存,而不是怀疑这条链本身。
| 对比项 | 纯 LUT 行波进位 | CARRY4 / CARRY8 进位链 |
|---|---|---|
| 级间通道 | 通用布线 + 可编程开关 | 专用纵向金属,不进开关矩阵 |
| 每位代价 | LUT 延迟 + 布线跳变 | 一个进位 MUX 的裸延迟 |
| LUT 用法 | 整函数塞进 LUT | LUT6 拆二,只产 P/G 与求和 |
| 段宽(7 系列 / UltraScale) | 无段概念 | 4 位 / 8 位 |
| 宽位延迟趋势 | 随位数快速线性恶化 | 随位数平缓增长,可流水线打断 |
四、进位链不只会加法:减法、比较与宽位 MUX
进位链的本质是「一条快速的逐位裁决链」,加法只是它最有名的用户。凡是结果需要从最低位开始逐位裁决的运算,综合器都会考虑把它送上 FPGA 进位链。下面这些写法在 7 系列上常见地映射到 CARRY4:
// 1. 加减法:加减共用进位链,减法按补码取反加一
wire [15:0] diff = a - b;        // b 取反,CIN 预置 1

// 2. 无符号比较:做一次减法,看进位/借位输出,不要结果本身
wire lt  = (a <  b);             // 借位位即答案
wire ge  = (a >= b);

// 3. 宽位三目:按条件整体选边,可折叠进进位选择结构
wire [15:0] m = sel ? a : b;

// 4. 加减计数器:每拍恒定加/减一个数
always @(posedge clk) cnt <= cnt + 16'd1;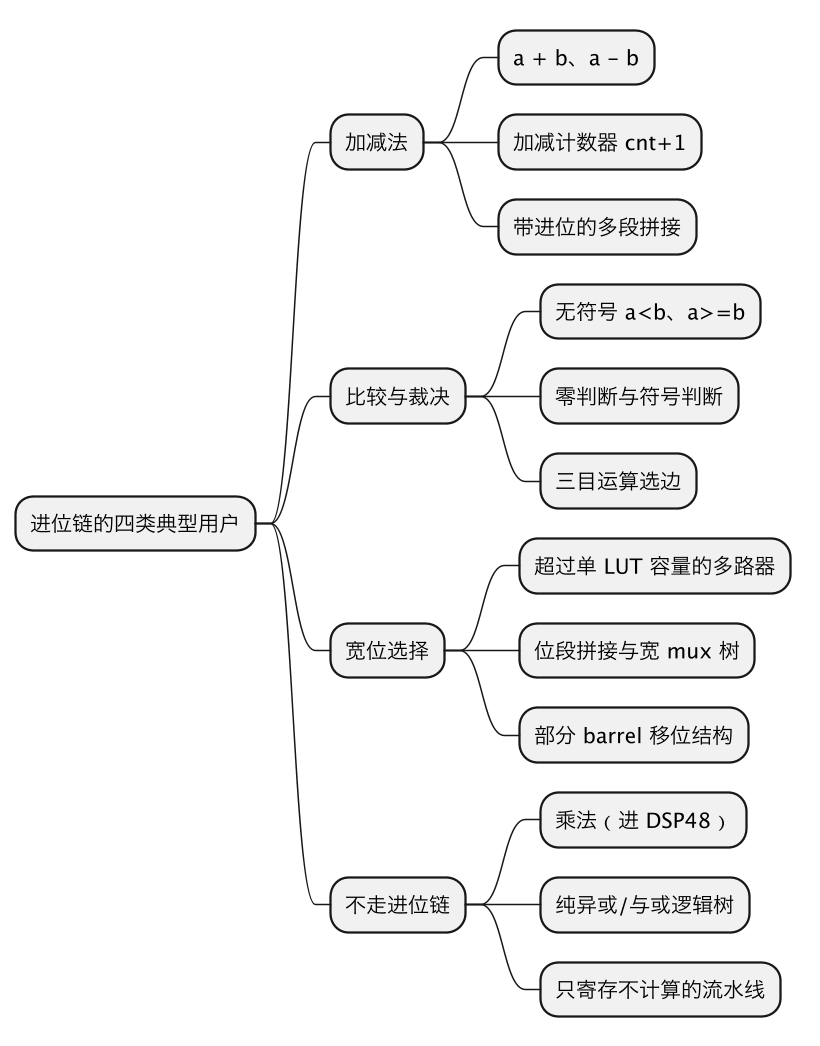
这张思维导图的读法是:左侧三类共享同一条硬件——逐位裁决;最下面一类要特别记住,乘法不属于进位链的地盘,宽乘法应当被推断进 DSP48 硬核(分工见 DSP48 入门 与进阶 DSP 算术设计),如果你在资源报告里看到乘法占了大量 LUT 而非 DSP,那是另一类典型事故。
比较器值得多说一句,因为它最反直觉:a < b 综合后常常是一个「加法器形状」的电路。原理是无符号比较等价于减法借位——计算 a - b 时若最高位产生借位,说明 a 比 b 小;和值本身被丢弃,只用进位链末端那一个进位位。于是一个 16 位比较器的面积和延迟,与一个 16 位减法器基本相同,而不是一棵层层与或的逻辑树。基于比较的三目选择(sel ? a : b)在足够宽时也可能借用进位链组织成「进位选择加法器」式的结构:每一位先把两种候选都备好,由一条快速链逐位裁决最终选谁。
宽 mux 是另一个常见受益者。slice 里除了 CARRY4 还有 F7MUX、F8MUX 这类专用多路器,专门把同一 slice 内多个 LUT 的输出逐级合并;当 mux 宽到跨 slice 时,部分编码形态的宽选择也会折叠进进位 MUX 链。综合器在这里做的选择本质相同:能占专用晶体管的裁决,就不要穿通用布线。
五、坑:手写宽 LUT 级联,亲手堵死捷径
进位链虽快,却有一个前提——综合器必须在 RTL 层面认出进位结构。它识别的是行为(加法、减法、比较),不是你手写的门级意图。下面几类写法在工程中反复出现,效果都是「行为上等价于加法,硬件上却退化成 LUT 逻辑树或通用布线进位」。
| 坑写法 | 为什么慢 | 推荐写法 |
|---|---|---|
门级手写全加器,进位在模块间一层层 assign | 进位信号成为普通网线,经通用布线跳变,综合器未必重组 | 直接对整个向量写 a + b |
| 用循环逐位异或、手写进位变量仿行波加法 | 被当成一般布尔函数逐位优化,失去段内先行 | 让工具推导 P/G |
| 比较器写成异或树加与或归并 | 逻辑级数随位宽对数甚至线性增长 | 直接写 a < b,借位链裁决 |
| 为「省资源」手工例化 LUT 原语拼算术 | 绕过推断,工具无法把它摆上 CARRY4 | 只在极特殊定宽场景才碰原语 |
| 加法中间结果反复取子向量再拼接 | 可能把进位链切成碎段,段间退回 fabric | 保持运算在完整向量上一次完成 |
判断自己是否掉进坑里,看两处报告。综合后的 utilization 里有 CARRY4(UltraScale 为 CARRY8)的使用计数:一个 N 位加法大约对应 ceil(N/4) 个 CARRY4,宽设计里这个数字为零而 LUT 数异常偏高,就要警惕算术被 LUT 化了。时序报告里,进位路径的形态是「CARRY4 内逐级 + 相邻 COUT 直连」,逻辑级数低;若看到进位信号在 LUT 与布线之间反复横跳、路径随位宽变长,说明链被打断了。报告看法分别见 资源利用率报告、时序报告入门 与 静态时序分析,资源估算口径见 FPGA 资源评估。
还有一个反向的小坑:进位链是纵向定址资源,加法位宽越宽,布局器越要沿同一列码 slice。在极度拥塞的设计里,宽进位链可能把周边逻辑挤远,反而抬高数据输入端的布线延迟。此时正确的手段是在算术中间插一级流水线寄存器把链切成两段(进位链与 FF 同处一个 slice,切口几乎不额外占面积),而不是改成手写进位。计数器这类天然适合进位链的结构,可参考 计数器与时钟使能。
这一篇在知识体系里的位置
本篇属于 FPGA 底层结构系列:往上接 LUT 与 FF 深入——LUT 负责随机逻辑、进位链负责逐位裁决,二者共同回答「可编程硅片怎么算算术」;芯片全貌在 FPGA 架构基础。横向上,进位链与 DSP48 入门 是两类专用算术硬件的分工:小位宽加减比较走 CARRY4,乘法乘加走 DSP48,进阶取舍见 DSP 算术设计。工程验证侧,宽加法的收敛策略属于 流水线与资源优化,观察手段是 资源利用率报告 与 时序报告入门,入门顺序可从 FPGA 入门目录 浏览。
总结
FPGA 进位链是 slice 内一条与通用布线平行的专用纵向金属:7 系列以 CARRY4 为一段处理 4 位,LUT6 拆成两个 LUT5 产生传播 P 与生成 G,进位 MUX 沿链逐位裁决、段间 COUT 直连 CIN,UltraScale 扩为 CARRY8 而思路不变。它快的根本原因不是更聪明的算法,而是进位这种连接模式固定的信号根本不配占用可编程开关——专用金属的每位延迟远低于一次布线跳变。综合器还会把减法、无符号比较、宽位 mux 与加减计数器映射到同一条链,乘法则归 DSP48;对设计者而言,最要紧的纪律是直接书写算术行为、让工具识别,任何门级手写进位的「优化」都大概率把捷径堵回通用布线。