AXI4 带宽调优:burst 对齐、outstanding 深度与 FIFO/切片调参实测
更新时间:2026-09-28。本篇是「集成电路大类 · 芯片设计 · 片上总线」序列里的性能专题。协议基础先读 AXI4 完整协议基础 与 AXI4 传输全生命周期,乱序与 ID 机制见 AXI4 outstanding 与 ID 排序,时序切片见 AXI register slice 时序。本篇回答的是工程现场最常见的一类投诉:接口是 AXI4-128 @ 400MHz,理论带宽 6.4GB/s,DDR 控制器也没报错,实测却只有 3.1GB/s——钱到底丢在哪?
本文要回答的问题
- AXI4 理论带宽怎么算,实测带宽的「损耗账本」通常由哪几项构成?
- burst 长度与地址对齐如何影响 DDR 侧的行命中率,为什么是调优的第一刀?
- outstanding 深度多少才够,怎么用「延迟 × 带宽」的利特尔法则算下限?
- 写数据 FIFO 与 register slice 插在哪里、插几级,各有什么代价?
- 一套可复现的实测方法:怎么造流量、怎么采数、怎么判断调到位了?
一、理论带宽与损耗账本
AXI4 的理论带宽只有一行公式:位宽 × 频率。128 bit 总线跑 400MHz,理论峰值是 128/8 × 400M = 6.4GB/s。但理论值假设数据通道每个时钟沿都在传有效数据,现实中 W/R 通道上总会有气泡。把气泡来源列成账本,一项项收回来,就是 AXI4 带宽调优的全部工作。

这张「损耗瀑布」是典型的现场画像。注意它不是串行相乘的关系:burst 太短会让 DDR 控制器频繁 precharge/activate,行缓冲命中率掉下去,有效利用率可能只有五成;outstanding 不足则让 master 在等响应时发不出新地址,延迟暴露在外面。调优的顺序也按这张图的从大到小来:先对齐和 burst,再 outstanding,最后 FIFO 和切片。反着来——先插切片——往往把延迟越垫越高,outstanding 反而更不够用,事倍功半。
一个容易踩的坑是「平均带宽掩盖结构性问题」。用 DMA 搬一大块连续内存测出来的 6.2GB/s,不代表视频解码器那种「小块 + 随机跳」的负载也能跑到。所以账本必须按真实负载记:把流量按 burst 长度分布、地址连续性、读写比例三维度画像,再对照理论值找差距。
二、第一刀:burst 长度与地址对齐
burst 是 AXI4 带宽最大的杠杆。原因不在 AXI 本身,而在它下游几乎总是 DDR。DDR 的一次访问要经历 activate(开行)、读/写、precharge(关行),开行后连续命中同一行的访问几乎免费,跨行则要付 tRC 级别的开销(典型 45ns 上下)。AXI 侧一个 4KB 对齐、长度 16 的 burst,给到 DDR 就是一串行内连续访问;拆成四个长度 4 的 burst,DDR 控制器大概率要多做两三次行切换。
AXI4 的 burst 上限是 256 拍(AWLEN=255),但工程上的甜点通常不在最大处:
| burst 拍数(128bit) | 单次字节数 | DDR4 行命中表现 | 适用场景 |
|---|---|---|---|
| 4 | 64B | 差,频繁开行 | 寄存器配置、小消息 |
| 16 | 256B | 良好 | cache line、通用 DMA |
| 64 | 1KB | 很好 | 视频行缓冲、大块搬运 |
| 256 | 4KB | 最好,但占 FIFO | 纯带宽型搬运引擎 |
对齐比长度更优先。一个长度 16 的 burst 若起始地址不是 256B 对齐,跨了 DDR 的 bank 边界甚至行边界,收益直接腰斩。调优动作有两条:master 侧发起时把起始地址对齐到「拍数 × 每拍字节数」的整数倍;DMA 描述符层面把 buffer 起点和长度都做成 cache line 对齐。更细的拍数计算规则见 AXI4 LEN/SIZE 与 beat 计算,非对齐传输怎么被拆拍的细节见 AXI4 窄传输与非对齐。
WRAP 突发是个例外场景:它为 cache line 填充设计,天然按行对齐,但对 DMA 型负载不要用——WRAP 的地址回卷会让下游的地址累加逻辑变复杂,而 DMA 要的就是线性地址,用 INCR 即可。
三、第二刀:outstanding 深度
outstanding 是「已发地址、未收齐数据」的在途交易数。它解决的核心问题是延迟掩盖:DDR 的读延迟典型在 100-200ns,如果一个 master 发一笔读、等数据回来再发下一笔,那么它的带宽上限是「单笔字节数 ÷ 往返延迟」,跟总线位宽无关。
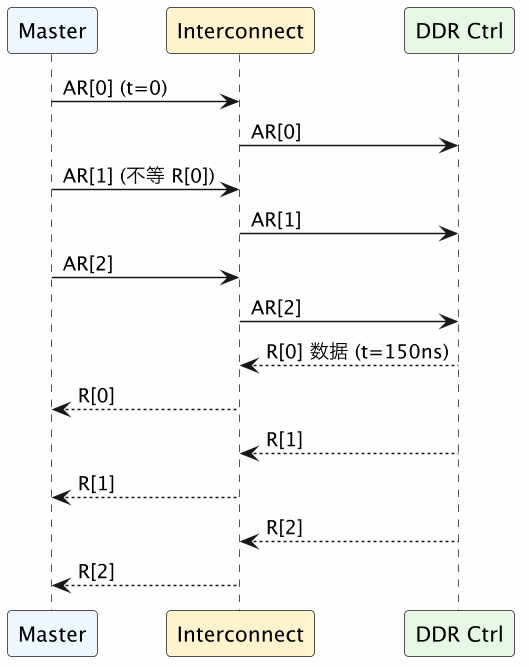
上图是三笔 outstanding 在途的样子:AR 连发,R 按序回来,150ns 的 DDR 延迟被三笔交易摊掉。算下限用利特尔法则的变形:在途字节数 ≥ 带宽 × 往返延迟。要跑满 6.4GB/s、往返延迟 200ns,需要在途 1.28KB;单笔 burst 256B 的话,outstanding 至少要 5。工程上留一倍余量,配 8 是常见值。
两个方向都别走过头。深度不够:延迟掩盖不住,带宽天花板被锁死,这是最常见的病根。深度过深:ID 变多、互联里的重排序缓冲变大、面积和时序都吃紧,而且多个 master 同时深 outstanding 会在互联里排队,延迟反而上升。多 ID 乱序返回的排序规则见 AXI4 outstanding 与 ID 排序。还有一条红线:outstanding 计数必须在 master、互联、slave 三处一致,任何一处的深度小于上游,都会成为隐形节流阀——排查时把整条路径上每一跳的 AW/AR 接收能力列出来,最小值就是系统的实际上限。
四、第三刀:写数据 FIFO 与 W 通道气泡
读方向靠 outstanding 掩盖延迟,写方向的问题不同:AW 发出去了,W 数据没跟上。AXI4 里 AW 和 W 是独立通道,slave 可以先收地址再等数据;但如果 master 内部的写数据路径要穿过多级桥接、做位宽转换、或者数据源本身就是慢速外设,W 通道就会一段一段地空转,每空一拍都是纯损耗。
解法是在 master 出口挂一个写数据 FIFO:数据先攒进 FIFO,凑够一个完整 burst(或至少够连续打 N 拍)再开始发 AW+W。这叫「先蓄后放」,把零散供给聚合成连续喷射。
FIFO 深度怎么定:至少装下最长的 burst(比如 16 拍 × 16B = 256B),再乘以想并发的 burst 数。深度不够的典型症状是「burst 中间断一拍」——波形上 WVALID 在 burst 中段掉了一拍又起来,这就是 FIFO 被掏空。深度配够后 W 通道应该是「burst 内零气泡,burst 间有间隔」,间隔由 AW 发放节奏决定,属于正常。
读方向的对偶问题是 R 通道反压:master 来不及消费 R 数据、RREADY 掉拍,会把压力顺着互联传导到 slave,堵住别人的读。对策同样是 FIFO——R 接收侧留够吸收「延迟 × 带宽」在途量的缓冲,让 RREADY 永远不要因为本地处理不过来而拉低。
五、第四刀:register slice 的位置与代价
时序和带宽是一对冤家。跨模块长路径过不了 STA,就得插 register slice 切断组合逻辑;但每级 slice 都给握手加一拍延迟,加错了位置还会直接砍吞吐。
register slice 有三种模式,选型直接决定代价:
| 模式 | 延迟 | 吞吐影响 | 适用 |
|---|---|---|---|
| fully registered | 1 拍 | 无损失(前向反向全寄) | 默认选择,关键路径上 |
| forward registered | 1 拍 | valid 路径寄、ready 组合,满速 | ready 路径本身不紧张时 |
| passthrough | 0 拍 | 不切时序 | 仅占位/调试用 |
原理与实现细节见 AXI register slice 时序。调优时的要点有三个。其一,slice 加在通道上、别加在数据路径中间:AW/AR/W/R/B 五个通道独立插,哪里时序不过插哪里,不要为省事在互联入口统一插五级。其二,插完 slice 要回头重算 outstanding:每级 fully registered slice 给往返加两拍(请求一拍、响应一拍),延迟变大意味着利特尔法则里的在途量需求变大,原来看似够用的 outstanding 可能就不够了。其三,时钟域交叉场景(比如 AXI 从 400MHz 域过到 DDR 的 800MHz 域)必须用异步 FIFO 形式的 slice,CDC 处理见 异步 FIFO 与 CDC,这一步的深度同样计入在途预算。
六、实测方法:造流量、采数、判断到位
调参不是玄学,每一步都要可测量。一套能复现的流程分四步。
第一步造流量要「像真的」:连续大块读、连续大块写、读写混合、随机小块四种模式分开测,burst 长度分布按业务画像配。纯大块的数字是用来对上限的,混合模式才是日常水平。
第二步采数靠性能计数器。FPGA 原型上直接挂 ILA 或在 AXI 通道上打性能计数:统计 WVALID&&WREADY 的拍数占总窗口的比例,这就是写通道利用率;R 通道同理。再记 AW 发出到 B 返回的延迟分布、在途 outstanding 的直方图。仿真环境里这些数更好拿,SVA/coverage 的做法见 SVA bind 与覆盖收集。
第三步归因看气泡位置。W 通道利用率低且 AW 也稀:outstanding 或 master 发放逻辑的问题。W 在 burst 中段断拍:写数据 FIFO 浅了。burst 普遍很短:回去查对齐和 DMA 描述符。带宽随负载模式剧烈波动:DDR 行命中问题,回到第二节。
第四步调参一次只改一个变量。典型的调优前后对比:某视频 SoC 的 AXI-128 @ 400MHz,初始实测 3.1GB/s;buffer 改 256B 对齐 + burst 固定 16 拍后到 4.6GB/s;outstanding 从 2 提到 8 后到 5.8GB/s;写 FIFO 从 64B 加深到 512B 后到 6.2GB/s,达到理论值的 97%。三个改动各自归因清晰,任何一步回退都能解释带宽变化——这就是「调到位」的判据:剩余损耗全部来自协议固有开销(写响应、通道切换),不再有可归因的气泡。
最后提醒一条:QoS 是最后手段不是调优主线。互联拥塞时给关键 master 提 QoS 确实能保它的延迟,但代价是压低别人,总带宽不变。QoS 机制见 AXI4 QoS 服务质量,先把上述四刀做完再考虑它。
这一篇在知识体系里的位置
协议层基础见 AXI4 完整协议基础 与 AXI4 传输全生命周期;burst 底层规则见 AXI4 LEN/SIZE 与 beat 计算、AXI4 WRAP 突发与 cache;并发与乱序见 AXI4 outstanding 与 ID 排序;时序侧见 AXI register slice 时序 与 AXI 互联数据通路架构;异常侧见 AXI 错误响应与总线超时。
总结
AXI4 带宽调优就是把「理论带宽 = 位宽 × 频率」与实测值之间的损耗账本逐项收回:先把 burst 对齐到 DDR 行边界并把长度做到 16 拍以上赚行命中率,再按「在途字节 ≥ 带宽 × 往返延迟」把 outstanding 配到 8 左右掩盖延迟,然后加深写数据 FIFO 消除 W 通道中段气泡,最后谨慎插 fully registered 的 register slice 收敛时序并回算在途预算;实测上用性能计数器统计 W/R 通道利用率与气泡位置,一次只改一个变量,直到剩余损耗只剩协议固有开销——这套「对齐 → 深度 → FIFO → 切片」的顺序,就是把 3GB/s 调回 6GB/s 的可复现路径。