异步 FIFO 深度计算实测:突发长度与读写速率比推导公式,深度不够即溢出
更新时间:2026-10-25。本文是「集成电路大类 · 芯片设计」中间层(intermediate)的一篇实验文。理论篇 FIFO 深度计算与设计 已经把深度公式、almost 水位、同步与异步 FIFO 的取舍讲透了,那一篇回答「公式长什么样、各项怎么来」;本篇回答一个更扎心的问题——**这个公式要是不信,深度配小了,电路会怎么死?**我们把同一个异步 FIFO 用两组深度参数各仿一遍:深度 16(满足公式要求)一组,深度 4(故意砍到要求的三分之一)一组,让丢数日志自己说话。异步 FIFO 本身的指针与格雷码机制见 异步 FIFO 与跨时钟域,同步 FIFO 的仿真验证流程见 同步 FIFO 设计与 iverilog 验证。
本文要回答的问题
- 突发写、慢速读的场景下,异步 FIFO 深度公式是怎么从「突发长度」和「读写速率比」推出来的?
- 指针跨时钟域的同步延迟,为什么要额外占掉几个深度余量?
- 深度满足公式时仿真长什么样?深度砍一半之后,溢出丢数和读数据错乱会以什么形式出现?
- 工程上拿到一组速率参数,怎么把公式算出的最小深度变成最终配置?
先给结论卡,四个数字全部来自后文真实仿真日志:
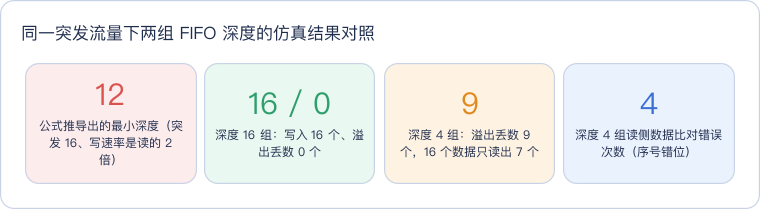
读这张卡抓住主线:深度 16 零丢数、深度 4 丢 9 个,差异不是仿真随机噪声,而是公式直接预言的结果——深度 4 连「突发期间净积压 8 个」这一半都装不下。下面先把公式推一遍,再看两组仿真的原始日志。
一、公式推导:突发积压 + 同步余量
场景是异步 FIFO 最典型的用法:写侧时钟 100 MHz(周期 10 ns),读侧时钟 50 MHz(周期 20 ns),写速率是读速率的 2 倍;写侧会打一个背靠背的突发,连续写 16 个数据。问 FIFO 最少要多深才不丢数?
推导分两笔账。第一笔是突发期间的净积压。写 16 个数据需要 16 × 10 ns = 160 ns;同样的 160 ns 里读侧以 20 ns 一个的速度最多读走 8 个。写进来的减读走的,积压峰值是 16 − 8 = 8 个。这就是「突发长度 ×(1 − 读速率/写速率)」这个经典形式的来源:16 × (1 − 1/2) = 8。
第二笔是指针同步的延迟余量,这是异步 FIFO 区别于同步 FIFO 的特有成本。写指针要跨过时钟域送到读侧才知道「有数据可读」,两级触发器同步器要 2 个读时钟(40 ns)才稳定;反过来读指针送到写侧产生「不满」信号也要 2 个写时钟。突发打进来时,读侧实际上要晚几十纳秒才「看见」数据、晚几十纳秒才「放掉」空间——这几十纳秒里写侧还在以 10 ns 一个的速度灌,换算过来还要再留 4 个左右的余量。两笔账加起来:8 + 4 = 12,这就是实验脚本里标注的「required 12」。深度取 2 的幂,向上取整到 16。
为什么一定要取 2 的幂?因为异步 FIFO 的指针是二进制计数器加格雷码变换,空满判定依赖「指针回绕后高位相反」的性质——深度不是 2 的幂,回绕位置就不对齐,格雷码「相邻只变一位」的保证会在回绕缝上破掉,空满逻辑直接出错。所以 12 不能配成 12,只能向上取 16;这也意味着算出来 9 和算出来 16 的最终成本一样,公式只要落在同一档 2 的幂区间里,就不必为省一两个深度去抠余量。
还有一个工程习惯值得养成:把「required 12 → 配 16」这类推导连同假设一起写进设计文档。半年后读侧速率变了、突发模型变了,后人要知道当初按什么参数算的,才能判断现有深度还够不够。本篇实验脚本头部就把假设写死了(写 100 MHz、读 50 MHz、突发 16),正是这个习惯的最小示范。
读这张图抓两条线:横线是数据流——突发灌入、FIFO 缓冲、读侧慢速排出,净积压 8 个是深度的大头;竖线是控制流——指针同步的几十纳秒延迟折算成额外 4 个深度。红色节点是压力源,紫色节点是本文下半篇要实演的「配不够的下场」。
二、实验设计:同一 RTL,只改深度参数
要保证对照干净,两组仿真必须用同一份 RTL、同一个 testbench、同一种流量,唯一变量是深度。实验用一个标准的异步 FIFO 实现(格雷码指针 + 两级同步器),地址位宽 AW 参数化,深度 = 2^AW。testbench 里写侧 10 ns 时钟、读侧 20 ns 时钟,复位后一次性突发写 16 个递增数据,读侧全程持续读,同时做三件事的记录:写侧每次因 full 而丢弃数据就打一行 OVERFLOW drop;读侧把读到的数据与期望值逐一比对,不符就打 MISMATCH;最后汇总写尝试数、丢数、读回数、错数。
编译时深度用 iverilog 的 -P 参数覆盖注入,不用改源码:
# 好组:AW=4,深度 16(>= 公式要求的 12)
iverilog -g2012 -o fifo_good.vvp -Ptb_async_fifo.AW=4 async_fifo.v tb_async_fifo.v
# 坏组:AW=2,深度 4(只有要求的三分之一)
iverilog -g2012 -o fifo_bad.vvp  -Ptb_async_fifo.AW=2 async_fifo.v tb_async_fifo.v
这个 -Ptb_async_fifo.AW=2 的写法值得记住:它直接覆盖 testbench 顶层参数,同一套源码可以扫一整组深度配置,做深度扫描回归时非常有用。
testbench 本身还有两个设计决定值得交代。一是写侧数据用递增序号(data=4、5、6……),这样读侧期望值可以离线推算,丢一个数立刻在比对里现形;二是仿真结尾在突发打完后又空了 200 个读时钟才收数——给足排空时间,确保「读回数 + 丢数 = 写尝试数」这个恒等式有机会闭合,避免把「还没读到」误判成「丢了」。这两个习惯在任何 FIFO 验证里都适用。
三、仿真实录:好组 PASS,坏组溢出九连
两组仿真完整执行实录如下(截取尾部汇总与判定段):
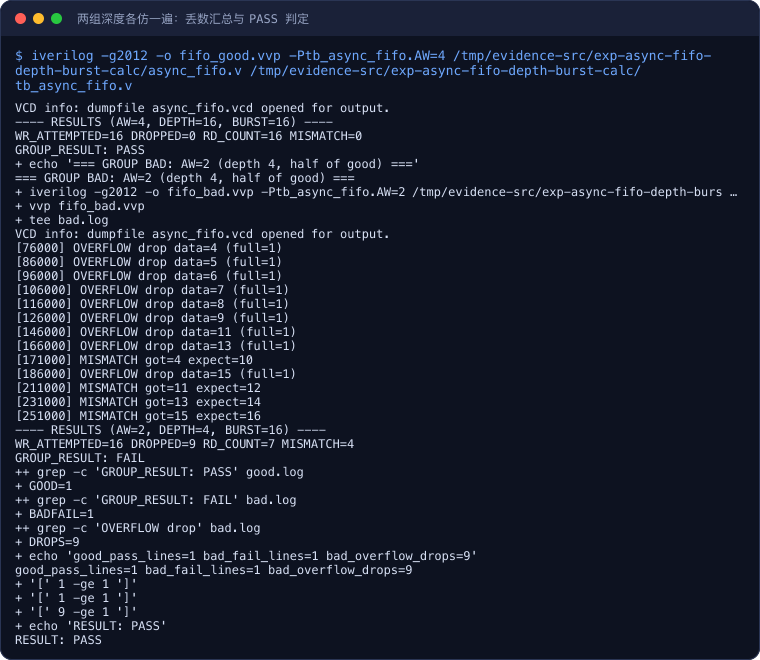
读这份实录抓三个位置:好组的汇总行 WR_ATTEMPTED=16 DROPPED=0 RD_COUNT=16 MISMATCH=0——16 个数据全进全出、零差错;坏组的汇总行 WR_ATTEMPTED=16 DROPPED=9 RD_COUNT=7 MISMATCH=4——16 个数据只读出 7 个;末尾 RESULT: PASS 是脚本的总体判定(好组必须 PASS、坏组必须 FAIL 且丢数 ≥1,才算实验本身成立)。再看坏组溢出过程的原样摘录,看丢数是怎么一个一个发生的:
[96000] OVERFLOW drop data=6 (full=1)
[106000] OVERFLOW drop data=7 (full=1)
[116000] OVERFLOW drop data=8 (full=1)
[126000] OVERFLOW drop data=9 (full=1)
[146000] OVERFLOW drop data=11 (full=1)
[166000] OVERFLOW drop data=13 (full=1)
[171000] MISMATCH got=4 expect=10
[186000] OVERFLOW drop data=15 (full=1)
[211000] MISMATCH got=11 expect=12
[231000] MISMATCH got=13 expect=14
[251000] MISMATCH got=15 expect=16
这几行把「深度不够」的死法展示得很完整。前 4 个数据填满了深度 4 的 FIFO,从第 5 个数据(data=4,时刻 76000)开始,每来一个突发数据 full 就挡掉一个,OVERFLOW drop 连打 9 行——写侧并没有报错停机,数据是静默消失的。更麻烦的是后半段的 MISMATCH:读侧期望读到的第 10 个数据实际拿到的是第 4 个,序号整体错位——下游如果按「第 N 拍读到的就是第 N 个数据」来做协议解析,丢数不会被发现,解析出来的是一堆错位的垃圾。这就是为什么 FIFO 溢出在硅后调试里极其难缠:它不产生异常,只产生错误的数据。
四、数字怎么读:公式预言与实测逐一对上
把两组实测数字并排(全部可在 run.log 的 RESULTS 行核对):
| 组别 | 深度 | 写入尝试 | 溢出丢数 | 读回数据 | 比对错误 | 判定 |
|---|---|---|---|---|---|---|
| 好组 | 16(≥12) | 16 | 0 | 16 | 0 | PASS |
| 坏组 | 4(要求的 1/3) | 16 | 9 | 7 | 4 | FAIL |
三个观察点。第一,丢数 9 比「净积压超支」更多。公式说净积压峰值 8、深度 4 装不下会丢 4 个左右,实测丢了 9 个——多出来的部分正是同步延迟的放大效应:full 撤销本身也要跨域同步,读侧明明已经读走数据腾出空间,写侧还要等两个写时钟才「知道」,这期间来的突发数据照样被挡。深度越小,这个同步延迟占总容量的比例越大,丢得越狠。
第二,读回数 7 + 丢数 9 = 16,账目完全闭合——没有数据藏在 FIFO 里没读出(仿真结尾留了 200 个读时钟的排空时间)。这个恒等式是检查 testbench 是否可信的好方法:写尝试数必须等于丢数加读回数,对不上说明 testbench 自己有问题。
第三,4 次 MISMATCH 全是序号错位而非数据损坏。丢数之后读侧期望值与实收值错开,属于丢数的次生灾害;如果坏组只丢数不比对,单靠「读回 7 个数据」甚至察觉不到出了事。这提醒工程实践:验证异步 FIFO 时 testbench 必须带序号一致性检查,光数个数不够。
五、落到工程:从公式到配置的三步
把这次实验折算成可操作流程:
| 步骤 | 动作 | 本篇的对应数字 |
|---|---|---|
| 1. 算净积压 | 突发长度 ×(1 − 读速率/写速率) | 16 × 0.5 = 8 |
| 2. 加同步余量 | 指针双向同步各 2 拍,折算成数据个数 | +4 → 12 |
| 3. 取 2 的幂并留档 | 向上取整,把推导过程写进设计文档 | 12 → 16 |
三条补充提醒。其一,读速率要按最差情况取——如果读侧可能被反压(下游忙、总线被抢),速率比要按反压期间的有效速率算,否则公式第一项就算小了。其二,连续多个突发之间如果间隔不够读侧排空,要按「连续突发合并」重新算积压,不能逐突发套公式。其三,仿真验证时务必跑一组「故意配不够」的反证用例——像本文坏组这样确认 testbench 真的能抓到溢出,否则好组的 PASS 可能只是检查逻辑失灵的假绿。异步 FIFO 的格雷码指针为什么能安全跨域,机制细节见 格雷码指针与 CDC;指针同步那两级触发器的定量分析见 两级同步器与亚稳态实测。
这一篇在知识体系里的位置
- 理论承接:FIFO 深度计算与设计(公式各项来源与 almost 水位);异步 FIFO 与跨时钟域(指针同步机制);
- 验证配套:同步 FIFO 设计与 iverilog 验证(FIFO testbench 的写法套路);两级同步器与亚稳态实测(同步余量那 2 拍的定量依据);
- 进阶延伸:格雷码指针与 CDC(异步 FIFO 指针为什么必须用格雷码)。
一句话总结
异步 FIFO 深度 = 突发长度 ×(1 − 读/写速率比)+ 指针同步余量,本篇场景算出 12、取 16;iverilog 反证实测:深度 16 零丢数全比对通过,深度砍到 4 立即溢出丢 9 个、读侧序号错位 4 次——深度公式的每一项都能在丢数日志里找到对应的尸体。
实验环境
- 机器/系统:云主机 S6.4XLARGE32 16C32G / Ubuntu 22.04(eda-golden-v1 镜像)
- 工具版本:Icarus Verilog(iverilog -g2012,eda-golden-v1 镜像自带)
- 日期:2026-10-25
- 完整命令:
bash run.sh(内部对好组执行iverilog -g2012 -o fifo_good.vvp -Ptb_async_fifo.AW=4 async_fifo.v tb_async_fifo.v && vvp fifo_good.vvp,坏组以-Ptb_async_fifo.AW=2同法执行,最后 grep 汇总两组的 PASS/FAIL 与丢数行数)
代码获取
异步 FIFO RTL、testbench 与运行脚本已同步到公开仓库:geek-doc.cn/experiments/exp-async-fifo-depth-burst-calc,克隆后进入该目录执行 bash run.sh 即可复现本文全部结果。