低功耗手段全景:架构、RTL、门级、工艺各层到底在省什么
更新时间:2026-09-15。本文是「集成电路大类 · 低功耗设计与验证」入门层系统篇第 17 篇,也是一张「地图」。前面学了公式、漏电、模型、翻转率,你手里已经有了零件;这一篇把所有省电手段按抽象层摊开,看清每一层在公式
P=½αCV²f+P_leak里拧的是哪个旋钮、杠杆有多大、什么时候介入。记住一条主线:越早的决策影响越大、改动越便宜。 后续低功耗设计全流程会把这些手段按时序串成 V 流程。系统地图见低功耗导读。
本文要回答的问题
- 那么多省电名词(门控、门极、DVFS、多阈值、并行、异构……)怎么归类?
- 为什么说功耗主要在架构阶段就被决定了?
- 每一层手段分别在治动态功耗还是漏电,代价是什么?
- 真要省电,先做哪一步、后做哪一步?
一、一张总图:四个旋钮,五层手段
回看功耗公式,能拧的旋钮其实只有四个:
P = ½·α·C·V²·f  +  P_leak
    └─动态─────┘    └─漏电─┘
旋钮:α 翻转率 / C 电容 / V² 电压(最狠) / f 频率 / 通电与否(漏电)
所有省电技术,都是在某一层去拧这四个旋钮之一。分层如下:
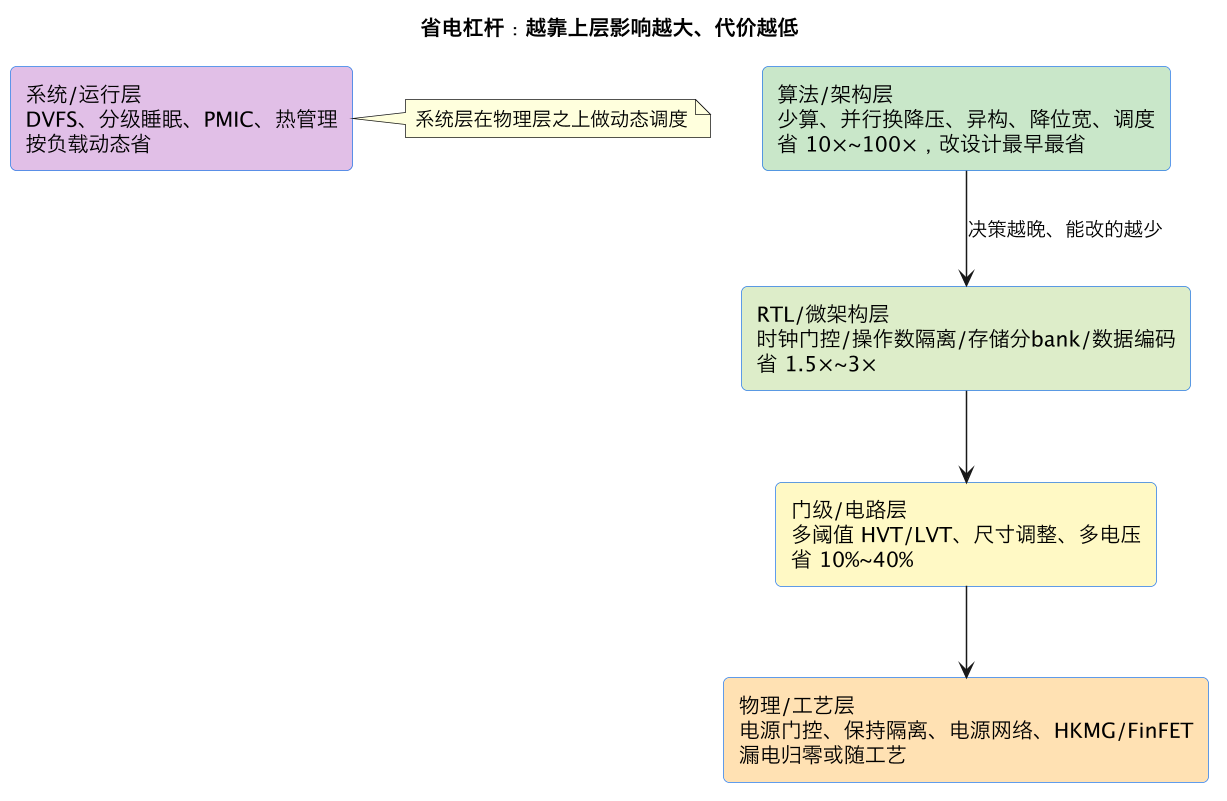
图中的倍数是数量级直觉,不是承诺。它表达的是相对杠杆:架构上少做一半运算,比后端把同样的运算优化 10% 收益大一个量级。
二、算法 / 架构层:决定「要算多少」,杠杆最大
这一层直接砍掉要完成的计算量或把工作点整体下移,是省电收益最大的地方:
- 降低算法复杂度 / 事件驱动:用更少的操作完成同一任务(更好的算法、查表替代实时计算、中断驱动替代轮询)。轮询改中断,能让处理器绝大部分时间睡眠而不是空转。
- 并行 + 降压的经典交换:把一条紧耦合的数据通路复制成 N 路并行,每路只需跑 1/N 的频率就能维持吞吐;频率低了就能显著降电压,而动态功耗随 V² 掉——用面积换能效。这是电压与频率物理底牌在架构层的应用。
- 异构与专用加速:让小核/专用加速器干轻活、大核只在重活时上电(big.LITTLE、NPU/DSP 卸载)。通用大核跑简单任务能效极差,专用单元用少量门完成特定运算,活动电容小得多。
- 降数据精度/位宽/近似计算:感知/推理类任务用 8bit、甚至近似结果即可,砍掉高位宽翻转和存储。
- 存储层级与数据搬运最小化:搬运一个比特到片外 DRAM 的能量常比算一次还贵,靠近计算放数据、压缩、减少访存,往往比优化运算更省。
- 任务调度(race-to-idle):把活集中快速做完、其余时间深睡,还是匀速慢跑,取决于漏电/唤醒代价(取舍见能量 vs 功率)。
为什么 80% 的功耗在架构阶段被决定:一旦算法要求每秒做十亿次某运算、或规定了某个高带宽常开接口,后端再怎么抠门控和多阈值也只能在这个既定的能量地板上优化;而架构阶段换个算法、加个加速器、允许事件驱动,地板可以直接降一个量级。
三、RTL / 微架构层:在给定算法下减少无谓翻转
算法定了,仍有大量能量浪费在「算了但结果没人用」的翻转上:
- 时钟门控(clock gating):空闲时停掉模块时钟,使能有效子树的 α 直接归零,是最该先做、几乎零代价的手段(见时钟门控直觉,RTL 写法后续《低功耗 RTL 直觉》篇展开)。
- 操作数隔离(operand isolation):模块输入无效时用使能挡住操作数,不让它们冲进加法器/乘法器引起一串无意义翻转。
- 存储器低功耗:SRAM 是耗电大户,分 bank 后只打开被访问的那一两块、未访问块进 retention、访问门控(后续存储器功耗篇)。
- 数据通路与编码:总线用格雷码/低翻转编码减少相邻跳变;避免把无关信号 fan-out 进大网络;流水化降低每级所需电压(频率-电压交换)。
- 局部性与使能:只在需要的拍读取寄存器/存储器,数据不变就保持。
这一层主要拧 α(翻转率),治的是动态功耗,对漏电无能为力。
四、门级 / 电路层:结构定了之后抠单元
综合和电路阶段在不改架构的前提下压榨:
- 多阈值混拼(multi-Vth):多数非关键路径用漏电小的 HVT,只给卡时序的少数路径上 LVT/SVT,零面积代价降漏电(见漏电与工艺)。
- 单元尺寸(sizing)/ 阈值重分配(Vt swapping):用刚好满足时序的最小驱动,多余的大尺寸单元是在白白带电容和漏电。
- 多电压域 / 动态调压:不同模块给不同电压(高压保性能、低压给能慢的块),运行时 DVFS 按负载调档。
- 门控时钟树重构:把 ICG 摆到合适层级,扩大一次性停摆的子树(时钟树功耗见后续时钟树功耗篇)。
这一层同时碰一点动态(降 C、降 V)和漏电(Vth),但量级是百分之几十,不是几倍。
五、物理 / 工艺层与系统运行层
物理与工艺层主要解决漏电和供电本身:
- 电源门控(power gating):长睡域用电源开关彻底断电,是唯一能把漏电归零的手段,代价是保持寄存器、隔离单元、电平和唤醒延迟这套基础设施(电源门控、电源域)。
- 电源网络与完整性:布满电源条/网格、控制 IR-Drop 与电迁移,保证省下来的低压真能送到管端(后续《电源网络》《IR-Drop》篇)。
- 器件与工艺红利:高 k 金属栅抑栅漏电、FinFET/GAA 改善关断、FD-SOI 体偏置——选什么工艺/库本身就是功耗决策。
系统 / 运行层让省电贴着真实负载动态发生:DVFS 调频调压、分级 sleep/deep-sleep、PMIC(后续《电源管理芯片 PMIC》篇)高效供电与上下电时序、热管理避免漏电正反馈(功耗与发热)。这一层把硬件预留的能力在软件上用起来,常常是产品实际续航差异的来源。
六、手段总表:一层一行,看清治什么、代价几何
| 层 | 代表手段 | 拧的旋钮 | 治动态/漏电 | 介入时机 | 主要代价 |
|---|---|---|---|---|---|
| 算法/架构 | 降复杂度、事件驱动、并行换降压、异构加速、降精度、减访存 | α、f、V、任务量 | 两者都治(整体能量地板↓) | 最早 | 改方案、可能加面积 |
| RTL/微架构 | 时钟门控、操作数隔离、存储分 bank、低翻转编码 | α | 主要动态 | RTL | 设计约束、验证 |
| 门级/电路 | 多 Vth、尺寸调整、多电压、门控树重构 | C、V、Vth | 动态+漏电 | 综合 | 库/流程、时序权衡 |
| 物理/工艺 | 电源门控、保持隔离、电源网格、HKMG/FinFET/GAA | 通电与否、器件 | 主要漏电 | 物理/选工艺 | 面积、唤醒延迟、复杂度 |
| 系统/运行 | DVFS、分级睡眠、PMIC、热管理、负载调度 | V/f、通电时间 | 两者 | 固件/OS | 策略、切换延迟 |
七、省电决策的先后次序:一条实用优先级
面对一个超标/想省电的设计,与其一上来就抠后端,不如按「先砍任务、再降工作点、再关翻转、最后治漏电」的顺序排,越靠前性价比越高:
- 先问能不能少做:这运算/采样/通信真的需要吗?轮询能否改中断?能否降精度/降采样率/换更省的算法?——砍任务量是数量级的省。
- 再降工作点:任务非做不可,能否用更低电压频率慢慢做完、或丢给小核/专用单元?——V² 是动态功耗最狠的项,配合 race-to-idle 决策(能量 vs 功率、DVFS)。
- 再消灭无谓翻转:空闲时钟门控、无效操作数隔离、存储器按需开——压 α,零代价优先做(时钟门控)。
- 最后治漏电:睡眠还不够深就上电源门控,非关键路径换 HVT——待机漏电是电池产品生命线,但它的基础设施代价最大,放在前几步把动态电先压下去后再精细做。
- 全程对账预算:每一步都回到功耗报告和预算表,看省下来的是不是热点、有没有超标,避免优化了不耗电的模块。
一个反例说明顺序的重要:在一个其实可以改成事件驱动、让 90% 时间睡眠的系统里,花大力气给常转的数据通路做多阈值和尺寸优化,只是在把「本该不存在的功耗」优化得更精致——架构层一句话的改动收益远大于后端两周。
八、用 Amdahl 视角看省电:先治占比最大的那一摊
手段选对了,还要用在刀刃上。一条朴素但常被违反的原则:一块电路再怎么优化,最多只能省掉它原本占的那部分功耗。 若 SRAM 和时钟树占了芯片动态功耗的 60%,把数据通路逻辑门控得再狠,整芯片也省不出多少;反之先对存储分 bank、对时钟树做层级门控,收益立竿见影。这就是为什么标准动作的第一步永远是跑一版功耗报告、按模块和类别排出热点(报告判读已强调),再决定优化哪个旋钮。
可以借用 Amdahl 定律的形式估算上限:若某子系统占总功耗比例为 p,把它的功耗降到原来的 k 倍(k<1),则整芯片功耗最多降到 (1−p)+p·k。例如占比 60% 的存储子系统做到省电一半(k=0.5),整芯片功耗变为 0.4+0.3=0.7,即降 30%;而占比仅 5% 的小模块即使完全归零,也只省 5%。先量化占比、再按杠杆排序、最后动手,比凭感觉优化高效得多,也避免「优化了一个不耗电的模块还引入面积/时序代价」。把这条和前文决策次序合起来:架构层砍任务量决定地板,报告热点决定把劲用在哪一摊,具体手段决定用哪个旋钮,预算表决定省到什么程度算够——四者闭环,才是工程化的低功耗方法。
这一篇在知识体系里的位置
- 各手段拧的公式旋钮 → 第 01 篇《功耗从哪来》、第 16 篇《翻转率》;
- 单点手段的直觉 → 时钟门控、电源门控、DVFS、多 Vth;
- 这些手段按时间怎么落进流程 → 下一篇《低功耗设计全流程》;
- 省电与续航/热的关系 → 电池能量预算、功耗与发热。
总结
一句话总结:五花八门的省电技术其实只在拧动态功耗公式 P=½αCV²f 与漏电项里的四个旋钮——翻转率 α、电容 C、电压 V(平方项、最狠)、频率 f 以及「是否通电」,而它们分布在杠杆差别巨大的五个抽象层:算法/架构层决定要算多少(降复杂度、事件驱动、用 N 路并行换每路跑 1/N 频率从而整体降电压、异构大小核与专用加速、降位宽精度、减少比计算更贵的片外访存、以及 race-to-idle 调度),能成十成百地降低整体能量地板,因为一旦算法规定了每秒运算量和常开高带宽接口,后端只能在既定地板上抠百分比,这就是约 80% 功耗在架构阶段被决定的原因;RTL/微架构层在算法既定下用时钟门控、操作数隔离、SRAM 分 bank 门控和低翻转编码消灭「算了没人用」的翻转,主要压 α 治动态功耗;门级/电路层用 HVT/LVT 多阈值混拼(非关键路径用高阈值、只给关键路径上低阈值)、单元尺寸/Vt 重分配和多电压域榨百分之几十,同时碰一点动态和漏电;物理/工艺层用电源门控把长睡域彻底断电(唯一能把漏电归零、代价是保持/隔离/电平转换/开关与唤醒延迟)、多轨电源网络以及 HKMG/FinFET/GAA 器件红利主要治漏电;系统运行层则用 DVFS、分级睡眠、高效 PMIC 和热管理让硬件能力贴着真实负载动态生效。正确的省电决策应按性价比从高到低「先问能不能少做(砍任务量,数量级收益)→ 再降工作点(利用 V² 与并行/异构和 race-to-idle)→ 再用门控和操作数隔离消灭无谓翻转压 α → 最后才上电源门控和多阈值精细治漏电」,并在每一步回到功耗报告和预算表对账热点,切忌在一个本该靠事件驱动长时间睡眠的系统里埋头优化常转数据通路——那只是把本不该存在的功耗优化得更精致。