NVSHMEM 分布式 kernel:推理引擎里的单边通信实战
更新时间:2026-10-07。前面 NCCL、RDMA 与 SHARP 卸载 讲过集合通信在训练/推理里的角色,MoE serving 的专家并行 讲过专家并行把 token 在 GPU 之间搬来搬去的必要性。本篇往下一层:当 all-to-all 的粒度小到「每层两次、每次几百微秒」时,NCCL 的集合通信启动开销开始吃不消,于是推理引擎开始用 NVSHMEM 分布式 kernel 把通信写进 kernel 内部,让 SM(Streaming Multiprocessor,GPU 上的计算单元)自己发起跨卡读写。
本文要回答的问题
- NVSHMEM 的单边通信(put/get)和 NCCL 集合通信本质差别在哪,为什么推理场景更吃这一套?
- NVSHMEM 分布式 kernel 在 MoE all-to-all 里怎么写,dispatch 和 combine 两个阶段的通信长什么样?
- 对称堆(symmetric heap)是什么,为什么 buffer 必须从这里分配?
- 把通信融进 kernel 之后,同步、fence、quiet 这些内存序语义怎么保证不出错?
- 什么情况下不该用 NVSHMEM,继续用 NCCL 反而更稳?
一、为什么推理 kernel 开始抛弃纯 NCCL
先看一组数。一次 NCCL all-to-all 的固定开销(kernel launch、channel 建立、协议协商)在 8 卡 NVLink 域内大约 20~40 微秒,跨机走 RDMA 时到 50~100 微秒。训练里这不算事——一个 allreduce 搬几百 MB,固定开销占比不到 1%。但推理的 MoE 层完全是另一个量级:以 DeepSeek-V3 类模型为例,每层 MoE 的 dispatch 阶段每张卡要发出的 token 隐藏向量总量常常只有几 MB(256 个 token、每个 7168 维 FP8 约 1.8MB),一次 all-to-all 的有效传输时间可能只有 30 微秒,固定开销占比直接过半。60 层模型每层两次 all-to-all,就是 120 次通信,光启动开销就能吃掉好几个毫秒的 decode 步时长——而 decode 一步总共才十几毫秒。
NCCL 的另一个结构性问题是「通信是通信、计算是计算」:集合通信以独立 kernel 形式提交到流上,和前后的 GEMM(通用矩阵乘)之间天然有同步边界。想重叠只能开多条流小心编排,而 all-to-all 的输出布局又依赖全部输入到齐,重叠空间很窄。
补一个背景:NVSHMEM 本身不是新东西,它的源头 OpenSHMEM 是超算领域跑了十几年的 PGAS(Partitioned Global Address Space,分区全局地址空间)标准,主打「超算上万个节点共享一套地址空间、任意节点单边读写」。NVIDIA 把这套语义搬到 GPU 上,早期主要服务科学计算,一直不温不火——直到 2024 年之后 MoE 大模型推理爆发,all-to-all 的粒度碎到集合通信兜不住,这个老技术才突然被推理圈翻出来当宝贝。技术选型里没有银弹,只有「负载形状变了,旧答案重新变优」。
NVSHMEM 给出的答案是换通信范式。NVSHMEM 是 NVIDIA 基于 OpenSHMEM 标准实现的 GPU 端单边通信库:每个参与进程(叫一个 PE,Processing Element)把一块对称堆内存注册进全局地址空间,之后任何一个 PE 的 kernel 里都可以直接 nvshmem_putmem() 把数据写进远端 PE 的显存,或 nvshmem_getmem() 拉回来——不需要对端配合、不需要先握手、不需要单独的通信 kernel。通信指令就是普通显存写,由 NVLink 或 RDMA 网卡硬件直接完成。
图里左右两条路径的对比就是全部动机:上面是传统模式,计算和通信被同步边界切成三段;下面是 NVSHMEM 模式,通信指令混在计算线程里发出,GPU 写完本地分片顺手把该给别人分片 put 过去,省掉了独立通信 kernel 的启动和排队。DeepSeek 开源的 DeepEP、以及 TensorRT-LLM 的 MoE all-to-all 插件,走的就是这条路——这也是 NVSHMEM 分布式 kernel 在推理侧走红的直接原因。
二、对称堆与 PE:NVSHMEM 的内存世界观
NVSHMEM 的第一个概念门槛是对称堆(symmetric heap)。所有跨 PE 通信的 buffer 必须用 nvshmem_malloc() 从对称堆里分配,库保证同一个分配调用在每个 PE 上返回相同的虚拟地址偏移——0 号 PE 上地址 X 的 buffer,在 1 号 PE 上也是地址 X。这个「对称」性质让 kernel 里算远端地址变成一次加法:远端地址 = 本地地址 + 目标 PE 的基址差,而基址表在初始化时就交换好了。
初始化流程四步走,顺序不能错:
nvshmem_init();                          // 建立 PE 间连接
int mype  = nvshmem_my_pe();             // 我是几号
int npes  = nvshmem_n_pes();             // 总共几个
void *buf = nvshmem_malloc(BUF_BYTES);   // 对称堆分配
nvshmem_barrier_all(); // 等所有 PE 就绪两个容易踩的点。其一,nvshmem_malloc 本身是集合操作——所有 PE 必须以相同顺序、相同大小调用,否则堆布局错位,put 会写进莫名其妙的地址。其二,对称堆大小受 NVSHMEM_SYMMETRIC_SIZE 环境变量限制(默认往往只有 1~2GB),推理服务要放 dispatch buffer、combine buffer、信号量数组,得显式调大,DeepEP 这类库通常要求预留到 8~16GB。显存预算紧张时这是第一个要砍要算的项。
图里画的是三 PE 的对称堆布局:每个 PE 的堆内 buffer 偏移一致,任何 PE 想给 PE2 的 dispatch buffer 写数据,本地算一下偏移就能直接 put。这种「地址即身份」的设计是把通信做进 kernel 的前提——如果每次通信前还要查表、握手,就回到 NCCL 的老路了。
三、MoE dispatch/combine:一个完整的 NVSHMEM 分布式 kernel 长什么样
以 expert parallel(专家并行,把不同专家放到不同卡上,token 按路由结果跨卡搬运)为例。MoE 层的通信分两段:dispatch 把 token 按路由结果发到目标专家所在 PE,combine 把专家算完的结果发回 token 原来所在 PE(通常是 all-to-all 的逆向)。
dispatch kernel 的骨架逻辑是这样的:每个线程块负责一批 token,先读路由表算出每个 token 该去哪个 PE,然后直接把 token 的隐藏向量 nvshmem_putmem_nbi()(nbi = non-blocking,非阻塞版本,只下单不等完成)写到目标 PE 的接收槽位,最后用一个原子信号量告诉对端「给你发了 N 个」。combine 阶段反过来:专家算完后,每个 PE 把结果 put 回 token 的来源 PE,同样用信号量收尾。
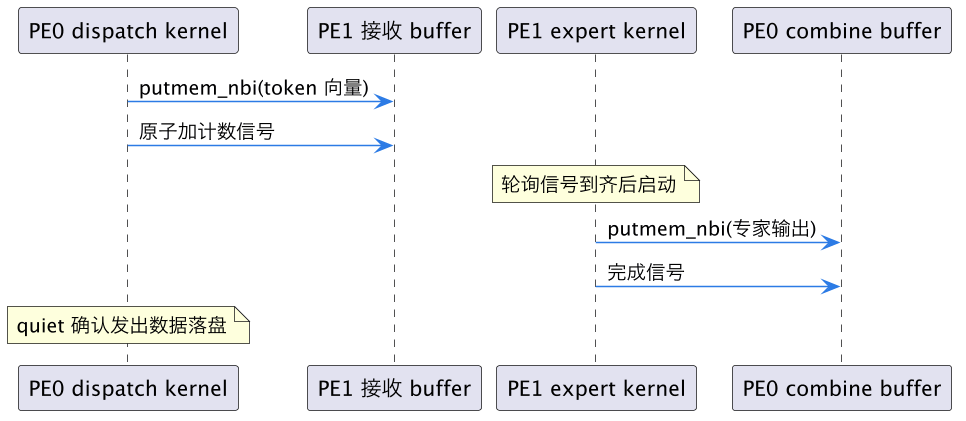
这张时序图里有两个细节值得盯着看。第一,发射端用 nbi 版本连续下单,不等每次传输完成,把多次 put 在硬件层面流水化——这是 NVSHMEM 性能的关键来源,一次 decode 步里数百个小 put 如果每个都同步等待,延迟会原地爆炸。第二,数据写完和信号到达之间的顺序不是自动保证的:put 的数据可能还在 NVLink 的路上,信号先到了,对端就会读到旧数据。所以信号量之前必须插 nvshmem_fence()(保证此前所有 put 对本 PE 发起的后续操作可见),发射端收尾再来一次 nvshmem_quiet()(保证所有 put 真正到达远端内存)。fence 管顺序、quiet 管完成,这两个语义搞混是 NVSHMEM 分布式 kernel 最常见的事故源,没有之一。
接收侧的经典写法是「信号量轮询 + 就绪计数」:专家 kernel 启动前先 spin 等自己槽位的计数达到预期值。DeepEP 在此之上做了两层优化——用 SM 专门做通信转发(把若干 SM 划成通信 worker,计算 SM 不等通信),以及低延迟模式下绕过协商直接写预分配环形槽,把一次 all-to-all 的端到端延迟压到几十微秒量级。这些优化都建立在「通信原语足够便宜」的前提上,而这正是 NVSHMEM 给的。
还有一个工程细节值得点名:dispatch 的接收槽位布局。token 到哪个 PE 是路由动态决定的,接收侧事先不知道会收到多少个,常见做法两种。一种是「上限预留」:按最大 batch × 每 PE 最大 token 数预留定长槽位,简单粗暴但显存浪费大,高并发下槽位随并发线性膨胀。另一种是「两阶段」:先用一次极小的通信交换各 PE 的 token 计数,再按实际数量紧凑写入——DeepEP 的普通模式走的就是这条路,低延迟模式则为了省掉这一次交换直接用上限预留加环形复用,用显存换延迟。选哪种没有标准答案,batch 小且稳选预留,batch 抖动大选两阶段。
| 维度 | NCCL all-to-all | NVSHMEM 分布式 kernel |
|---|---|---|
| 通信发起方 | 独立通信 kernel | 计算 kernel 内的线程 |
| 固定开销 | 20~100us/次 | 接近 0(指令级) |
| 计算通信重叠 | 多流编排,边界粗 | 天然指令级交错 |
| 同步语义 | 集合语义,框架保证 | 手写 fence/quiet/信号量 |
| 消息粒度 | 大块连续数据 | 任意小、分散 put 也划算 |
| 编程门槛 | 低,调 API | 高,要懂内存序 |
| 典型适用 | 训练梯度同步、大张量 TP | MoE all-to-all、细粒度 EP |
表格最后一行就是选型结论:通信粒度大、模式规整就走 NCCL 与 RDMA 卸载;粒度碎、每层多次、延迟敏感,才值得上 NVSHMEM 分布式 kernel。
四、除了 MoE:推理里还有哪些 NVSHMEM 用法
MoE all-to-all 是主战场,但不是唯一。
KV cache 的跨机拉取是一个增长点。PD 分离(prefill/decode 分离)架构里,prefill 节点算完 KV 要交给 decode 节点,chunked prefill 与 PD 分离 里讲过这条数据通路。用 NCCL 做 KV 传输需要双方约定时机走集合语义,而 decode 侧的消费节奏是流式的——每步 decode 可能只想拉某几层 KV 的某几页。NVSHMEM 的 get 让 decode 节点按需单边拉取,prefill 节点写完打个标记就不用管了,天然贴合生产者-消费者模型。NVIDIA 的 NIXL 传输库和 Mooncake 的传输层都在往这个方向演进。
第二个用法是跨机张量并行的细粒度融合。张量并行与 NVLink 域 讲过 TP 里 allreduce 的频率问题;当 TP 跨出 NVLink 域到了 RDMA 网络,有人尝试把 allreduce 拆成「每算完一块就 put 部分和到对端」的流水形态,用 NVSHMEM 把通信藏进 GEMM 的 epilogue。这类 fused TP kernel 对内存序的要求极高,目前主要出现在研究型引擎里,但方向是明确的。
第三个用法常被忽略:多机推理框架本身的控制面。多机推理编排 讲的是 Ray 层面的调度,而引擎内部的全局计数器、分布式 barrier、负载状态广播,用 NVSHMEM 的原子操作和信号量实现比走 TCP/gRPC 控制通道低两到三个数量级的延迟——对每步十几毫秒的 decode 循环来说,控制面快一毫秒都是白捡的。

图里四个应用场景共用同一组对称堆原语,这正是一个推理引擎引入 NVSHMEM 后的复利效应:第一套 MoE kernel 把初始化、内存管理、内存序封装趟平之后,后面每个新场景的边际成本都很低。
五、踩坑清单与验收口径
把 NVSHMEM 分布式 kernel 写上生产,坑集中在五处。
内存序事故排第一。 数据 put 之后没 fence 就打信号,对端读到旧值——这类 bug 在低负载下完全不出现,高负载 NVLink 拥塞时才偶发,排查极其痛苦。纪律只有一条:任何「先写数据、后写标志」的模式,中间必须有 fence;发射侧退出前必须有 quiet。
对称堆耗尽。 推理服务长跑,dispatch buffer 按最大 batch 预留后,剩余堆空间要给 KV 拉取和控制面用,堆满了 nvshmem_malloc 返回 NULL 而不是报错,不检查返回值就是定时炸弹。
IB 多网卡绑定。 跨机时 NVSHMEM 通过 NVSHMEM_IB_GID_INDEX 等变量选网卡和 GID,多轨 RDMA 机器上选错网卡性能直接掉一个数量级,症状是带宽测试正常但小消息延迟翻几倍——因为走到了绕路的端口。
与 CUDA Graph 的兼容性。 NVSHMEM 操作可以被 Graph 捕获,但 PE 间拓扑和 buffer 地址在捕获后不能变;推理引擎用 Graph 加速 decode 时,对称堆布局必须在捕获前冻结,运行期再 nvshmem_malloc 会炸。
调试工具缺失。 NCCL 有 NCCL_DEBUG=INFO 一把梭,NVSHMEM 的日志粒度粗得多,通信错误常常表现为「结果数值不对」而非明确报错。实用做法是开发期给每次 put 加校验和侧写,把「通信正确性」变成可单测的属性。
最后提醒一条版本风险:NVSHMEM 的 API 和行为在 2.x 到 3.x 之间有破坏性变更(初始化属性结构、团队 API、部分环境变量改名),推理引擎升级依赖库时必须跑一遍通信正确性回归,不能只看编译通过。网上教程里 nvshmem_init 一把梭的写法在配 InfiniBand 的机器上往往还要补 nvshmemx_init_attr 指定传输方式,照抄老教程是跨机部署翻车的高发起点。
验收口径上,NVSHMEM 分布式 kernel 的收益看三个数:单层 all-to-all 端到端延迟(从 NCCL 模式的近百微秒降到几十微秒)、decode 步总时长里通信占比(目标从 30%+ 压到 10% 以内)、以及 SM 占用率(通信 worker SM 不能吃掉计算 SM 的口粮,DeepEP 低延迟模式通常划出 10~20 个 SM 做转发,这部分算力是净成本,要在收益里扣掉)。
这一篇在知识体系里的位置
本篇是多机推理通信层的进阶篇:上游 NCCL、RDMA 与 SHARP 卸载(集合通信基线)、张量并行与 NVLink 域(单机内互联);同层 MoE serving 的专家并行(为什么需要 all-to-all)、多机推理编排(控制面视角);下游衔接 PD 分离的 KV 传输与引擎 kernel 调优。
总结
NVSHMEM 分布式 kernel 的核心是把通信从「独立 kernel 的集合操作」变成「计算线程里的单边 put/get 指令」:对称堆让所有 PE 共享同一套地址布局,非阻塞 put 加 fence/quiet 保证顺序与完成,信号量做轻量同步——这套原语把 MoE all-to-all 的固定开销从近百微秒压到接近零,是 DeepEP 这类推理通信库的底座;代价是要手写内存序、管理对称堆、自己保证正确性,所以只在通信粒度碎、延迟敏感的 MoE 专家并行、KV 单边拉取、细粒度 TP 融合场景才值得替换 NCCL,通信大而规整的地方继续用集合通信反而更稳。