SystemVerilog predictor 记分板:期望模型分层与 in-order/out-of-order 比对衔接
更新时间:2026-09-29。在 scoreboard 队列实现 里我们讲清了记分板「拿两个流比大小」的底层结构,在 UVM 记分板 trace 对齐 里讨论了比错之后怎么对齐波形和日志。但这两篇都有一个没展开的假设:期望数据已经躺在某个队列里了。真实项目里期望数据不是天上掉下来的——它由 predictor(预测模型,也叫期望模型、reference model)根据输入侧 transaction 一笔笔算出来。predictor 算错了,记分板比对再严也是白搭;predictor 和比对策略没衔接好,乱序 DUT 会把你满屏报红。这一篇把 predictor 的分层结构、它跟 in-order/out-of-order 比对的衔接关系一次讲透。
本文要回答的问题
- predictor 在 scoreboard 体系里到底扮演什么角色,为什么不把它和比对逻辑揉在一个类里?
- 期望模型的三层结构(事务级、变换级、时序级)各管什么,边界划在哪里?
- predictor 的输出怎么接进 in-order 队列比对和 out-of-order 关联比对?
- DUT 乱序返回时,predictor 要不要跟着乱序,ID 关联键怎么选?
- 用 DPI 调 C 参考模型时,predictor 的接口怎么设计才不拖累仿真速度?
一、predictor 是什么:记分板的「出题人」
先把角色摆清楚。一个完整的自校验环境里有三条数据流:激励流(sequence → driver → DUT 输入)、观测流(DUT 输入输出 → monitor → analysis port)、判决流(predictor 算期望 → scoreboard 比对实际)。predictor 坐在判决流的最上游,它只消费输入侧 transaction,只产出期望输出 transaction,从不直接看 DUT 的任何信号。
这个定位带来一条硬约束:predictor 必须是 DUT 功能的独立重述,而不是 DUT RTL 的翻译。如果 predictor 只是把 RTL 逻辑用 SystemVerilog 类再写一遍,那两边犯同一个理解错误时就永远比不出来——验证的价值恰恰在于「两份独立实现互相拷问」。工程上常见的独立性来源有三种:按协议规格书自然语言重写的事务级模型、算法团队的 C/Matlab 参考模型(经 DPI 接 C 参考模型 引入)、上一版已流片 RTL 的行为级封装。
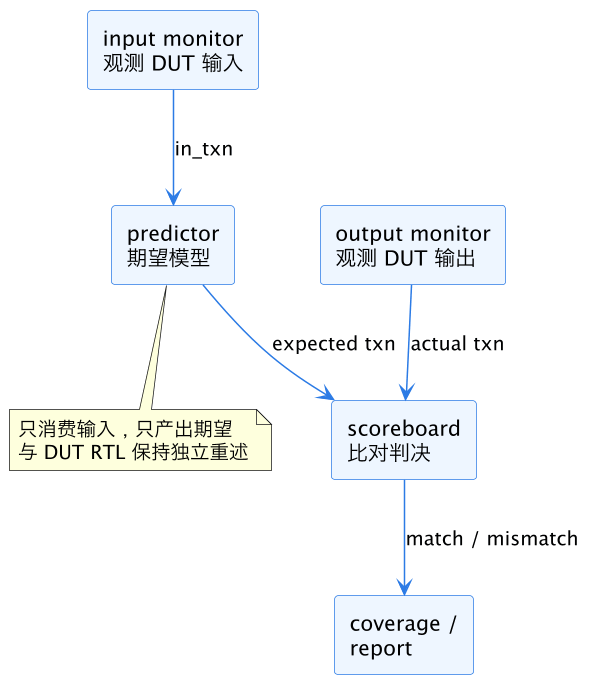
上图要注意箭头的方向:predictor 的输入来自 input monitor 的 analysis port,不是 driver,更不是 sequence。原因很简单——driver 发出去的东西可能还没真正上总线(比如被反压顶住),monitor 看到的才是 DUT 真实吃进去的那一笔。以 monitor 为准,期望模型和 DUT 看到的就是同一份输入,比对才有意义。
UVM 官方库里有个 uvm_subscriber 基类,自带一个 analysis_export,predictor 常直接继承它;也有很多团队让 predictor 继承 uvm_component 再手动声明 uvm_analysis_imp,两者等价。关键不在这里,而在 predictor 的输出口:通常声明 uvm_analysis_port #(exp_txn) exp_ap;,每算出一笔期望就 exp_ap.write(exp),下游 scoreboard 用 uvm_analysis_imp 接住。这样 predictor 和 scoreboard 之间是标准的 analysis 广播,一对多、零耦合,想加第二个记分板(比如性能记分板)直接订阅即可。
二、期望模型的三层结构:别把一切塞进一个函数
刚写 predictor 的人最容易犯的错是搞一个 2000 行的 predict() 函数,协议解析、数据变换、时序调整全在里面,三个月后没人敢动。可维护的 predictor 按职责分三层,每一层输入输出都是 transaction,层间用 analysis port 或简单句柄调用衔接。
| 层次 | 职责 | 输入 | 输出 | 典型内容 |
|---|---|---|---|---|
| 事务级(transaction layer) | 把总线事务还原成语义操作 | AXI/AHB 写事务 | 「往 0x100 写 4 字节 0xdeadbeef」 | 地址译码、burst 拼合、窄传扩展 |
| 变换级(transform layer) | 按规格书算期望结果 | 语义操作 | 期望输出(无 timing) | 查配置表、算法运算、状态机推进 |
| 时序级(timing layer) | 给期望结果加输出时序约束 | 期望输出 | 带 delay/latency 窗口的期望 | 最小/最大延迟、乱序窗口、反压语义 |
事务级解决「总线语言到自然语言」的问题。DUT 是 AXI 从机时,monitor 给的是一笔笔 burst 事务,predictor 先把 INCR burst 的 16 拍拼成一个完整的「写 256 字节」操作再往下传,变换级就不用懂 burst 切分规则。这层通常最厚,占 predictor 代码量一半以上。
变换级是真正「算期望」的地方,它的黄金法则是无时间、无周期:输入一笔操作,输出一笔期望,中间是纯函数式的数据变换。把 timing 排除在外有两个好处:一是这层可以直接被 DPI-C 参考模型替换而接口不变;二是同一份变换级代码既能喂 in-order 记分板,也能喂 out-of-order 记分板,不用改一行。
时序级只在必要时存在。很多设计(比如简单寄存器块)期望输出的时序是固定的,这层可以省掉,scoreboard 默认「输入后第 N 拍出结果」。但对乱序返回的 NOC、多 outstanding 的存储控制器,这层负责给每笔期望打上「最早/最晚到达时间」和「可乱序范围」标签,交给 out-of-order 比对去消费。
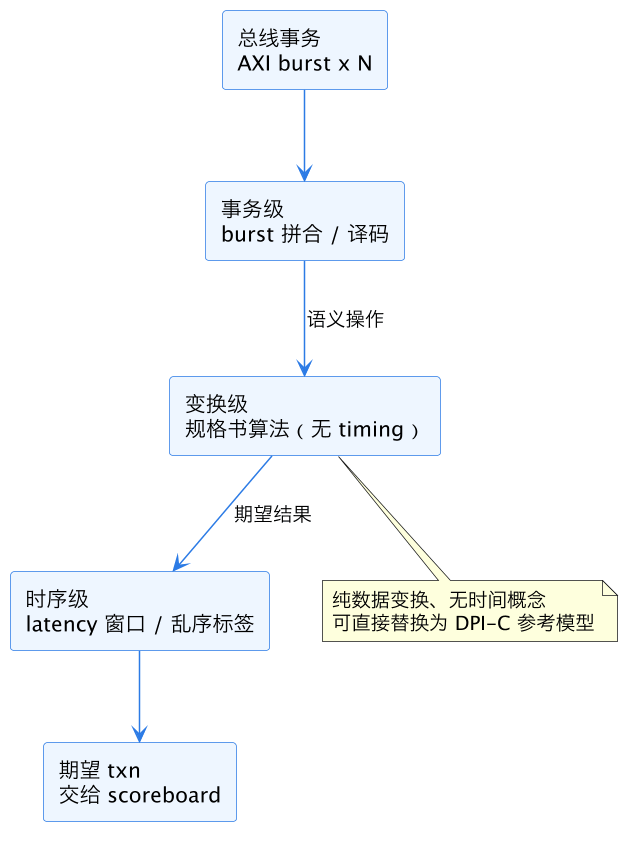
三层之间的接口建议都用「克隆后的新 transaction」传递,不要复用同一对象改字段——predictor 内部如果留了可变共享对象,一旦 scoreboard 那边 clone 漏了,期望数据会被后一笔输入静默改写,这种 bug 查起来要人命。
拿一个真实例子把三层走一遍。假设 DUT 是一个数据加扰器,AXI-Stream 进、AXI-Stream 出,规格书约定「每个 64 字节块用当前配置寄存器里的种子做异或加扰,输出延迟 3 到 9 拍」。输入侧 monitor 报上来三笔 burst 事务,事务级先把它们拼成「一个 192 字节帧」的语义操作,顺便检查帧边界是否对齐 64 字节;变换级拿配置模型的种子做纯数据异或,算出 192 字节的期望输出,这一层完全不知道什么是时钟拍;时序级给这笔期望贴上「最早 3 拍、最晚 9 拍」的窗口标签。记分板拿到实际输出后,先比数据、再查到达拍数是否落在窗口内,两个维度任一越界都报错。三层各管一段,改协议细节动事务级,改算法动变换级,改时序规格动时序级,互不牵连。
三、predictor 到 in-order 比对:队列是最简单的衔接
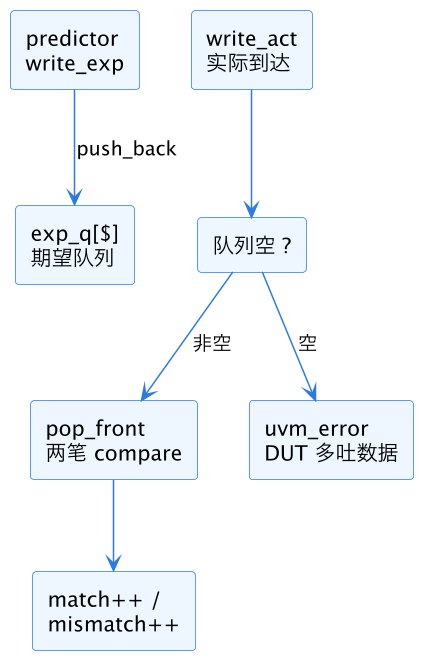
DUT 保证按输入顺序返回结果时(绝大多数流水线型模块、单通道 DMA、简单桥),predictor 的输出直接接 in-order 记分板:期望侧一个队列,实际侧一个队列,按到达顺序两两弹出比对。这正是 scoreboard 队列实现 里讲的结构,这里补的是衔接细节。
class my_predictor extends uvm_subscriber #(in_txn);
  `uvm_component_utils(my_predictor)

  uvm_analysis_port #(out_txn) exp_ap;

  // 变换级:规格书算法
  localparam int GAIN_TABLE [16] = '{1,2,4,8, 16,32,64,128,
                                     1,2,4,8, 16,32,64,128};

  function void write(in_txn t);
    out_txn exp = out_txn::type_id::create("exp");
    exp.id      = t.id;                    // 关联键原样透传
    exp.payload = t.payload * GAIN_TABLE[t.mode];
    exp.crc     = calc_crc(exp.payload);   // 派生字段 predictor 算
    exp_ap.write(exp);
  endfunction
endclass
记分板一侧用两个 uvm_analysis_imp 分别接期望流和实际流,各入各的队列:
class in_order_sb extends uvm_component;
  `uvm_component_utils(in_order_sb)

  uvm_analysis_imp_exp #(out_txn, in_order_sb) exp_imp;
  uvm_analysis_imp_act #(out_txn, in_order_sb) act_imp;

  out_txn exp_q[$];
  int unsigned n_match, n_mismatch;

  function void write_exp(out_txn t);
    exp_q.push_back(t);
  endfunction

  function void write_act(out_txn t);
    if (exp_q.size() == 0) begin
      `uvm_error("SB", "actual arrived but no expectation queued")
      n_mismatch++;
      return;
    end
    out_txn e = exp_q.pop_front();
    if (!t.compare(e)) begin
      n_mismatch++;
      `uvm_error("SB", $sformatf("mismatch:\nexp=%s\nact=%s",
                 e.sprint(), t.sprint()))
    end else n_match++;
  endfunction
endclass
这段代码里藏着 in-order 衔接的三个要点。第一,期望先进队、实际触发比对:predictor 通常在输入 monitor 发布事务的同一拍就算出期望,DUT 输出有流水线延迟,所以期望几乎总是先到,队列深度就是「已输入未输出」的在途事务数,回归里打印它的最大值能直接看出 DUT 的 outstanding 能力有没有被用满。第二,空队列比对是最严厉的协议检查:实际到达而期望队列为空,说明 DUT 多吐了东西(或者 monitor 漏收了输入),这比数据不匹配更基础,要单独报错。第三,predictor 里把 id 原样透传——即使 in-order 用不上它做关联,报错信息里带上 id 也能让调试快十倍。
四、predictor 到 out-of-order 比对:关联键是衔接的灵魂
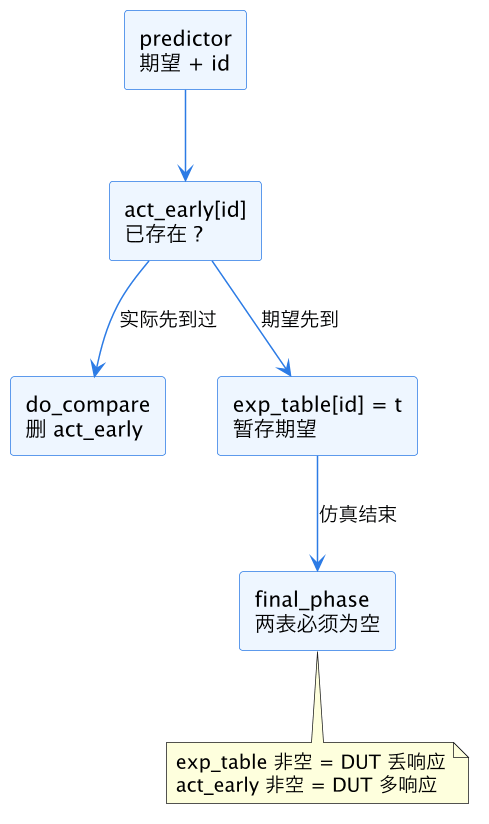
DUT 一旦允许多 outstanding 乱序完成——典型如支持 QoS 调度的存储控制器、多通道交错返回的 NOC——in-order 队列立刻失效:第一笔输入的期望还没等到实际输出,第三笔的实际输出先到了,按队列头一比必然满屏误报。这时要换成关联式比对(associative matching),而 predictor 的职责也跟着变:它必须在期望 transaction 里算出一个唯一关联键。
关联键的候选有三种,按优先级选。首选是协议自带的 transaction ID——AXI 的 AWID/ARID、CHI 的 TxnID,这种键 DUT 必须原样返回,predictor 只需透传,是最干净的情形。其次是地址或序号,比如 DMA 按描述符索引返回、包处理按流号返回,只要规格书承诺同一键不乱序即可。实在没有协议键时才自己造:predictor 维护一张「内容哈希 → 期望」的表,按 payload 哈希关联——这条路有哈希冲突风险,且 DUT 若会修改数据再返回就完全失效,属于下策。
out-of-order 记分板的核心是一张关联数组:
class ooo_sb extends uvm_component;
  `uvm_component_utils(ooo_sb)

  uvm_analysis_imp_exp #(out_txn, ooo_sb) exp_imp;
  uvm_analysis_imp_act #(out_txn, ooo_sb) act_imp;

  out_txn exp_table [bit [7:0]];     // id -> 期望
  out_txn act_early  [bit [7:0]];    // 先到的实际(期望还没算出来)

  function void write_exp(out_txn t);
    if (act_early.exists(t.id)) begin
      do_compare(t, act_early[t.id]);
      act_early.delete(t.id);
    end else begin
      exp_table[t.id] = t;
    end
  endfunction

  function void write_act(out_txn t);
    if (exp_table.exists(t.id)) begin
      do_compare(exp_table[t.id], t);
      exp_table.delete(t.id);
    end else begin
      act_early[t.id] = t;           // 实际先到,暂存
    end
  endfunction

  function void do_compare(out_txn e, out_txn a);
    if (!a.compare(e))
      `uvm_error("SB", $sformatf("id=%0d mismatch", e.id))
  endfunction

  function void final_phase(uvm_phase phase);
    if (exp_table.num() != 0)
      `uvm_error("SB", $sformatf("%0d expected never arrived",
                 exp_table.num()))
    if (act_early.num() != 0)
      `uvm_error("SB", $sformatf("%0d actual unmatched",
                 act_early.num()))
  endfunction
endclass
相比 in-order 版,这套实现多了两个关键机制。一个是双向暂存:期望先到存 exp_table,实际先到存 act_early,后到的一方来了立即比对——别假设期望永远先到,DPI 参考模型算一笔可能要几毫秒仿真时间,实际输出反超期望在回归里天天发生。另一个是 final_phase 兜底:仿真结束时两张表都必须为空,exp_table 非空意味着 DUT 丢了响应(或死锁),act_early 非空意味着 DUT 返回了没有对应输入的数据,这两类错误在 in-order 结构里会被队列深度掩盖,out-of-order 结构里必须显式检查。
还有一个 predictor 侧的配合点:同 id 复用问题。AXI 同一 AWID 在上一笔写响应回来之前不能再发新写(协议强制),但有些自定义协议允许 id 环绕复用。如果 id 会复用,exp_table[id] 就必须从单槽位改成队列(out_txn exp_table[bit[7:0]][$]),同一 id 的期望按序排队、同 id 的实际按序弹出——本质是「每个 id 一条 in-order 队列」,这是 out-of-order 记分板最健壮的形态。
五、工程细节:时序窗口、DPI 性能与常见坑
期望和实际的比对往往不该是严格的 compare() 全等。时间戳字段、动态 token 数、ECC 校验位这些「DUT 每次跑都可能不同但合法」的字段,predictor 要么不算、要么给范围。实践做法是给 transaction 类写一个 do_compare 重载,用 uvm_comparer 的 mask 机制跳过这些字段,或者 predictor 直接输出区间:exp.latency_min = 4; exp.latency_max = 12;,记分板判定实际落在区间内即匹配。把「什么算对」的判定标准收敛在 predictor 一处定义,记分板永远只做机械比对,两边职责才清爽。
性能上最大的坑是 DPI 参考模型。一次 DPI 调用本身只要几十纳秒,但参考模型算一笔复杂包可能要算几万次浮点——如果 predictor 的 write() 里同步调用,input monitor 的 analysis 广播就被堵住,整个 testbench 的事件调度都被拖累。对策是把 DPI 调用挪到独立进程:write() 里只把输入克隆入队,run_phase 起一个 forever 循环,从队列取一笔、调 DPI、发期望。队列同时天然吸收输入突发,参考模型算得慢就让队列涨着,不阻塞任何人。一个可量化的经验值:参考模型单笔耗时超过仿真一秒的千分之一时,就必须走异步队列方案,否则 24 小时回归会被拖成 48 小时。
常见坑清单,按踩坑频率排:
- 期望对象被复用污染:predictor 里
exp = t.clone()之后改字段,却忘了 clone 是浅拷贝,payload动态数组仍和输入共享,输入侧 reuse 对象时期望跟着变。要么 deep copy,要么新建对象逐字段赋值。 - 关联键宽度截断:
bit [7:0] id配int id的实际侧,exists 查找两边类型不一致,永远 mismatch。键的类型在 predictor 和 scoreboard 里用同一个 typedef。 - predictor 偷偷看 DUT 状态:有人图省事从 predictor 里
uvm_hdl_read探 DUT 内部寄存器来「修正」期望,这就把独立重述变成了 RTL 镜像,predictor 和 DUT 一起错时验证完全失明。配置信息可以走 backdoor 读寄存器模型,但算法本身必须独立。 - 复位期间不清队列:DUT 复位会丢掉在途事务,predictor 和 scoreboard 的队列/关联表必须在复位事件里同步清空,否则复位后第一波比对全是旧账。predictor 订阅 reset monitor 的 analysis port 是标准解法。
- 把比对容差写进记分板而非期望:比如「payload 允许 1 个 bit 翻转」这种判定,写在 scoreboard 里会让同一 predictor 接多个记分板时行为不一致,容差属于期望的定义,应该在 predictor 或 transaction 的
do_compare里。
最后说一条流程纪律:predictor 报错率异常升高时,先怀疑 predictor 再怀疑 DUT,但不许直接改 predictor 让它通过——正确动作是把期望和实际各打一份,回到规格书逐条对,确认哪边理解错了再改。reference model 和 RTL 之间的每一次分歧都是一次规格理解的对齐机会,把分歧改掉而不是盖掉,这才是 predictor 存在的意义。
这一篇在知识体系里的位置
- 向下承接:scoreboard 队列实现 讲清队列式比对的底层结构,本篇回答队列里的期望数据从哪来。
- 横向衔接:UVM 记分板 trace 对齐 解决比对失败后的波形/日志对齐,本篇解决比对发生前的期望生成。
- 输入侧依赖:monitor 与协议检查器 保证喂给 predictor 的输入事务本身合法、带协议键。
- 模型来源:DPI 接 C 参考模型 是变换级的常见实现路径;sequence 与 driver/scoreboard 协作 展示 predictor 在完整 UVM 环境里的接线位置。
总结
SystemVerilog predictor 记分板体系里,predictor 是出题人、scoreboard 是阅卷人:predictor 只消费 input monitor 的事务,按事务级(总线到语义)、变换级(规格书算法、无 timing)、时序级(延迟窗口与乱序标签)三层算出期望,经 analysis port 广播;in-order DUT 用双队列按序弹出比对,out-of-order DUT 用协议 transaction ID 做关联键、双向暂存加 final_phase 兜底查丢包多包;期望对象深拷贝、关联键同 typedef、复位同步清队列、容差定义收敛在 predictor 一侧,把这几条纪律守住,期望模型就能和 RTL 保持独立重述,让每一次 mismatch 都成为真正的规格拷问。