iverilog 入门:把第一份 Verilog 跑成波形
学会写几段 Verilog 之后,下一个问题自然是:怎么让它在自己的电脑上跑起来。开源世界里这件事的标准答案是 Icarus Verilog,命令行里通常叫 iverilog。它轻、装起来快、编译一个小设计只要几毫秒,是绝大多数人接触 RTL 仿真的第一个工具。本篇是 iverilog 入门的第一站,配套的姊妹篇 Verilator 入门 与 Yosys 入门 分别讲周期级编译仿真与逻辑综合;仿真器的通用原理可以先读 仿真器怎样跑 RTL,这里只聚焦 Icarus 这一条命令链上真实发生的事。
本文要回答的问题
- 在从 RTL 到 GDS 的整条 EDA 链路上,仿真这一站解决什么问题、产物交给谁?
iverilog编译出来的.vvp文件到底是什么,为什么还要第二个命令vvp才能跑?- 事件驱动仿真是什么意思,非阻塞赋值的更新在一个时钟沿内按什么顺序发生?
- 同一份 testbench,Icarus 跑出
final_count=11、Verilator 跑出 12,哪一个是对的? - 想在 GUI 里看波形,VCD 文件怎么产生、怎么交给 GTKWave?
一、先在 EDA 链路上找到仿真这一站
数字芯片的设计流程可以粗分为「写 RTL → 仿真验证 → 逻辑综合 → 布局布线 → 签核」几段,全景图见 从 RTL 到 GDS。仿真是综合之前的第一道关卡:它不关心门电路、不关心走线延迟,只回答一个问题——在 testbench 给定的激励下,这份 RTL 的行为是否符合预期。仿真的基本概念(testbench、DUT、激励、检查)在 仿真是什么 里有完整铺垫,本篇直接进入工具视角。
Icarus Verilog 在这条链路上占的是「前端功能仿真」这一格:输入是 .v 设计文件和 testbench,输出是仿真日志和可选的 VCD 波形。它不做综合,不会告诉你资源占用和时序收敛;那些是下游 Yosys、OpenSTA 的工作。把一次最小仿真的产物交接画成一张流程卡,先建立整体印象。
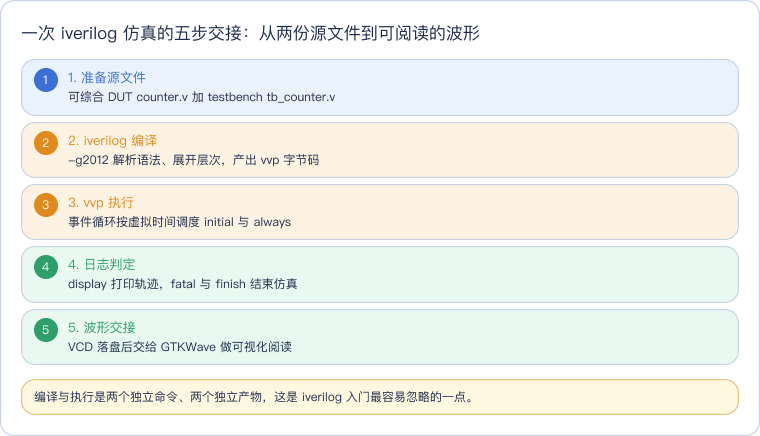
读这张卡抓住一条主线:源文件先被 iverilog 翻译成一种中间形态,再由 vvp 执行;执行过程中一边往终端写日志,一边可以把信号变化录成 VCD。日志回答「过还是没过」,波形回答「为什么没过」。本篇后面的章节就按这五步逐一拆开。
二、最小实验:一个带使能与同步复位的计数器
配套实验只有两个源文件。DUT 是一个 4 位计数器,带时钟、低有效同步复位和计数使能,全部时序逻辑用非阻塞赋值描述,是可综合风格的标准写法。
module counter #(
    parameter WIDTH = 4
) (
    input  wire             clk,
    input  wire             rst_n,
    input  wire             enable,
    output reg [WIDTH-1:0]  count
);
    always @(posedge clk) begin
        if (!rst_n)
            count <= {WIDTH{1'b0}};
        else if (enable)
            count <= count + 1'b1;
    end
endmodule
testbench 做四件事:用 always #5 clk = ~clk 造出 100 MHz 时钟(周期 10 ns);前三个时钟沿保持复位,随后释放复位、再等一拍拉高使能;然后循环 12 次,每次等时钟沿后打印当前时间、复位、使能和计数值;最后检查终值并 $finish。
`timescale 1ns/1ps
module tb_counter;
    reg        clk = 1'b0;
    reg        rst_n = 1'b0;
    reg        enable = 1'b0;
    wire [3:0] count;

    counter #(.WIDTH(4)) dut (
        .clk(clk), .rst_n(rst_n), .enable(enable), .count(count)
    );

    always #5 clk = ~clk;  // 100 MHz 时钟

    integer k;
    initial begin
        $display("time rst enable count");
        repeat (3) @(posedge clk);
        rst_n = 1'b1;
        @(posedge clk);
        enable = 1'b1;
        for (k = 0; k < 12; k = k + 1) begin
            @(posedge clk);
            $display("%4t  %0d    %0d     %0d", $time, rst_n, enable, count);
        end
        if (count !== 4'd11)
            $fatal(1, "counter mismatch: iverilog expected 11, got %0d", count);
        $display("PASS final_count=%0d", count);
        $finish;
    end
endmodule
开头的 `timescale 1ns/1ps 声明本文件的时间单位是 1 ns、仿真精度是 1 ps:代码里的 #5 就是延时 5 ns。打印用的 %t 格式符默认按仿真精度输出时间,没有调用 $timeformat 改单位时,45 ns 会印成 45000——单位是 ps,而不是 45 微秒,vvp 的 $finish 提示行里也标着 (1ps),两处口径一致。单位与精度不一致是多文件工程里常见的告警来源,规则细节见 timescale 继承与冲突。
注意 testbench 里故意把 $display 紧跟在 @(posedge clk) 后面,没有加任何时延。这是一个精心保留的调度细节:同一时钟沿内,读取动作与 DUT 的非阻塞赋值更新谁先发生,两套仿真器的口径不同,第四节会用这次运行的真实输出把它讲透。在本机复现只需两条命令,多文件工程的组织方式与 filelist 写法见 多文件 Verilog 工程怎么组织。
iverilog -g2012 -o counter-iv.vvp counter.v tb_counter.v
vvp counter-iv.vvp
-g2012 告诉编译器按 IEEE 1364-2005 加 SystemVerilog-2012 的子集接受语法;入门小例子用默认标准也能编,但养成显式声明标准的习惯,能避免后续用到 SV 语法时被默认模式拒绝。完整的参数体系(宏定义、包含路径、头文件搜索)在 iverilog 编译参数详解 里逐条展开。如果第一条命令就报 syntax error,先对照 iverilog 入门最常见的语法报错排查 定位,多数情况是少了 end、端口逗号或宏名拼写。
三、iverilog 编译出了什么:vvp 字节码与事件循环
新手常把 iverilog 理解成「Verilog 版 gcc」,这个类比只对了一半。gcc 编译出的是本机机器码,可以直接由操作系统加载执行;iverilog 的产物 counter-iv.vvp 是一种专属的字节码(vpi 字节码,也称 vvp 汇编),必须交给第二个程序 vvp 解释执行。也就是说,Icarus 的工具链是「编译器 + 虚拟机」两段式,和 Java 的 javac 加 java 形态更接近。
好奇的读者可以用文本编辑器打开 counter-iv.vvp:它不是不可读的二进制,而是 vvp 助记符组成的字节码文本,能辨认出模块名与调度指令,但人工阅读它没有调试价值——定位问题永远对着 RTL、日志和波形,而不是字节码本身。另外注意 .vvp 与平台无关,同一份字节码可以拷到任何装了匹配版本 vvp 的机器上直接运行,不需要重新编译,这也是「编译与执行分离」带来的实际好处。
这张图里蓝色是输入、橙色是两个处理动作、灰色是中间产物、绿色是两类最终产出。关键认知是:编译阶段只做静态的事——词法语法分析、模块层次展开(elaboration)、参数例化,然后把行为语义翻译成 vvp 指令;真正的「仿真时间」在 vvp 阶段才存在。编译期错误(语法、找不到模块、端口对不上)在第二步就会拦住你,运行期错误(除零、数组越界、fatal 断言)则要到第四步才暴露,两类问题的分流可以参考 vvp 运行期日志与追踪。
vvp 内部是一个离散事件驱动的仿真核。Verilog 语义里没有「全局一步一步走」的周期概念,只有带时间戳的事件:信号变化、块唤醒、系统任务调用都进事件队列,仿真核按虚拟时间从小到大取事件执行。同一个时间步内部还分区,最需要记住的是 active 区与 NBA(Non-Blocking Assignment,非阻塞赋值)区:阻塞赋值和大部分初值动作在 active 区立即生效,而 <= 的右端先求值、左端更新被推迟到 NBA 区。这个延迟不是性能妥协,而是在模拟真实触发器「沿上采样旧值、沿后更新输出」的行为。
蓝色是时间推进,红色是 testbench 的读取点,橙色是 DUT 的寄存器更新,绿色是这一步的稳定状态。读这张图要盯住红色和橙色的先后:testbench 在 active 区读 count 时,DUT 在本次沿上的 NBA 更新还没发生,所以读到的是上一拍留下的值。这正是下一节 final_count=11 的根因。通用调度原理(active/NBA 竞争、X 态、零时延冒险)在 仿真器怎样跑 RTL 第三节有更系统的讨论。
四、读懂运行记录:12 行轨迹与 final_count=11
下面是这次实验在 Ubuntu 24.04 容器里的真实运行记录,截取从命令入口到 Icarus 段 $finish 的完整输出。
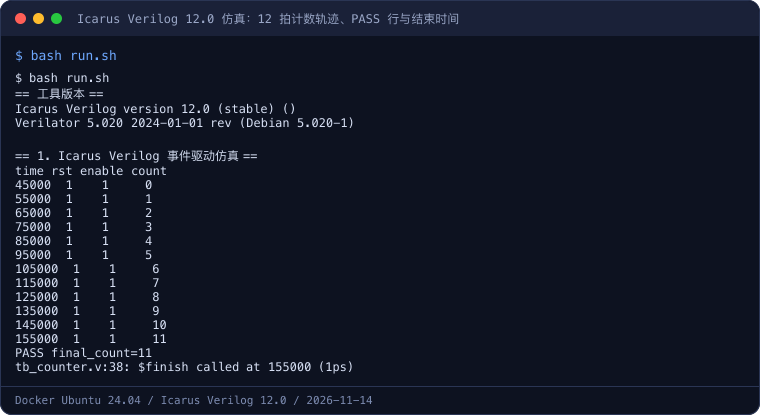
终端卡里 12 行轨迹的时间戳从 45000 到 155000,单位是 testbench timescale 里的 1ps,即 45 ns 到 155 ns,间隔恰好 10 ns,对应 100 MHz 时钟的 12 个连续周期;rst 与 enable 两列全程为 1,说明复位释放、使能拉高之后计数器连续跑了 12 拍。计数值从 0 打印到 11,最后一行是 PASS final_count=11,$finish 在 155000 被调用,仿真干净退出,没有 fatal、没有悬挂。
这里最容易卡住读者的问题是:使能后明明数了 12 个沿,为什么终值是 11 而不是 12?把第三节的调度顺序代进来就清楚了。每次循环里 testbench 在 active 区打印,DUT 的 NBA 更新排在后面;第一次打印发生在使能拉高后的第一个沿,此刻本次沿的自增还没生效,读到的是使能前的旧值 0。之后每个沿都是「先读到旧值、随后才更新」,12 次读取依次拿到 0 到 11。检查语句在同一个 active 区执行,因此期望写的是 11——这不是容忍误差,而是 Icarus 严格按 IEEE 标准的区域调度得到的确定结果。
| 观察项 | Icarus Verilog 12.0 | 同机 Verilator 5.020 对照 |
|---|---|---|
| 执行模型 | vvp 字节码 + 事件循环 | RTL 转 C++ 后本机编译,周期级调度 |
| 12 次读取的值 | 0 到 11 | 1 到 12 |
| 终值检查 | final_count=11,PASS | final_count=12,PASS |
| 差异来源 | active 区先读,NBA 更新在后 | --timing 下读取点观测到更新后的值 |
同一份 testbench 在 Verilator 5.020 加 --timing 的运行里终值是 12,实验仓用 VERILATOR 宏把两套预期隔离开,两边各自 PASS。两个结果都自洽,差别在「沿后立即采样」这个边界写法的调度口径,而不是谁有 bug;工程上的稳妥做法是让 testbench 驱动与采样错开一个小延时(如时钟沿后 #1 再读),避开区域边界。Verilator 侧的完整机理与适用场景留给姊妹篇 Verilator 入门,本篇不展开。
五、把信号变化留下来:VCD 与 GTKWave 的交接
日志只能打印你预先写进 $display 的量,排查未知问题时需要完整波形。Icarus 不自带波形窗口,它的分工是把信号变化录成 VCD(Value Change Dump,值变化转储)文本文件,再交给独立的开源波形浏览器 GTKWave。这个「仿真器负责录、查看器负责画」的解耦是开源工具链的典型交接,VCD 本身也是各大仿真器通用的交换格式。
录波形不需要改编译命令,只要在 testbench 的 initial 块开头加两个系统任务:$dumpfile 指定文件名,$dumpvars 指定记录层次,参数 0 表示从给定层次向下递归全部信号。
initial begin
    $dumpfile("counter.vcd");
    $dumpvars(0, tb_counter);
end
重新 iverilog 加 vvp 跑一遍,工作目录就会生成 counter.vcd,随后用 gtkwave counter.vcd 打开,在左侧 SST 层次树里选中 dut,把 clk、rst_n、enable、count 拖到波形区即可看到计数器逐拍加一的完整过程。从加系统任务到在波形区定位第一拍异常的完整操作链,照 iverilog 产出 VCD 并用 GTKWave 看波形 一步步做即可;GTKWave 里搜索信号、保存布局、用标记测量时间差的技巧见 GTKWave 波形分析实操。
| 交接点 | 产物 | 出错时的典型表现 | 对应排查入口 |
|---|---|---|---|
| testbench 内 | $dumpfile/$dumpvars | 跑通但找不到 VCD 文件 | dumpvars 缺失类报错 |
| vvp 执行后 | counter.vcd 文本 | 文件为空或只有头 | 确认 dumpvars 层次参数与仿真时长 |
| GTKWave 打开 | 波形视图 | 提示无法解析 VCD | VCD 解析失败排查 |
打开生成的 counter.vcd 可以看到它的结构:开头是日期、timescale 和模块层次声明,正文每一行记录一次值变化,标量只写新电平,向量用 b 前缀跟二进制值再附信号标识。因为它只在信号真正翻转时追加一行,静止信号不占空间,计数器例子的波形文件才只有几 KB;同样因为没有任何压缩,宽总线在高频时钟下持续翻转时,行数会以百万级膨胀。
VCD 是明文文本,小设计读起来直观,但它只记录变化、不做压缩,上万信号的大设计跑出来可能达到几百 MB,那是商用压缩波形格式(FSDB 等)的场景。入门阶段的计数器例子生成的 VCD 通常只有几 KB,完全没有体积压力,可以放心全量记录;波形格式的体积与取舍在 仿真波形数据库横评 里有专门比较。
六、7 毫秒意味着什么:编译耗时与工具边界
这次实验对两种仿真器各跑了三回合编译,取墙钟时间中位数,下面是日志里 Icarus 段的原始记录。
== 4. 编译耗时对照(各 3 次,毫秒墙钟取中位)==
iverilog run1: 7 ms
iverilog run2: 6 ms
iverilog run3: 7 ms
iverilog median: 7 ms
同一份日志里 Verilator 三回合是 3689、3612、3633 ms,中位 3633 ms,差不多是 Icarus 的五百倍。这个数量级差异不是性能调优问题,而是两条技术路线的固有成本:Icarus 只生成字节码,编译以毫秒计,代价是 vvp 解释执行的吞吐有限;Verilator 先把 RTL 翻译成 C++ 再调用系统 g++ 编译出本机二进制,首次编译要付出几秒甚至几分钟成本,换来的是大规模设计周期级仿真的高吞吐。
| 维度 | Icarus Verilog | 更适合换工具的信号 |
|---|---|---|
| 语言支持 | Verilog-2005 加常用 SV 子集,testbench 语义完整 | 大量 SV 高级特性、UVM 受限 |
| 编译成本 | 本例中位 7 ms,改完即跑 | 设计大到事件循环本身成为瓶颈 |
| 调试形态 | 日志加 VCD,配 GTKWave | 需要事务级、协议级可视化 |
| 典型用途 | 作业练习、小模块自检、CI 冒烟 | 大设计回归用 Verilator,签核口径用商业仿真器 |
入门阶段的选择其实很简单:写 testbench、学调度语义、跑小实验,Icarus 反馈最快、概念最标准;等同一个测试要跑几十万周期、仿真时间开始以分钟计时,再带着同一份 RTL 迁移到 Verilator,对照阅读 Verilator 入门 即可。而想知道「综合之后它变成多少个门」,那已经超出仿真器的职责,属于 Yosys 入门 的话题。
实验环境
- 机器/系统:Docker Ubuntu 24.04 容器,宿主机 i7-9750H、12 vCPU;纯命令行环境,无 GUI。
- 工具版本:Icarus Verilog 12.0 (stable);同容器另有 Verilator 5.020 仅用于对照段。
- 日期:2026-11-14。
- 完整命令:
bash run.sh,脚本内依次执行iverilog -g2012 -o counter-iv.vvp counter.v tb_counter.v与vvp counter-iv.vvp,随后跑 Verilator 对照、lint-only 与三回合计时。
代码获取:本实验完整代码(
rtl/counter.v、rtl/tb_counter.v)、run.sh与实测输出见公开仓库 derekzhuo/geek-doc.cn 的experiments/iverilog-verilator-first-lesson/。克隆后进入该目录执行bash run.sh即可复现本篇全部数字。
这一篇在知识体系里的位置
本篇是开源 EDA 入门系列的仿真入口,向上承接 从 RTL 到 GDS 的流程全景与 仿真器怎样跑 RTL 的通用原理。横向看,同一份计数器 RTL 的另一种仿真形态在 Verilator 入门,仿真通过之后的逻辑综合在 Yosys 入门。继续深挖 Icarus 本身,编译参数读 iverilog 编译参数详解,波形链路读 iverilog 产出 VCD 并用 GTKWave 看波形,工程化回归读 iverilog 回归脚本实践;动手时撞到具体报错,语法问题查 syntax error near token 排查,运行期问题查 vvp 日志与追踪,波形问题查 dumpvars 缺失。
总结
iverilog 入门的核心不是记住两条命令,而是理解三段交接:iverilog 把 RTL 与 testbench 编译成平台无关的 vvp 字节码,vvp 用事件循环按虚拟时间解释执行、严格区分 active 与 NBA 调度区,信号变化再以 VCD 为载体交给 GTKWave 阅读。 本次计数器实验里编译中位耗时 7 ms、12 拍轨迹从 45 ns 走到 155 ns、final_count=11 是 testbench 在 active 区先于 NBA 更新采样的确定结果;掌握这个采样口径,能亲手复现实验、看懂日志与波形,并知道何时该走向 Verilator 与逻辑综合,就算真正跨过了 RTL 仿真的第一道门槛。