Embedding 与 Rerank 推理服务:动态 batching、序列分桶与 GPU 利用率调优
更新时间:2026-10-03。前面 continuous batching 调度器 和 LLM 推理的 TTFT/TPOT 与 SLO 讲的是自回归大模型的服务化:每个请求逐 token 生成,调度围绕 KV cache 和 decode 步展开。Embedding(把文本编码成向量)和 Rerank(给查询-文档对打相关性分数)是另一类负载:encoder-only 模型、一次前向出结果、没有 decode 循环、单请求耗时以毫秒计。看起来简单,但真把 QPS 打上去会发现 GPU 利用率常年趴在 20% 上下——瓶颈不在算力,在「攒批」和「padding 浪费」这两个工程细节上。本文把这条调优路径完整走一遍。它和 ViT encoder 推理流水线 同属「encoder 类模型服务化」家族,可对照阅读。
本文要回答的问题
- Embedding/Rerank 服务的负载特征和 LLM 有什么本质不同,为什么不能照搬 continuous batching?
- 动态 batching 的「等一等再发车」策略怎么定?超时窗口开多大合适?
- 序列长度分桶为什么能把吞吐翻倍?padding 浪费的账怎么算?
- 双塔场景(在线 query 塔加离线文档塔)的优先级和资源怎么切分?
- batch size、并发流、精度三件套调完后,GPU 利用率能到什么水位?
一、负载画像:短、密、无状态的毫秒级前向
先把负载特征钉死,后面的所有决策都从这张画像推出来。
Embedding 模型(BGE、E5、GTE 这一族)和 Rerank 模型(bge-reranker 这类 cross-encoder)结构上都是 BERT 式 encoder:输入一段 token 序列,跑一次完整前向,输出一个向量(embedding)或一个标量分数(rerank)。与 LLM decode 相比,差异是颠覆性的:
| 维度 | LLM decode | Embedding/Rerank 前向 |
|---|---|---|
| 单步耗时 | 每 token 10~50 ms,生成几百步 | 整个请求 1~10 ms,一次了结 |
| 状态 | 有 KV cache,请求间不可随意混批 | 无状态,任意请求可自由拼批 |
| 序列长度 | 几千到几万 token | 通常 32~512 token |
| 瓶颈 | 显存带宽(搬 KV) | 算力与调度开销的交界 |
| 调度核心 | 连续批、抢占、分页 KV | 攒批、分桶、优先级 |
关键洞察是**「无状态、毫秒级」这五个字**。无状态意味着批的组成完全自由,随时来随时拼;毫秒级意味着如果来一个算一个,GPU kernel 启动、调度、拷贝的固定开销会把算力淹没——batch=1 跑一次 BGE-large 前向,有效计算可能只占墙钟时间的三成。所以 Embedding 服务吞吐优化的第一性原理就一条:把足够多的请求拼成一个大 batch 一次算掉,摊薄固定开销、喂满 tensor core。
Rerank 略有不同:它的输入是「查询+文档」拼接对,一个搜索请求要重排 50~200 个候选文档,天然自带「一个用户请求炸出几十个子请求」的扇出结构。这个特征后面会成为攒批的助力而不是阻力。
再补一个常被忽略的画像细节:请求的到达过程是突发的。检索流量跟着业务走,早晚高峰的 QPS 可能是凌晨的十倍;大促或热点事件时还有秒级脉冲。静态配置的批大小在高峰喂不饱、在低谷等不满,这就是「动态」二字存在的理由——所有攒批参数都得按到达率的分布而不是均值来定。压测时也别只打匀速流,要用接近真实的泊松到达或录制的线上流量重放,否则调出来的甜点参数一上线就漂。

上图是典型的检索管线双塔结构:query 先过 Embedding 塔取向量,向量库召回候选,候选与查询拼接后灌进 Rerank 塔精排。两塔的负载形状完全不同——Embedding 塔请求多而碎(每查询一次),Rerank 塔请求少而胖(每查询几十到几百次、序列更长)。后面会看到,这个差异决定了两者要分开调参。
二、动态 batching:用几毫秒等待换几倍吞吐
既然单算一个请求是亏的,最直接的策略是动态 batching(dynamic batching):请求来了不立即执行,进队列攒着;攒够目标 batch size 或者等待超时,就把队列里的一批打包成一次前向。Triton Inference Server、TEI(Text Embeddings Inference)都是这个思路。
核心参数只有两个,但每一个都是权衡:
- max_batch_size(最大批大小):越大越摊薄开销,但受显存和延迟上限制约。对 512 token、BGE-large 量级模型,A10 上 batch 64~128 通常正好把 SM 打满。
- max_wait_ms(最长等待窗口):攒不够就等到超时强制发车。窗口越长批越满、吞吐越高,但每个请求的排队延迟直接加在 P99 上。
经验公式:等待窗口设成单批前向耗时的 30%~50%。比如 batch 64 一次前向 8 ms,窗口开 3~4 ms 是甜点——高峰期请求到达率远超发车频率,队列几乎总是满的,窗口等于白拿吞吐;低谷期窗口兜底,延迟最多劣化几毫秒。
有一个反直觉点:窗口不是越大越好,过了甜点吞吐反而会掉。原因是大 batch 的前向耗时近似线性增长,batch 128 的耗时不一定比 batch 64 的两批串行快多少,但排队延迟实打实翻倍。真正的吞吐天花板由「GPU 被打满的那个 batch 尺寸」决定,继续往上堆只是延迟换不存在的吞吐。
找这个甜点的实操方法是扫参压测:固定到达率,把 max_batch_size 从 8 开始翻倍扫,画「吞吐-延迟」曲线,吞吐曲线由陡转平的拐点就是目标批大小。这个拐点随模型尺寸和卡型漂移——BGE-small 在 A10 上拐点约 128,BGE-large 约 64,换卡换模型都要重扫,不要抄别人的配置直接上线。扫描时顺手记录每个点的 SM 利用率,利用率不再随批变大而上升的那个点,就是硬件意义上的「喂满了」。
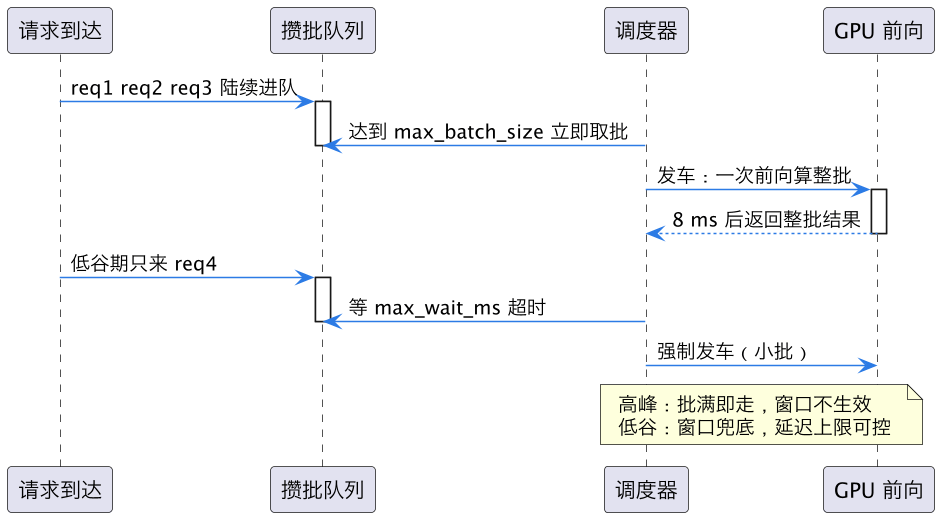
这张图把动态 batching 的两条发车路径画清楚了:高峰靠「批满触发」,等待窗口完全不参与;低谷靠「超时触发」,窗口决定延迟上限。调参时先压测出高峰期的到达率,确认它足以撑满目标 batch,再把窗口拧到延迟预算允许的最大值——顺序反了(先定窗口再看能不能攒满)是新手最常见的错误。
三、序列长度分桶:消灭 padding 这个隐形的算力税
动态 batching 解决「批不够大」,但批大了之后第二个浪费浮出来:padding。一个 batch 内所有序列必须补齐到同一长度才能做矩阵运算,如果批里混着 32 token 的短句和 500 token 的长文档,短句要被 pad 到 500——注意力计算量随长度平方增长,这一 pad,有效算力可能一半以上在算零。
算笔账:假设请求长度均匀分布在 32~512,直接随机拼批、padding 到批内最长,平均计算量约为「全部按 512 算」的水平,浪费率可达 60% 以上。而真实检索流量里短查询占大头(平均查询 10~20 token),浪费更夸张。
对策是序列长度分桶(length bucketing):请求按长度进不同队列(比如 0-64、65-128、129-256、257-512 四桶),同一桶内攒批,padding 只补到桶上限。短句桶批大(短序列单条显存占用小),长文桶批小,各自设独立的 max_batch_size。TEI 和 Triton 的 dynamic batcher 都内置了按长度排序组批的选项,开启即可。
分桶的代价是桶数多了每桶攒满变慢,低谷期可能出现「每桶都差一点、谁也发不了车」的死等。解法是跨桶兜底合并:超时前若本桶不够,允许从相邻更短的桶借请求补进来(短的 pad 到长桶长度,浪费有限),但绝不从更长桶往下借。另一个工程细节:embedding 模型大多带位置编码上限 512,超过要截断,截断策略(头部截断还是尾部截断)要在服务层统一,否则向量质量悄悄劣化。

上图的分桶结构里有两个数字值得记:桶数 4~6 个通常是甜点(再细攒批困难,再粗浪费回升),分桶后 padding 浪费一般能从 50%~60% 压到 10% 以内,等效于吞吐直接翻近一倍——这是 Embedding 服务里性价比最高的一项优化,没有之一。
分桶边界怎么定也有讲究:不要拍脑袋均分,先对线上请求长度做直方图统计,按「桶内长度方差最小」的原则切分。典型检索流量的直方图是双峰——短查询堆在 32 token 以内,文档块堆在 256~512——这时「16、128、384、512」的不均匀边界比「64、128、256、512」的等比边界更省。如果框架不支持自定义边界,退而求其次的做法是开「按批内最长长度动态 padding」而不是「pad 到模型上限」,这一步很多部署默认就没开,白白多算一大截。
Rerank 塔的分桶更有讲究:它的序列是「查询+文档」拼接,长度方差主要来自文档侧。如果上游做了文档切块(chunking),候选块长度被归一化到相近区间,分桶收益会打折但仍值得开;若候选是原始长文档,分桶就是刚需。
四、双塔资源切分与优先级调度
回到第一节的双塔图:同一个 GPU(或同一组 GPU)要同时伺候 Embedding 塔和 Rerank 塔,两者负载形状不同、SLO 也不同,资源怎么切?
先定 SLO。在线检索链路里,Embedding 塔的延迟直接加在查询关键路径上(P99 通常卡 20~50 ms),Rerank 塔虽然也关键但靠扇出天然攒出大 batch,单批稍久可接受(P99 100~200 ms)。离线侧还有一个隐形客户:文档入库时的批量 embedding,量大、不紧急、随时可让路。
推荐的分层策略:
- 在线 Embedding 请求:最高优先级,小等待窗口(1~2 ms),宁可小批也要快。
- 在线 Rerank 请求:中优先级,等待窗口可以放大到 10~30 ms 换批满,因为扇出结构让它很容易攒满。
- 离线批量 Embedding:最低优先级,只在 GPU 空闲时填充,用极大的 batch 跑满吞吐;在线流量一来立刻让位。
实现上有两条路。多模型实例路:一张卡上起多个模型实例(Triton 的 instance group),Embedding 实例和 Rerank 实例各自配并发度,调度器在实例间抢占。单实例多队列路:一个实例内部按优先级排多个队列,空转时从低优先级队列取活。前者隔离好、配置直观,后者资源利用率高,流量波动大的场景选后者。

这套结构的精髓在 P2 层:离线批量不是负担,是把 GPU 利用率从「在线流量平均值」顶到「接近 100%」的填充物。很多团队的离线入库单独占卡跑,等于把在线卡的低谷期白白扔掉;合并调度后,一张卡同时扛在线 SLO 和离线吞吐,总拥有成本直接减半。调度细节与 inference runtime 的调度框架 里的优先级队列设计同源。
五、把利用率顶上去:并发、精度与观测闭环
攒批和分桶做完,利用率通常能到 50%~60%,剩下的水位靠三件套。
并发执行:单 batch 前向里仍有 CPU 调度、H2D 拷贝的空隙。用 CUDA stream 优先级推理 的手法开 2~4 条流,让相邻批次的发射与计算交叠;Triton 里对应 instance count 调大。Embedding 模型层数少(12~24 层),单批 kernel 序列短,并发收益比 LLM 场景更明显。
精度降级:FP16 是底线,INT8 量化(见 INT8/INT4 量化校准)对 embedding 类模型通常掉点很小(检索指标 MRR 掉 0.1~0.3 个点),吞吐再涨 40%~80%。Rerank 的 cross-encoder 对量化稍敏感,建议先 FP16 守住精度基线,评估后再上 INT8。注意 embedding 向量若要做归一化,量化误差不影响排序(单调性保住),这是它敢量化的底气。
观测闭环:调优没有观测就是盲调。至少盯四个指标——平均批大小(反映攒批效率)、padding 比率(反映分桶效率)、SM 利用率(反映 GPU 是否喂满)、P99 排队延迟(反映 SLO 余量)。前两个决定「理论吞吐达成了几成」,后两个决定「还能不能再压」。完整的指标栈可参考 LLM 推理可观测性体系,把其中的 token 级指标换成请求级即可。
| 调优项 | 典型收益 | 主要代价 |
|---|---|---|
| 动态 batching | 吞吐 3~8 倍 | 增加数毫秒排队延迟 |
| 长度分桶 | 吞吐近 2 倍 | 低谷期攒批变慢,需跨桶兜底 |
| 多流并发 | 利用率 +10%~20% | 显存占用上升 |
| INT8 量化 | 吞吐 1.4~1.8 倍 | 轻微精度损失,需校准 |
| 离线填充调度 | 总利用率逼近 100% | 离线任务延迟不可控 |
全部做完后的合理预期:在线 Embedding 服务在 A10/A100 级别卡上,SM 利用率稳态 70% 以上、P99 延迟守住 SLO、离线入库搭便车跑满剩余空隙。这个水位对应的单卡 QPS,比「来一个算一个」的裸跑形态高出一个数量级。
总结
Embedding 与 Rerank 推理服务是「无状态、毫秒级、可自由拼批」的 encoder 负载,吞吐优化的主战场不在 kernel 而在调度:动态 batching 用几毫秒等待窗口摊薄固定开销,序列长度分桶把 padding 浪费从六成压到一成以内(单项就近翻倍),双塔按优先级切分资源、让离线批量当 GPU 空闲期的填充物,再叠多流并发与 INT8 量化——一套组合拳下来,GPU 利用率从裸跑的二三成顶到七成以上,单卡吞吐提升一个数量级。