ASIC↔FPGA 原型验证:把百万门 ASIC 搬上 FPGA 不是一键综合(G2)
仿真、emulator、FPGA 原型的能力边界与选型见 仿真/模拟/原型选择,FPGA 侧实践见 多 FPGA 原型、FPGA/ASIC 迁移常识、原型脚本见 fpga/prototyping 系列;本篇讲工具与改造方法:Cadence Protium、S2C、Synopsys HAPS 一类商用原型平台怎么把 ASIC RTL 搬上板、踩哪些 ASIC↔FPGA 差异的坑。
一、先定位:FPGA 原型在验证链里的角色
| 手段 | 速度 | 容量/成本 | 可见性 | 主要用途 |
|---|---|---|---|---|
| 软件仿真(A1) | kHz 级 | 灵活、最便宜 | 全信号可见 | 功能正确性、回归 |
| 硬件仿真 emulator(A6) | MHz 级 | 超大、按租 | 强调试、可波形 | 系统级验证、软开、功耗分析 |
| FPGA 原型 | 数十 MHz(近实速) | 受 FPGA 规模限、买断 | 可见性弱、要预埋 | 近实速跑软件/接口、给客户早期硬件、演示 |
FPGA 原型最接近真实速度,能跑操作系统、真实接口(PCIe/以太网/视频流)和大量软件栈,但调试可见性差(内部信号要预先综合进逻辑分析仪/探针,重新综合很慢)、容量受限于板上 FPGA,且 RTL 要为 FPGA 改造。所以它不替代仿真/emulator,而是验证后期「近实速系统与软件」的一环(见 选择篇、硅后点亮)。
二、多 FPGA 切割(partitioning):最大的工程难点
大 ASIC 单颗 FPGA 装不下,要切到多颗 FPGA。切割质量决定系统能不能跑快:
- 自动切割工具(Protium partition、HAPS)按容量与时序把网表分到多 FPGA,但跨 FPGA 的连线是稀缺资源(板级互连引脚、高速收发器有限),切得不好会产生大量跨片信号;
- 跨片信号经板级走线延迟大,工具要插入同步/流水寄存器(I/O 流水化),引入额外周期,改变时序行为;
- 手工引导(把强耦合模块放同片、沿清晰功能边界切、把宽总线集中走高速 SerDes/时分复用 TDM)往往比纯自动效果好;
- 切割还要平衡各 FPGA 利用率(一片爆满、一片空闲会卡死整体),并避开 FPGA 内部时序最紧的结构。
多 FPGA 间的多路复用(TDM/总线虚拟化):引脚不够时,多条逻辑复用线经物理高速链路分时传输,倍率(TDM ratio)越高、等效频率越低,是容量与速度的核心权衡(多 FPGA 原型 展开)。
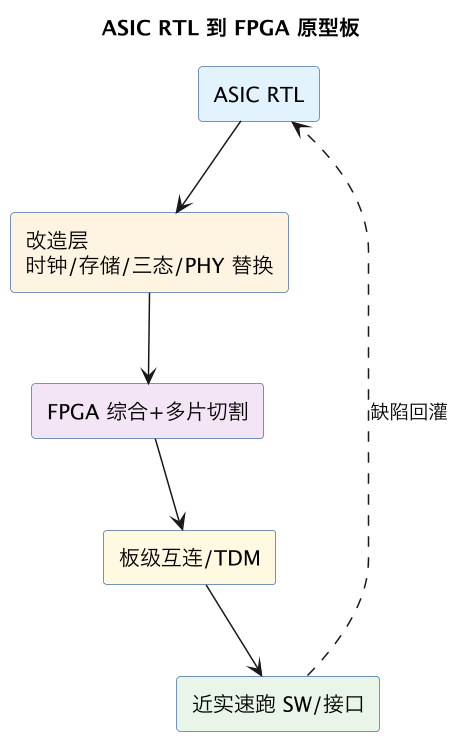
三、ASIC RTL 上 FPGA 必须做的替换/改造
FPGA 与 ASIC 标准单元/结构不同,直接综合常失败或行为不符。常见改造(用编译开关 + 独立 wrapper,不污染 ASIC RTL):
| ASIC 结构 | FPGA 处理 |
|---|---|
| 定制 SRAM/宏(memory compiler 生成) | 换成 FPGA 块 RAM/URAM,写行为模型并保持端口/时序近似;注意单端口/双端口/字节使能差异(存储推断) |
| 时钟门控 ICG cell | 换成 FPGA 时钟使能(CE)或 BUFGCE;不要用 LUT 拼门控,会产生毛刺时钟 |
| 内部生成/分频/PLL 时钟 | 用 FPGA MMCM/PLL/时钟缓冲替换,统一到全局时钟网络;分频使能用 CE 而非门控 |
三态总线/inout 内部信号 | FPGA 内部不支持片内三态,改成 mux 选择;仅板级管脚保留三态 |
| 锁存器、组合环、特殊时序 | 显式改成触发器/打破环(很多 ASIC 合法的低功耗写法 FPGA 时序过不了) |
| PHY/SerDes/模拟/IO 宏 | 换成 FPGA 收发器 IP 或功能等价 stub/环路模型 |
| 工艺延迟/反标 SDF | FPGA 时序由其布局布线决定,不反标 ASIC SDF;功能验证为主,时序数字不能外推 ASIC |
铁律:所有改造放在 ifdef FPGA 的独立文件/wrapper 里,黄金 ASIC RTL 一行不改,否则原型验证的就不是要流片的东西。改造模型与 ASIC 宏要在仿真里先对功能等价(LEC 思路)。
四、时钟与时序:原型的速度是「工程跑通的频率」,不是 ASIC 指标
- FPGA 综合后时序收敛方法与 ASIC 不同,靠约束(xdc/sdc)、流水线、CE、物理约束(FPGA 收敛法);
- 跨 FPGA 的 I/O 流水化会增加周期,依赖严格周期数的逻辑(固定延迟 FIFO、特定握手、校准状态机)可能行为变化,要确认设计对插入流水不敏感(ready/valid 友好的设计天然抗插入,见 valid-ready);
- 原型能跑到 20–50MHz 已可接受,目的是近实速跑软件,绝不能把 FPGA 上的频率/时序/功耗数字拿去推断 ASIC——工艺、单元、互连完全不同。
五、上板与调试
- 流程:改造 RTL → FPGA 综合(Vivado/Quartus 或平台自带)→ 实现/布局布线 → 比特流 → 下载;多 FPGA 还要生成各片比特流与板级连接约束;
- 调试手段受限:预埋 ILA/SignalTap 逻辑分析探针(要重新综合,成本高,尽量一次把关键总线/状态机都埋上)、预留 JTAG/UART/虚拟仪表(virtualizer)、用 transactor 把主机事务接到 DUT 引脚;
- CI 化:原型比特流构建也可进 G5 回归 做「每天能成功出 bit、能下载自检测试」的健康检查(参考 FPGA CI/CD)。
六、原型发现的问题怎么回灌
原型近实速暴露的多是系统级/软件交互/真实带宽问题(性能验证见 性能验证):死锁、带宽不达预期、DMA/缓存一致性、长序列才出现的 corner。闭环要求:
- 板级现象 → 用预埋探针/缩小到仿真/emulator 复现(调试方法 与 A3 Verdi);
- 定位到 RTL(区分真 bug vs FPGA 改造引入的差异——所以改造层要最小、可审计);
- 修 RTL 进主线、过仿真回归 + LEC,再重新出比特流;
- 原型环境(testbench、软件、接口模型)与 ASIC 验证环境复用同一套 UVM/事务模型,避免两套真相(A2、A6 emulator)。
相关与延伸
- 三选与相邻硬件:仿真/emulator/原型选择、A6 硬件仿真器、A1 仿真器。
- FPGA 侧:多 FPGA 原型、时序收敛、FPGA CI/CD。
- 改造等价与回灌:B4 LEC、G5 ASIC CI/CD、硅后点亮。
总结
FPGA 原型在验证链里靠近实速跑软件和真实接口补仿真/emulator 的位,但把百万门 ASIC 搬上板绝不是一键综合:最大工程是多 FPGA 切割,跨片引脚稀缺、板级走线要插 I/O 流水和用 TDM 时分复用换容量,切不好速度塌方,通常要沿功能边界手工引导强耦合模块同片;同时所有 ASIC 专属结构都得隔离改造——宏 SRAM 换块 RAM、ICG 换时钟使能、内部分频/PLL 换 MMCM、片内三态改 mux、PHY 模拟换收发器或 stub,且这些替换必须全放在 ifdef 的独立 wrapper 里、黄金 RTL 一行不改并先在仿真验证功能等价;跨片插流水对严格周期逻辑有影响,原型频率只代表能否跑通软件、绝不能外推 ASIC 时序功耗,调试靠预埋 ILA 和虚拟仪表、重新综合很贵所以探针一次埋全;最终近实速暴露的死锁、带宽和一致性问题要能缩回仿真复现、分清是真 bug 还是改造差异,修主线 RTL 过回归与 LEC 后再重出比特流,且原型与 ASIC 验证复用同一套事务模型——原型验证的始终是那块将要流片的 ASIC,而不是一个为 FPGA 改过的近似物。