multibit 寄存器合并:multi-bit cell banking 的功耗面积收益、摆放约束与解合并时机
更新时间:2026-10-03。在功耗优化的工具箱里,时钟门控(clock gating)拿走了大部分注意力,但还有一招更「物理」的手段常常被低估:multibit 寄存器合并(multi-bit cell banking)。它不改功能、不改使能逻辑,只是把相邻的多个单比特触发器(flip-flop)换成一个内部共享时钟通路的 2/4/8 比特 multi-bit cell,就能在时钟树上省下一截实打实的动态功耗。本站 时钟门控功耗效率 讲的是「让时钟别翻」的门控主线,这一篇讲的是另一条线——「时钟照样翻,但每次翻得更便宜」。流程坐标见 数据流 S3:floorplan 与布局阶段。
本文要回答的问题
- multi-bit cell 到底共享了什么,功耗和面积收益从哪来?
- banking 在实现流程的哪个阶段做,输入输出是什么?
- 物理侧摆放(placement)上 multi-bit cell 带来哪些约束和坑?
- 什么时候必须解合并(de-banking),判断标准是什么?
- 评估 banking 质量该看哪些指标?
一、收益从哪来:共享时钟反相器
一个单比特 D 触发器内部,时钟通路通常有两到三级反相器做缓冲和主从锁存驱动,这部分晶体管在每次时钟翻转时都充放电,是触发器自身功耗的大头——典型单元里时钟引脚功耗能占整个触发器动态功耗的一半以上。multi-bit cell 的做法是:把 N 个比特装进一个 cell,内部只留一套共享的时钟反相器链,再分发给 N 个主从锁存对。N=4 时,时钟驱动开销从 4 份变成 1 份多一点,单比特等效时钟功耗通常降 40%-60%。
收益不止 cell 内部。合并之后,时钟树上的 sink 点(叶子负载)数量直接除以 N,时钟树综合(CTS)要驱动的端口变少,树可以更短、buffer 更少——这是第二份节省,而且省的是整条树上最耗电的那部分。面积上,共享时钟通路加共享阱接触(well tap 结构合并),4-bit cell 的面积通常只有 4 个单比特触发器的 70%-85%,顺带把布局密度压力也松了一点。
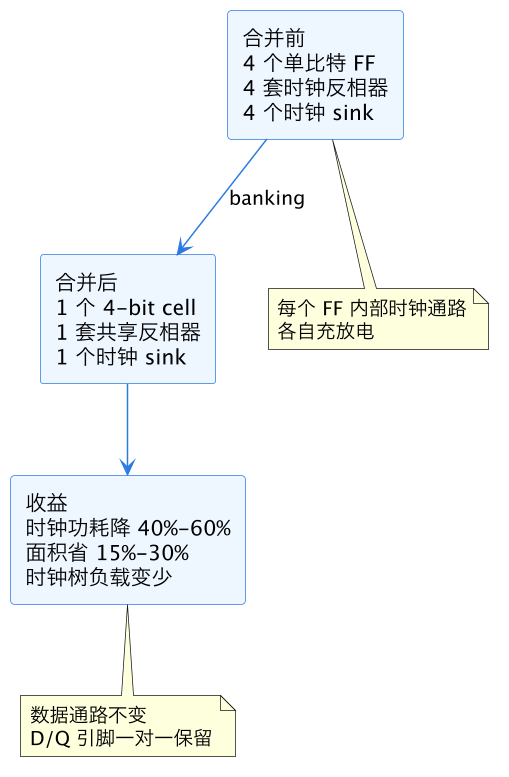
读这张图要抓住一点:banking 动的是时钟通路,数据通路(D 到 Q 的组合逻辑邻接)一根线都没改,所以它不改变功能、不影响验证等价性检查——这是它和门控优化最大的区别,也是它敢在流程中后段做的底气。
二、在流程里的位置与合并资格
banking 一般做两次:综合阶段做一次「逻辑合并」,工具根据网表里触发器的连接关系把明显同组的比特(同一总线、同时钟、同复位、同使能)先合掉;布局之后再做一次「物理合并」,按实际物理邻接关系把剩下的可合对象再捞一遍。有些流程还在 CTS 之前留一次调整窗口。合并资格是硬条件:必须是同一个时钟域、同一个门控使能(或都没有)、同一种 set/reset 结构、同一个电压域,扫描链上还要注意 scan 连接的串接顺序能否重排。这些条件由 Liberty 里的 multi-bit 组定义和工具的 banking 规则共同约束。
| 合并资格项 | 要求 | 不满足时的处理 |
|---|---|---|
| 时钟与门控 | 同一时钟叶、同一 ICG 下游 | 不合,保持单比特 |
| 异步复位/置位 | 结构与极性一致 | 不合 |
| 电压域 | 同一 power domain | 不合(跨域要 level shifter,见 UPF supply net 与电源域) |
| 扫描链 | 可重排或链内相邻 | 调整 scan 序后再合 |
| 物理邻接 | 布局后距离够近 | 物理合并阶段跳过 |
三、物理侧摆放约束
multi-bit cell 是把「一个逻辑决定」变成「一个物理绑定」:4 个比特从此必须放在同一个 cell 的位置里,它们的 D 端扇入逻辑、Q 端扇出负载都要汇聚到同一个坐标。这带来三类约束。
第一类是布线汇聚压力。原来 4 个触发器可以散开放在各自数据通路最顺的位置,合并后 4 条数据通路都要「拐弯」到这个 cell,input/output pin 周围的局部布线密度上升,pin access 变差,在先进工艺 M1/M2 资源紧张的区域容易制造局部拥塞,与 pin access 与可布线性设计 讲的问题同源。第二类是时序挪移:合并后每个比特的位置是折衷解,不再是各自的最优解,原本贴着逻辑云摆放的触发器可能被拉开几十微米,input delay 和 output delay 一增一减,对紧张路径是实打实的挪移。第三类是密度与 legalize:multi-bit cell 本体宽高比和单比特不同,且内部行高占用更满,placement legalization(见 布局合法化与详细布局)阶段挪动它的代价更高,它也更难被塞进零星空隙。
所以现代流程的做法是:时序驱动的 banking——合并决策直接吃时序裕量信息,只合并那些「挪了位置也无所谓」的寄存器,把 banking 率(mergeable ratio)压在关键路径稀疏的区域高、关键路径密集的区域低。这也是为什么物理合并阶段比综合阶段更值钱:只有布局后才知道谁和谁真的挨着。
四、何时解合并(de-banking)
解合并就是把已经合上的 multi-bit cell 拆回单比特触发器。典型触发时机有三个。一是时序修复:某条 setup 关键路径的起点或终点恰好在一个 multi-bit cell 里,而 cell 的位置对这个比特不利,拆出来单独挪位就能收敛——这是 CTS 后和布线后 ECO(见 PR 时序收敛 ECO)里的常规手术。二是布线拥塞:cell 所在区域 pin density 爆表,detailed route 修不动,把 cell 拆开让比特各奔东西,等于把汇聚的布线压力重新摊开。三是 SI 与串扰:汇聚走线让某几个比特的 Q 输出长距离平行,串扰增量延迟超标(背景见 STA 串扰 SI 增量延迟),拆开后重新分配走线资源。
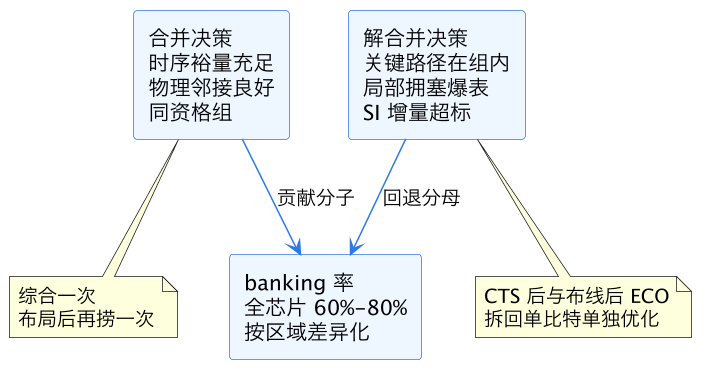
这张图表达的核心是:banking 不是一次性决定,而是一个贯穿实现流程的双向调节阀。好的流程敢于在中后段拆,差的流程把 banking 率当成一次性 KPI 冲上去就不敢动,最后在时序收敛上还债。
五、质量评估看什么
banking 做完看四个数。一是全芯片 banking 率:等效比特数中被合并的比例,主流设计 60%-80% 算健康,过低说明资格规则或邻接条件没喂够,过高要警惕关键路径被误伤。二是时钟功耗对比:合并前后时钟网络动态功耗(含 cell 内时钟引脚功耗加时钟树功耗),理想情况整体动态功耗降 5%-10%,其中时钟域贡献降 15%-25%。三是时序恶化清单:合并前后 WNS/TNS 的差值,凡是恶化的路径逐条确认是否由 banking 挪位引起,必要时定向 de-banking。四是局部拥塞热点:multi-bit cell 密集区域的 pin density 与绕线率,和 布局拥塞与 cell padding 的评估方法一致。功耗侧的数字最终要和 SAIF 翻转率功耗精度 讲的活动率数据对齐,否则评估本身就不准。
这一篇在知识体系里的位置
本篇属 eda/ 目录低功耗物理实现支线,与 时钟门控功耗效率 的「门控主线」互补:一个少翻时钟,一个让每次翻转更便宜,两者在同一颗芯片上叠加使用。向上接 数据流 S3:floorplan 与布局阶段 的流程坐标,横向关联 布局合法化与详细布局、pin access 与可布线性设计 的物理约束,向下接 PR 时序收敛 ECO 的修复回路与 功耗签核 Voltus/RedHawk 的最终算账。
总结
multibit 寄存器合并通过让多个触发器共享一套时钟反相器,同时砍下 cell 内时钟功耗、时钟树负载和面积,是一项不改功能、只在物理层做文章的优化;它的代价是把多个比特绑定到同一坐标,带来布线汇聚、时序挪移和 legalize 刚性三类约束,所以正确姿势是时序驱动地合并、按区域差异化控制 banking 率,并在 CTS 后与布线后 ECO 阶段对关键路径、拥塞热点和 SI 超标对象果断解合并,用 banking 率、时钟功耗降幅、时序差值和局部拥塞四个指标闭环验收。