MFU 指标口径:理论峰值选择、bubble 与通信归属、跨框架对比的有效性陷阱
更新时间:2026-10-06。MFU(Model FLOPs Utilization,模型算力利用率)是衡量 GPU 集群效率最常被引用的指标:它回答「硬件的理论算力,有多少真正花在了模型的有效计算上」。大模型训练报告里动辄引用「MFU 55%」这类数字,推理侧也越来越多用它评估服务效率。问题是这个数字的分子分母都有多种合法口径,口径差一档,结果差一倍——两个团队各自报出诚实测量的 MFU,直接对比却可能毫无意义。站内 batch 与延迟吞吐曲线 从吞吐视角讨论了效率,这篇专注把 MFU 这个指标本身的口径陷阱拆清楚,给一套可复现的计算与对比规范。
本文要回答的问题
- MFU 的标准公式是什么,分子「模型 FLOPs」到底包含哪些计算?
- 分母「理论峰值」该选哪一档——稠密还是稀疏、FP16 还是 FP8、boost 还是持续频率?
- pipeline bubble、通信、重计算这些非理想开销应该算进分子还是留在分母里?
- 跨框架、跨论文的 MFU 数字什么时候可比,什么时候必须重算?
一、标准公式与分子的边界
先把公式和它的设计意图摆清楚——MFU 想衡量的是实现质量,不是负载形态,这个意图决定了后面每一条口径规范的方向。MFU 的经典定义(PaLM 论文推广开来):
MFU = 模型每步实际执行的有效 FLOPs /(理论峰值 FLOPS × 实际耗时)
分子「模型 FLOPs」的计算有个关键约定:只数模型前向加反向的数学必要计算,用模型结构公式推出,不用硬件计数器实测。transformer 的常用近似是每 token 每步 6N FLOPs(N 为参数量:前向 2N,反向 4N),注意力部分另加 12 × 层数 × 序列长度 × hidden 这类结构项。用公式而不用计数器的原因是分子必须反映「这个模型理论上需要多少计算」,与实际实现的冗余无关——实现里多算的(比如低效的重复归一化)不该给 MFU 加分。
分子的三个边界争议,每一个都能让数字差出几十个点的档次。重计算(activation recomputation)算不算:开了选择性重计算后,反向时要重放一部分前向,实际执行的 FLOPs 多了 30% 上下——按「数学必要」口径这部分不算分子(MFU 变低,诚实),按「实际执行」口径算分子(MFU 虚高)。PaLM 口径是不算,这也是主流。注意力 FLOPs 算多细:短序列时注意力占比小,粗算无伤;32k 以上长序列注意力能占两成,省略它分子系统性偏小——混合长度负载下建议按平均序列长度加权后统一声明,不要让序列长度成为口径里的自由变量。MoE 的激活参数:MoE 每 token 只激活部分专家,分子该用激活参数量还是总参数量——用总参数量会把 MFU 严重高估,正确做法是用每 token 实际激活的参数量(含共享专家),MoE 服务的效率评估见 MoE 服务化专家并行。三个争议的共同特征是它们都「合法」——每种算法都有论文这么干过,这正是 MFU 数字必须带口径脚注的原因。

上图把分子的构成和两个争议点画在一起。底部注释是分子的第一原则:MFU 衡量的是「实现质量」,所以分子必须只含数学必要项——把实现冗余算进分子,等于让低效的实现给自己发奖状。
先用一张概念卡把「MFU = 实测吞吐 ÷ 理论峰值」这个除法的口径结构立起来,后面的示例和陷阱都挂在它的三个分区上。读法是从左到右看一次完整的口径声明:分子分区回答「有效计算数什么、不数什么」,分母分区回答「峰值选哪档、耗时怎么量」,解读分区回答「结果落在哪个区间才可信」。任何一份 MFU 报告,只要能把这张卡每个分区里的条目逐条填上自己的取值,口径就是完整的;填不上的条目,就是审查时要追问的地方。
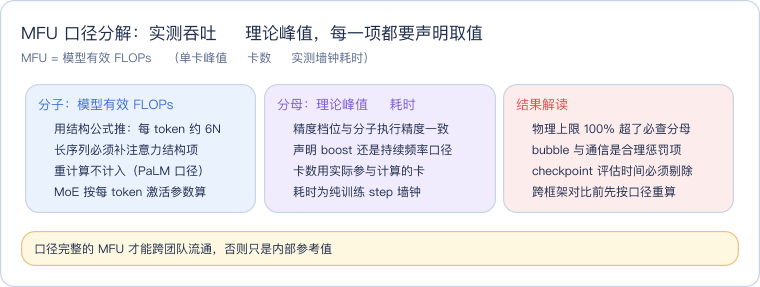
给一个完整的计算示例把公式落到实处。70B 稠密模型、序列长度 4096、全局 batch 400 万 token、128 张 H100(BF16 稠密峰值按 989 TFLOPS 计)、一个 step 墙钟 12 秒。分子:6 × 70e9 × 4e6 ≈ 1.68e18 FLOPs,注意力项按结构公式补约 5%,合计约 1.76e18。分母:128 × 989e12 × 12 ≈ 1.52e18——这个例子里算出来 MFU 超过 100%,显然是口径错了:检查发现是峰值按稀疏档算了,改回稠密档分母翻倍,MFU 落回 58% 的合理区间。这个编造痕迹明显的「超百 MFU」正是口径审查的第一信号:物理上不可能超过 100%,看到就回去查分母。
二、分母的陷阱:理论峰值选哪一档
分母 = 卡数 × 单卡理论峰值 FLOPS × 实际耗时。看起来最没争议的部分,实际是 MFU 数字注水的高发区。
精度档位。H100 的标称峰值:FP16/BF16 稠密约 989 TFLOPS,FP8 约 1979 TFLOPS,稀疏再翻倍。同一个训练任务,分母选 BF16 稠密峰值还是 FP8 峰值,MFU 差整整一倍。规范的做法是分母的精度档位要和分子实际执行的精度一致——混合精度训练(大部分 GEMM 是 BF16)就用 BF16 峰值,用 FP8 GEMM 的部分理论上该按时间加权拆算,混合精度的典型配比见 混合精度 FP16 BF16 FP8。直接拿 FP8 峰值给 BF16 训练当分母是最常见的低级注水。
boost 频率还是持续频率。数据手册的峰值按最高 boost 频率算,实际集群在功耗墙、散热约束下长期运行频率低 5% 到 15%。用标称峰值当分母,MFU 天然被打九五折——这本身不算错(大家都这么干,口径一致即可),但跨硬件平台对比时要小心:液冷 NVL72 的持续频率接近标称,风冷 8 卡机的折损大得多,同口径下前者 MFU 天然高几个点,这是平台的物理差异不是实现水平差异,平台背景见 B200 与 GB200 服务化架构。
卡数口径。分母的卡数是「分配到的卡」还是「实际参与计算的卡」?有节点故障降级、有 straggler 被跳过、有流水线末级空转时,两个口径差出可见的百分点。规范是用「参与该步计算的全部卡 × 该步墙钟时间」,即把空转时间留给分子分母的比值去惩罚——这正是 MFU 的设计意图:空转和等待就该拉低它。
三个陷阱之外还有一个跨代际的隐性问题:不同代 GPU 的「可实现峰值比例」不同。同一套内核在 A100 上能跑到峰值的七成,在 H100 上可能只有五成——不是实现退化了,是 H100 的峰值涨得比显存带宽快,roofline 的拐点右移,更多 kernel 落进了带宽受限区。跨代际比 MFU 时,合理的预期是新一代卡 MFU 略降但绝对吞吐大涨;要求 MFU 不降等于要求所有 kernel 同步重构,这是硬件换代期的典型管理误判。

上图把分母的三个陷阱和收敛规则画在一起。记住一个快速验尸方法:看到一个 MFU 数字,先问「峰值用的哪档精度、哪个频率」——答不上来的数字默认不可比。
三、时间项的归属:bubble、通信与断点的账
分子分母都定好之后,剩下的争议全在「耗时」这一项的归属上。MFU 分母里的「实际耗时」是墙钟时间,这意味着所有不产出有效 FLOPs 的时间都自动成为惩罚项。但「应不应该被惩罚」在解读时要做归属分析,否则优化方向会搞错。
pipeline bubble:流水线并行的填充和排空阶段部分设备空转,bubble 占比 ≈ (PP 度数 − 1) / 微批数。这部分时间拉低 MFU 是合理的——它反映并行策略的效率损失,优化方向是调度(交错调度、更小微批),见 流水线并行气泡调度。
通信时间:TP allreduce、PP 激活传输、DP 梯度同步都占墙钟。TP 通信在 NVLink 域内时占比小,跨节点或 EP all-to-all 时能吃掉 20% 到 40% 的 step 时间——这部分拉低 MFU 同样是设计意图,优化方向是拓扑与重叠,见 张量并行通信重叠 和 张量并行通信域。要注意通信占比本身随模型规模非线性增长:千卡以下 DP 同步通常几个点,万卡级训练里梯度同步加各类重传能占到两位数,所以「别人的 MFU 高」先要问「别人的集群多大」——规模本身就是 MFU 的减项,小规模跑出的高 MFU 不能直接外推为大规模方案的效率承诺。
不该惩罚的部分:checkpoint 写入、数据加载饥饿、验证集评估、故障断点续训。这些时间和「模型计算效率」无关,但只要在测量窗口里就拉低 MFU。规范做法是测量窗口只含纯训练 step,checkpoint 和评估时间从耗时里剔除(或单独报「含运维开销的集群利用率」作为另一个指标)。把这两个指标混着报是训练报告里最常见的口径含糊。

上图是时间账的三分法。中间那档(合理惩罚项)占比过高时,MFU 低是好事——它忠实地把优化空间暴露出来了;右边那档没剔干净时,MFU 低是测量事故——优化错了方向,去调内核结果发现时间全花在 checkpoint 上,是真实发生过的浪费。
四、跨框架对比的有效性:什么时候必须重算
把以上三节合起来,跨团队 MFU 对比的合法性条件可以压成一张 checklist:分子用同一套结构公式(含不含注意力项、MoE 用激活参数)、重计算口径一致、分母同精度档位同频率口径、测量窗口同样剔除运维开销。四项全对齐,数字可直接比;任何一项未知,对比前必须按对方披露的配置重算——主流框架(Megatron-LM、DeepSpeed)都内置 MFU 统计且口径略有差异,直接拿两个框架的日志数字互比,误差 10 个点起步。checklist 落成表格方便评审时逐项核对:
| 核对项 | 一致的要求 | 常见分歧 | 不一致的后果 |
|---|---|---|---|
| 分子结构公式 | 同一套公式 声明注意力项 | 长序列下省不省注意力项 | 分子差一到两成 |
| 重计算口径 | PaLM 口径 不计入分子 | 一方按实际执行计入 | MFU 虚高约三成 |
| 分母精度与频率 | 与分子执行精度一致 声明频率 | BF16 训练用 FP8 峰值 | MFU 差整一倍 |
| 测量窗口 | 剔除 checkpoint 与评估 | 一方含运维开销 | 差 5 到 15 个点 |
推理侧用 MFU 还要额外一层修正。decode 阶段是带宽受限,MFU 天然极低(batch 1 时常常不到 5%),此时 MFU 不是好的效率指标——它把「负载形态决定的物理上限」和「实现质量」混在一起。推理侧更有意义的口径是相对 roofline 的达成率:按当前 batch 和序列长度算出带宽-算力边界上的可达 FLOPS,再看实测达成几成。同样的思路在 prefill 侧才勉强可以直接用 MFU,因为 prefill 接近计算受限。推理效率的整体评估框架见 LLM 服务 TTFT 与 TPOT SLO 和 LLM 服务成本模型 TCO,内核层面的达成率分析见 注意力内核优化全景。
推理侧还有一个和训练侧相反的口径偏好值得记住:训练 MFU 追求「越高越好」,推理服务追求「成本目标下的够用」——盲目把 decode 的等效 MFU 推高(比如无脑放大 batch)会同时推高 ITL 和显存占用,SLO 反而恶化。推理效率的北极星指标是「SLO 约束下的单 token 成本」,MFU 类指标只是诊断手段,这个主次关系在容量评审时容易被技术指标的光环颠倒。
落地的测量规范收尾全文,一共五条:分子用框架的结构公式并显式声明重计算与 MoE 口径;分母声明精度档位与频率口径;测量窗口剔除 checkpoint 与评估;同时报 MFU 和含运维开销的集群利用率两个数字;跨框架对比前按 checklist 重算。五条都做到,MFU 才是能跨团队流通的硬通货;少任何一条,它只是一个内部参考值。
测量本身的埋点也有讲究。MFU 不该只报一个全周期平均值——按 step 粒度记录,画时间序列,才能区分三类不同的低效模式:持续低位(实现或并行策略问题,去查 bubble 和通信占比)、周期性下凹(checkpoint 或评估没剔干净,或数据加载周期性饥饿)、渐进衰减(热降频、显存碎片化或 straggler 节点劣化)。三种模式的处方完全不同,平均值会把它们揉成同一个数字。配套的分解指标建议至少留两个:通信时间占比(NCCL 计时)和 bubble 占比(流水线调度日志),它们是 MFU 下降时最先要看的两个嫌疑人。
这一篇在知识体系里的位置
本篇是效率度量专题的口径篇:吞吐侧的效率曲线在 batch 与延迟吞吐曲线,bubble 与通信这两个最大惩罚项的优化分别在 流水线并行气泡调度 和 张量并行通信重叠,推理侧替代指标在 LLM 服务 TTFT 与 TPOT SLO,成本换算在 LLM 服务成本模型 TCO。
总结
MFU 的公式只是「有效 FLOPs 除以理论峰值乘耗时」,但每一项都有口径陷阱:分子要用结构公式只数数学必要计算,重计算不算、MoE 用激活参数、长序列不能省注意力项;分母的精度档位必须与分子实际执行精度一致(BF16 训练配 FP8 峰值是最常见的注水手法),频率与卡数口径要声明;时间项里 bubble、通信、重计算是合理惩罚项,checkpoint 与评估必须剔除并另报集群利用率;跨框架对比前按「分子公式、重计算、分母档位、测量窗口」四项 checklist 重算,推理 decode 侧 MFU 天然失真应改用 roofline 达成率——口径对齐的 MFU 才是硬通货,否则只是内部参考值。