库特征化流程:标准单元 Liberty 从 SPICE 激励生成到 compare_liberty 验证交付的完整链路
本篇是标准单元数据链的上游源头。Liberty 文件里存的 NLDM/CCS 模型精度问题见 NLDM 与 CCS 时序模型,
.lib字段结构与版本基线见 Liberty 库与多视图,单元库从 PDK 长出来的过程见 stdcell 与 PDK 库视图。本篇回答的是更靠前的一个问题:那些查表数据,到底是怎么从晶体管级仿真里"炼"出来的。
本文要回答的问题
- 库特征化的输入是什么,一个反相器要仿真多少次才能出一组 arc 数据?
- SPICE 激励是怎么自动生成的,为什么激励形状直接决定库的质量?
- timing arc、power arc、约束 arc 分别怎么从波形里提取?
- PVT 角点扫描怎么组织,几百个角点 × 上千个单元怎么算得完?
- 交付前怎么验证 .lib 是对的,compare_liberty 和 SPICE 回归各查什么?
一、库特征化是什么:从晶体管到查表数据的一次"压缩"
库特征化(library characterization,也叫库标定)做的事情,本质上是一次有损压缩:标准单元在版图里是一堆晶体管,STA 工具不可能在几十亿门的网表上跑晶体管级仿真,于是特征化流程预先把每个单元在每个 PVT 角点下的行为仿真一遍,把结果浓缩成 .lib 里的查表数据。下游工具查表插值,换来百万倍的速度,代价是模型精度——这个精度天花板,就在特征化这一步被锁死了。
它的输入有四样:
| 输入 | 内容 | 来源 |
|---|---|---|
| 单元 SPICE 网表 | 每个单元的晶体管级 netlist(含寄生) | 版图后 LVS/PEX 提取 |
| 器件模型 | BSIM/FinFET 模型卡,分角点 | foundry PDK |
| 特征化配置 | 索引点(slew/load 网格)、阈值、仿真精度设置 | 特征化团队定义 |
| 单元行为描述 | 真值表/功能定义,决定哪些弧要测 | Liberty 模板或 Verilog 行为模型 |
输出就是各 PVT 角点的 .lib/.db,以及配套的功耗、噪声模型。现代流程里这个活儿由商业工具干:Synopsys 的 SiliconSmart、Cadence 的 Liberate、以及各 foundry 内部的自研流程。但不管用哪个工具,数据流骨架是一样的。值得记住一个量级概念:一套先进节点的完整标准单元库,从零标定到交付往往要消耗数千万核时的仿真算力,周期以月计——这就是 foundry 库更新慢、改版谨慎的根本原因,也是设计公司不敢轻易换库版本的现实约束。
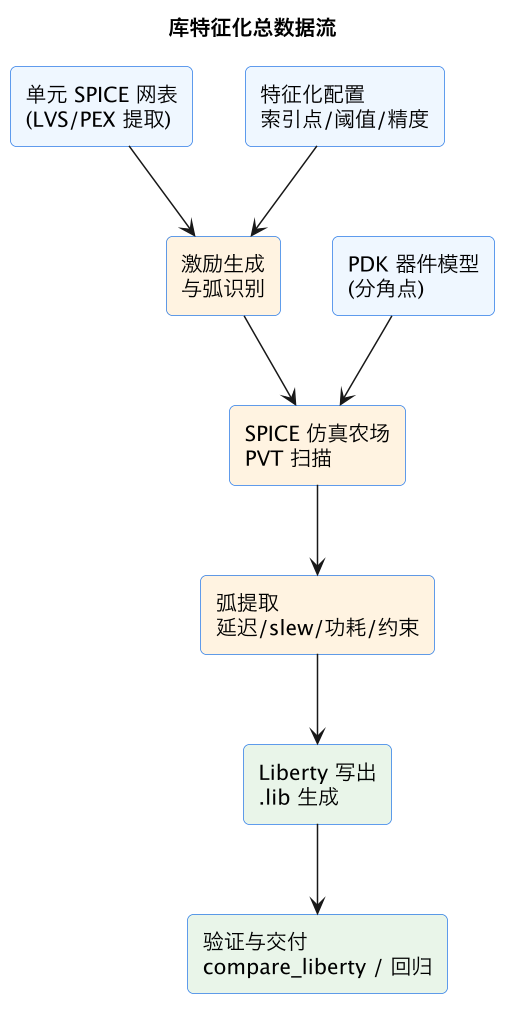
上图是全流程骨架:三份输入先汇入激励生成,仿真农场扫完所有角点后做弧提取,最后写出 .lib 并过验证闸门。下面按这个顺序逐段展开。
二、激励生成:测什么弧、怎么激励,是质量的第一道关
特征化工具拿到单元网表后,第一件事不是仿真,而是弧识别(arc detection):根据单元功能定义,枚举所有需要测量的时序路径。一个二输入与非门有 4 条时序弧(A→Y 上升/下降、B→Y 上升/下降),每个弧还要在非开关输入上施加合适的敏化条件(另一个输入接高电平,让这条路径真能传过去)。D 触发器更复杂:D→Q 的传播弧、CK→Q 弧、setup/hold 约束弧、recovery/removal 弧,加起来十几条。
弧定了之后,为每条弧生成 SPICE 激励。这里的门道比看起来多:
- 输入波形不是理想阶跃,而是受控斜坡。延迟定义为输入过 50% 到输出过 50%,但结果强烈依赖输入 slew,所以要按配置里的索引网格(典型 7×7 或 8×8)逐点施加不同 slew 的输入;
- 负载用可扫描的集总电容。每个(slew, load)组合跑一次瞬态仿真,一个弧就是几十上百次仿真;CCS 库还要在每个网格点上额外记录完整电流波形;
- 内部节点状态要初始化干净。仿真前的 DC 收敛状态如果不一致(比如锁存器初值不同),测出来的延迟会带隐性的状态依赖;
- 约束弧的激励是"逼出来的"。setup/hold 不是量一次波形就有的,要做二分搜索:不断压缩数据与时钟的相对间隔,直到输出延迟恶化超过阈值(典型 10%)或功能失败,这个边界就是约束值。
激励生成的质量直接决定库质量。一个真实踩坑:某团队把索引网格的高端 slew 设得太小,芯片实际运行中长尾路径的输入 slew 超出表范围,STA 被迫外推,延迟低估 8%,硅后频率不达标。教训是索引点必须覆盖设计实际工作区间并留裕量,而不是抄默认模板。
还有一个容易被低估的环节是仿真精度设置。SPICE 的 reltol、时间步长上限、收敛准则直接决定波形过阈点的测量精度。为了压仿真时间把容差放宽一个数量级,省下的机时会在弧提取环节以噪声的形式还回来——同一个网格点重跑两次结果差 2%,下游查表插值就把这个噪声放大成路径级的延迟抖动。特征化团队的通行做法是先用一小批单元做精度扫描实验,找到"再收紧容差结果也不再变化"的那个拐点,把它定为全库标准配置,而不是直接套用仿真器默认值。
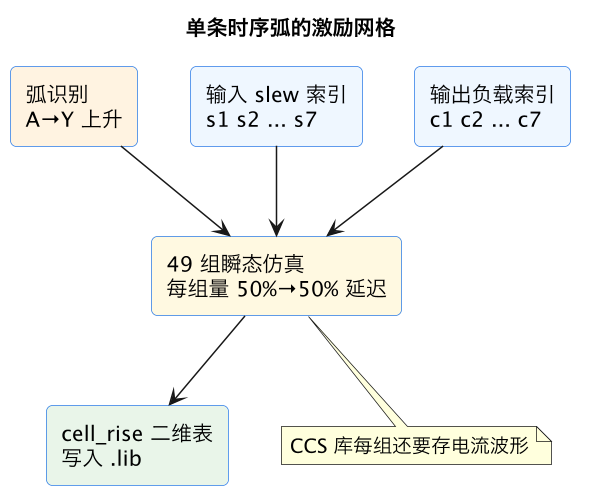
图中是一条弧变成一个网格的过程:7×7 的 slew×load 组合各跑一次瞬态仿真,49 个延迟值填成一张二维表。一个中等规模标准单元库(约 1000 个单元、平均每单元 8 条弧)单角点就要几十万次瞬态仿真——这就是为什么下一节的角点扫描必须上仿真农场。
三、弧提取:从波形到数字的三种量法
仿真跑完得到的是波形,弧提取负责把波形变成 .lib 里的数字。三类弧的量法各不相同。
**传播弧(delay/slew)**最直接:按 input_threshold_pct_rise 等阈值定义(典型 50%)量输入输出过阈时间差得到延迟,量输出 30%→70% 时间得到输出 slew。CCS 则多一步:在输出节点挂电流探针,把充放电电流按时间采样成 output_current_rise/fall 波形组。
**功耗弧(power)**分两块:内部功耗(internal power)通过积分电源电流减去负载充放电能量得到,含短路功耗与内部节点翻转;漏电功耗在静态下量测。动态电流波形另有 APL 等专门特征化,见 APL 电流波形特征化。
**约束弧(constraint)**就是上节说的二分搜索产物。setup 和 hold 还有交互效应:hold 时间随 setup 间隔变化,严格的特征化会做二维 setup×hold 扫描取最坏包络,便宜做法只沿默认路径扫——后者在先进节点经常偏乐观,是硅后 hold 违例的常见源头之一。
| 弧类型 | 提取方法 | 写进 .lib 的位置 | 常见坑 |
|---|---|---|---|
| 传播延迟/slew | 阈值过点计时 | cell_rise/fall、rise/fall_transition | 阈值定义与设计工具不一致 |
| CCS 电流 | 输出电流按时间采样 | output_current_* | 采样点过稀导致积分失真 |
| 内部功耗 | 电源电流积分减负载能量 | rise/fall_power | 电源电流含相邻弧串扰 |
| setup/hold | 间隔二分搜索至延迟恶化阈值 | setup/hold 约束表 | 只做一维扫描偏乐观 |
| recovery/removal | 异步清零/置位恢复窗口二分 | recovery/removal | 初值状态污染测量 |
| 最小脉宽 | 时钟脉宽二分至功能失败 | min_pulse_width | 高低两向都要测,容易漏一向 |
四、PVT 角点扫描:组合爆炸怎么治
PVT 是工艺(Process)、电压(Voltage)、温度(Temperature)三个维度的缩写。foundry 模型卡给出 FF/SS/TT 等工艺角,电压按标称 ±10% 取值,温度取 -40°C/25°C/125°C,全组合轻松上百个角点。再乘上多阈值电压变体(LVT/SVT/HVT 单元要分开标定)和不同 track height,一次全库特征化的仿真量以亿次瞬态仿真计。
工程上靠三件事压住成本:
- 并行农场:特征化天然是易并行问题——每个(单元 × 弧 × 网格点 × 角点)互不依赖,LSF/Grid 集群上开几千个 slot 是常态,SiliconSmart/Liberate 都内置了作业分发与失败重跑;
- 角点修剪:不是所有组合都真被签核用。先用 MMMC 分析确定设计真正签的角点子集(典型十几个),其余角点只标小样或干脆不标。角点取舍的方法论见 角点修剪与 MMMC 精简;
- 插值与派生:相邻电压角之间行为平滑,部分流程允许标两个电压角、中间角由工具插值派生(LVF/moments 数据也类似处理),能把角点数再砍一半。
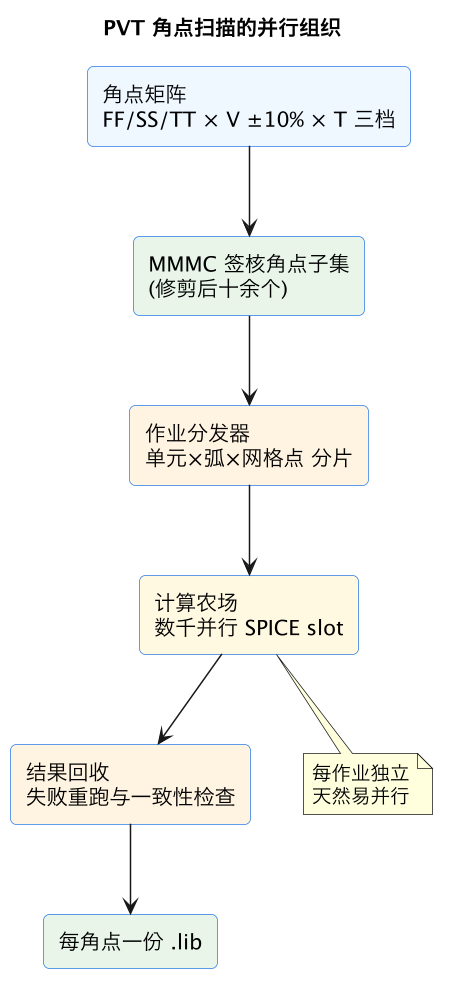
这张图的重点是"先修剪再上农场":角点矩阵先经 MMMC 筛掉用不到的组合,剩下的才拆成作业片扔到农场。直接全组合蛮算,集群队列会排到下周,而且产出的库大部分角点永远不会被 STA 打开。
五、验证与交付:compare_liberty 只是起点
库写出来不等于能用。交付前的验证分四层,漏掉任何一层都有真实事故对应。
第一层:格式与一致性校验。 compare_liberty(Synopsys Library Compiler 自带)对比两个库的逻辑/参数差异,常用于新旧版本 diff、.lib 与 .db 互转校验;check_library 查字段完整性——每个 pin 有没有电容、每条弧有没有配套的 transition 表、功耗弧与延迟弧索引网格是否对齐。CCS 库还要确认 output_current_* 真实存在,防止拿到"NLDM 壳"。
第二层:单调性与合理性扫描。 延迟应随负载单调增、随输入 slew 单调不减(大部分情况);功耗随 slew 增大。自动化脚本扫全库查表数据,违反单调性的点几乎必然是仿真收敛出了问题。索引范围越界检查也在这一层——所有表的外推风险点要列出清单。
第三层:SPICE 抽样回归。 随机抽一批(单元 × 弧 × 工作点),用独立 SPICE 设置重仿真,对比 STA 引擎用该库算出的延迟,签核库的典型要求是偏差在 ±3% 以内(CCS)。这层抓到的是模型范式本身的误差,NLDM 在先进节点过不了这一关——这正是 NLDM 与 CCS 时序模型 里那 5%~15% 误差的出处。
第四层:设计级冒烟。 拿一个真实小设计(或 foundry 参考 flow)跑综合 + STA + 功耗,确认库能被下游工具链无警告消费:时序单位、阈值定义、operating condition 名称都要与签核环境的约定对齐。OCV/AOCV 所需的 derate 表格与 LVF 数据的配套检查也在这里,相关背景见 OCV 与 AOCV 深度降额。
四层全过后,库连同 PDK 版本号、特征化配置版本、模型卡版本一起封版归档——这套版本基线纪律见 PDK 版本与数据基线。半年后如果有人问"这个 .lib 是用哪版模型卡标的",答不上来就是交付流程的失职。
交付物清单也值得明确:除了各角点的 .lib 与编译后的 .db,通常还包括给功耗签核用的 APL/current 数据、给噪声分析用的 CCS noise 组、给统计时序用的 LVF 矩数据,以及一份特征化报告(索引网格、精度配置、回归通过率、已知偏差项)。下游团队拿到库的第一件事应该是翻这份报告,而不是直接往 STA 里塞——报告里"已知偏差项"一节往往写着"某族大驱动 buffer 在超低电压角下采样偏稀"这类关键信息,漏看就是用库的人自己承担风险。
六、常见翻车点速查
| 症状 | 根因 | 预防 |
|---|---|---|
| 硅后频率系统性偏低 | 索引网格没覆盖实际 slew 区间,STA 外推 | 网格按设计统计分布定,留 20% 裕量 |
| hold 违例集中在某触发器族 | setup×hold 只做一维扫描 | 先进节点上二维包络扫描 |
| 新旧库 STA 结果漂移无法归因 | 两次特征化配置/模型卡不同 | compare_liberty diff 入库,版本基线绑定 |
| CCS 库功耗/延迟偶发异常 | 个别网格点仿真不收敛 | 单调性扫描 + 失败作业强制重跑率统计 |
| 下游工具报警告但能用 | 阈值/单位定义与工具默认不一致 | 设计级冒烟流程强制零警告 |
这一篇在知识体系里的位置
- 本篇是库数据链的源头:它产出的
.lib字段结构见 Liberty 库与多视图,模型范式取舍见 NLDM 与 CCS 时序模型; - 上游输入:单元从 PDK 长出来的过程见 stdcell 与 PDK 库视图;
- 下游消费:库被签核引擎消费见 Signoff STA 与 PrimeTime,角点组织见 角点修剪与 MMMC 精简,功耗签核的电流波形源头见 APL 电流波形特征化。
总结
库特征化就是把标准单元的晶体管级行为按(弧 × slew × 负载 × PVT)网格做海量 SPICE 仿真、提取成 Liberty 查表数据的有损压缩流程;库的质量天花板由激励网格与 PVT 覆盖决定,靠 compare_liberty、单调性扫描、SPICE 抽样回归和设计级冒烟这四层验证守住——源头标歪一毫米,下游签核就会偏出一整条时序路径。