低阈值单元使用管控:LVT/ULVT 比例上限的制定依据、分模块配额与违规检查
更新时间:2026-10-05。低阈值单元使用管控是后端物理设计里一条「不写进 SDC、却处处被检查」的隐性约束:LVT(Low Vt,低阈值电压单元)和 ULVT(Ultra-Low Vt,超低阈值电压单元)能显著缩短单元延迟,是修 setup 违例的利器,但它们的亚阈值漏电流比常规 SVT(Standard Vt)单元高一到两个数量级。如果不加管控,优化工具会在时序压力下把全设计铺满 ULVT,漏电流直接爆表。这一篇把管控策略讲透:上限比例从哪来(漏电预算反推)、为什么不是线性放宽(时序收益递减)、配额怎么分模块下发、以及签核前怎么自动检查违规。读之前建议先有 Multi-Vt 漏电回收 和 STA setup 修复之 Vt swap 与 sizing 的基础,功耗签核侧见 功耗签核 Voltus 与 RedHawk。
本文要回答的问题
- LVT/ULVT 单元的延迟收益和漏电代价各是多大,为什么必须设使用上限?
- 全局比例上限(比如 ULVT ≤ 5%)是怎么从漏电预算反推出来的?
- 为什么说时序收益随低阈值单元占比递减,这对上限制定意味着什么?
- 分模块配额怎么定——接口模块、存储周边、时钟树各该给多少?
- 签核前怎么自动检查违规,超标了往哪个方向收敛?
一、低阈值单元的收益与代价:先看数量级
CMOS 单元的阈值电压(Vt)决定了它「多难导通」。Vt 越低,同样栅压下驱动电流越大、延迟越小,但截止态的亚阈值漏电流随 Vt 降低呈指数上升——大致规律是 Vt 每降 60-90mV,漏电流涨一个数量级。一个典型的 7nm 工艺库,同一逻辑功能、同尺寸的三档单元对比是这样的:
| 单元档位 | 相对延迟 | 相对漏电流 | 动态功耗 | 典型用途 |
|---|---|---|---|---|
| SVT(标准阈值) | 1.00 | 1x | 基准 | 默认全部逻辑 |
| LVT(低阈值) | 0.80-0.85 | 10-30x | 略高 | 关键路径主力修复 |
| ULVT(超低阈值) | 0.65-0.75 | 50-150x | 更高 | 最后 5% 的极限路径 |
注意这张表的不对称性:从 SVT 换到 ULVT,延迟只省 25-35%,漏电却涨两个数量级。也就是说低阈值单元是「用功耗买时间」的交易,而且汇率极差。动态功耗一栏也别忽略:低阈值单元为了达到同样的驱动能力,内部晶体管通常更宽、栅电容更大,切换功耗跟着涨 5-15%,在高翻转率的网络上(时钟、总线、数据通路深处)这笔账同样要算。还有一个隐形成本是良率与噪声:低阈值单元对电源噪声和串扰更敏感,在 IR drop 偏大的区域,ULVT 的实际延迟收益会比库标称值打折扣,签了个「账面上达标、硅上不达标」的假闭环。如果让优化引擎自由发挥,一个 10M 实例的设计哪怕只混进 20% 的 ULVT,静态功耗就可能翻 5-8 倍,直接把漏电预算(handheld 芯片通常给漏电留总功耗的 20-30%)打穿。
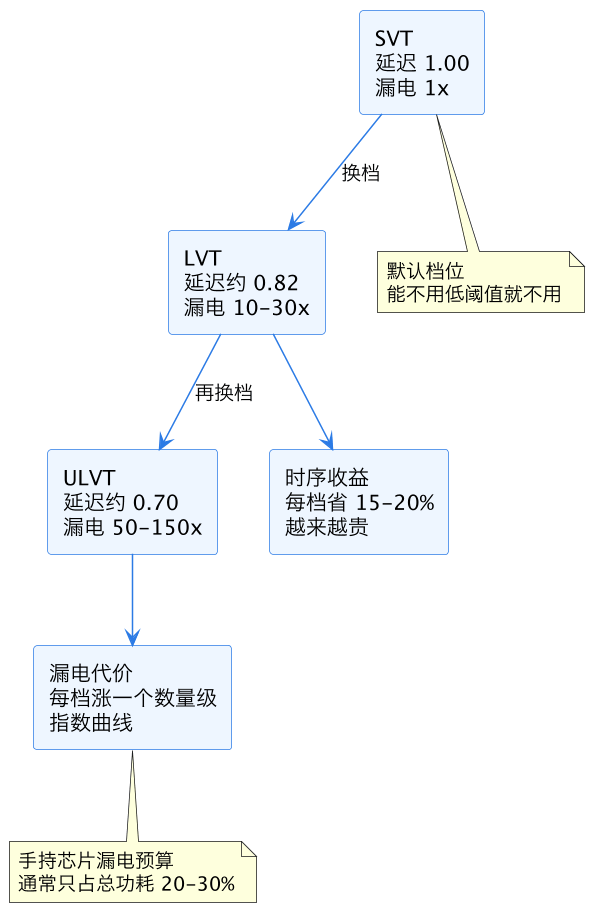
这张图是全部管控策略的出发点:收益是线性甚至次线性的,代价是指数的。所以「上限」不是工程洁癖,而是预算约束下的必然产物。
二、全局上限的制定依据:从漏电预算反推
上限不是拍脑袋定的「5%」或「10%」,而是一条反推链。第一步,从整芯片功耗预算里划出漏电份额。比如总功耗预算 800mW、目标场景下活动因子较低,决定漏电不能超过 200mW。第二步,用功耗签核工具(或库厂商给的每档位典型漏电密度表)估算「全 SVT 基线漏电」——假设设计 8M 实例、全 SVT 时静态漏电 60mW,那么留给「换档带来的漏电增量」的空间是 140mW。第三步,按增量漏电把空间折算成单元数:若单个 ULVT 平均增量漏电约是 SVT 的 100 倍、LVT 约 20 倍,就可以解出类似「ULVT 不超过 4%、LVT 不超过 18%」的组合上限,实际项目里通常再加 30% 的安全余量,报出 ULVT ≤ 3%、LVT ≤ 12% 这样的执行口径。
举一个具体的算例把抽象链路钉实:某 8M 实例的 SoC,功耗预算 800mW,分给漏电 200mW,全 SVT 基线 60mW,增量空间 140mW。库厂商表格给出该工艺最热 FF 角下平均每位宽等效单元的漏电增量——LVT 约 +2nW、ULVT 约 +10nW。若全用 LVT 方案,140mW 理论上能覆盖 70M 单元次,远超设计规模,说明 LVT 可以相对宽松;但 ULVT 方案 140mW 只够 14M 单元次的零头换算,折到 8M 实例上约 17%,再加安全余量和「ULVT 集中在高活动区会附带动态功耗」的折算,执行口径砍到 3-5% 是合理的。这个算例的重点不是数字本身,而是每一步都有出处,评审时能被逐行挑战。
这条链上有三个容易被低估的输入。一是温度:漏电流对温度极敏感,125°C 的漏电可能是 25°C 的 10-20 倍,预算必须按签核角(见 工作条件 PVT 选择)的最热角算,不能拿室温典型值。二是工艺离散:fast 角的漏电远高于 typical 角,上限要按漏电最大的角(通常是 FF、高压、高温)核算。三是 dark silicon 与 power gating:如果模块有关断态,关断时的漏电不计入活动预算,但管控口径里仍要按「全开」场景核算峰值,避免热设计被偷袭。
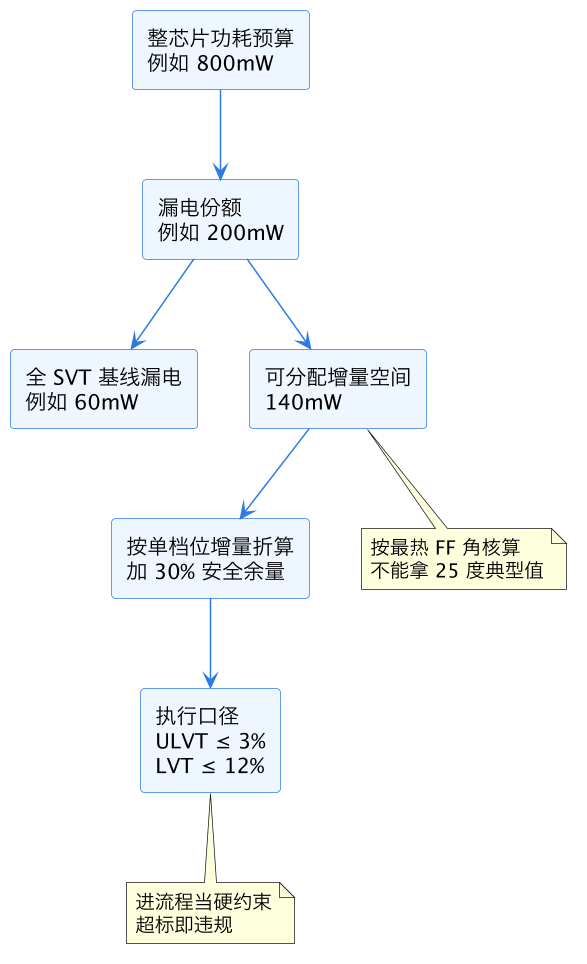
这张反推链图说明一件事:比例上限是个「算账结果」,不是风格偏好。预算变了(比如产品从手持转向插电设备)、工艺角变了(换 corner 库)、甚至设计规模变了,上限都应该重算而不是沿用旧数字。
三、时序收益递减:为什么上限宁可偏紧
第二个依据来自优化侧的经验规律:低阈值单元的时序收益随使用比例快速递减。直觉上看,设计里的违例路径呈长尾分布——最差的 1% 路径吃掉了绝大多数负 slack,它们集中在少数几条关键链上。VLSI 布局布线工具的 Vt swap 优化总是先换这些「刀刃上的单元」:前 1-2% 的 LVT/ULVT 替换能修掉 60-80% 的总负 slack;再往后,每一批替换面对的都是 slack 本来就很小的路径,单单元换档只能省 10-20ps,边际收益断崖式下跌。到 8-10% 之后,继续加低阈值单元基本只是在为「差几 ps 的边角路径」付费,修违例效率趋近于零,漏电却照付。
还有一个常被忽视的对照实验:把同样的额度换成 sizing(放大驱动)能解决多少问题?在路径的线负载占比高时(深亚微米下很常见),upsizing 的收益往往不输换档,而它的漏电代价只是线性增长。所以健康的优化顺序是「先 sizing、再 LVT、最后 ULVT」,低阈值额度是留给 sizing 已经到顶(驱动最大档或面积受限)的路径的。如果检查发现某模块 ULVT 用得多但路径上还有大量小驱动单元,说明优化引擎的 cost 权重没调好,或者额度放得太松让引擎偷懒走了捷径。
经验曲线的形状大致是:累计修复的 TNS(Total Negative Slack,总负 slack)随低阈值占比呈对数型饱和。这带来一个反直觉的策略结论:上限定得偏紧一点,时序代价很小,漏电收益却很大。把 ULVT 从 8% 砍到 3%,丢掉的时序修复能力可能不到 10%,漏电增量却省掉一半以上。所以成熟团队的管控口径往往是「够用即停」:先按 3-5% 的 ULVT 额度跑一轮优化,看剩余违例分布,再决定是否为特定模块申请追加,而不是一开始就给足。
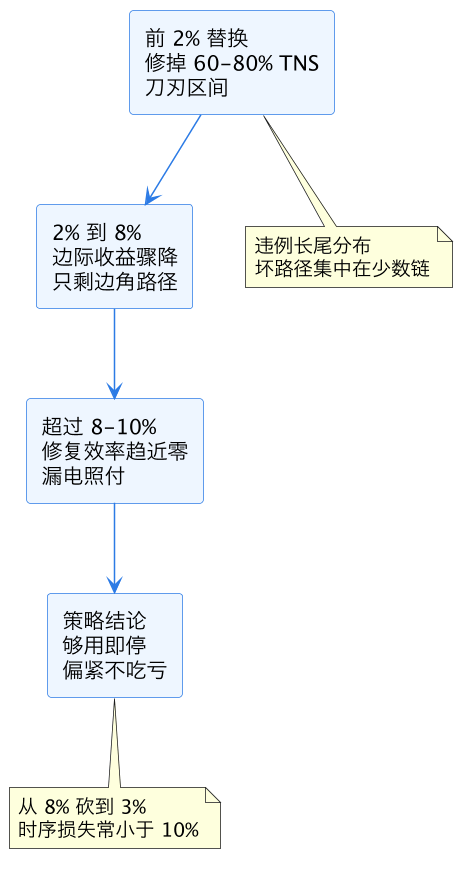
这张分段图解释了管控策略为什么敢收紧:收益曲线前陡后平,而代价曲线全程陡峭,两条曲线的交叉点(性价比最优区)往往就在很低的占比处,留出余量给真正需要的模块才是全局最优。
四、分模块配额:一刀切不如差异化
全局上限只是天花板,落地时必须分模块下发配额,因为不同模块的「低阈值性价比」差异巨大。常见的差异化逻辑如下表:
| 模块类型 | 建议配额取向 | 理由 |
|---|---|---|
| CPU 核心关键流水线 | ULVT 额度最高(如 5-8%) | 频率目标最激进,路径长尾深 |
| 接口与时钟域桥接 | 中等 LVT 额度 | 跨域路径紧但总量小 |
| 存储器周边译码 | 中等,偏 LVT 不用 ULVT | 路径规整,sizing 替代空间大 |
| 时钟树与时钟网络 | 按 CTS 策略单列 | 见 CTS buffer 与 inverter 选型,低阈值影响 skew 与功耗双重账 |
| 常开模块(always-on) | 极低或零额度 | 常开域漏电 24 小时挂着,一级敏感 |
| 可关断的大块逻辑 | 可适度放宽 | 有关断态兜底,活动期才计漏电 |
表里的数字都是「相对取向」,不是通用标准——不同产品的频率目标、散热条件、电池容量差异很大,同一团队不同代际芯片的配额表也会漂移。真正可复用的是差异化背后的三问:这个模块的路径长尾有多深(决定需不需要 ULVT)、它的漏电挂在账上的时间有多长(常开与否)、它有没有结构替代方案(sizing、插 retiming 寄存器、改 floorplan)。三问答完,配额基本自己就浮出来了。
配额下发的工程做法有两种。一种是在综合与 PnR 的优化脚本里按层次设 set_max_leakage_power 或工具专属的 max-vt-percentage 属性(不同工具命令名不同,思路一致:给每个 hierarchy 一个低阈值用量上限),让优化引擎在额度内自主分配。另一种是后 ECO 阶段的人工配额:全局先跑自动优化,再把「额度余额表」发给各模块负责人,谁要追加谁举证(给出该模块的违例分布和已用额度)。两种做法都依赖一个前提:额度口径必须和统计口径一致——按实例数、按面积还是按漏电贡献计量,团队内要统一,否则「3%」在 A 模块按单元数算、在 B 模块按漏电算,检查脚本永远对不齐。
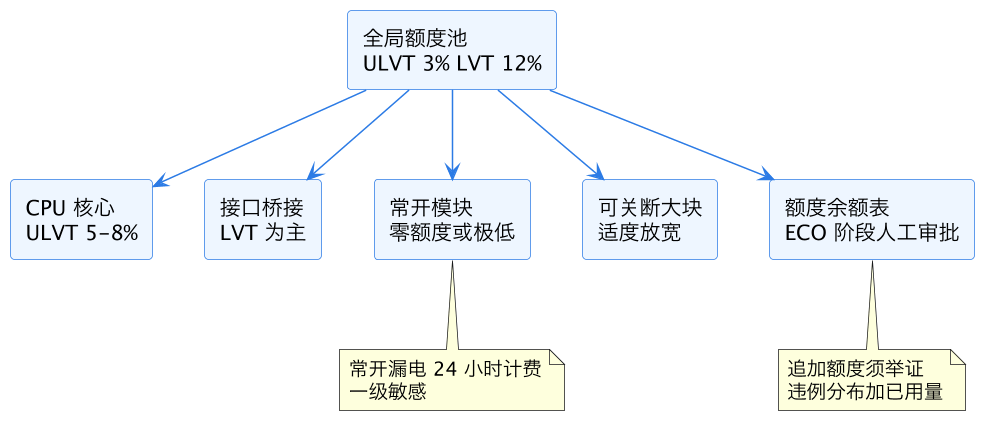
这张图表达的是配额的树状结构:全局池是硬顶,各模块拿到的是子额度,ECO 阶段用余额表收口。注意常开模块的「零额度」不是歧视,而是它的漏电没有时间平均可言。
五、违规检查与收敛:签核前的最后一道闸
策略定完,最后一环是检查。违规检查分三层。第一层是统计检查:脚本遍历网表,按档位统计每个模块的 LVT/ULVT 占比(用单元名后缀或库属性过滤),与配额表逐模块比对,超标即出报告。第二层是归因检查:超标的单元聚在哪几条路径上?如果集中在同一条 critical chain,说明该模块的约束或 floorplan 有结构性问题(比如跨模块路径太长),治本要回头改结构而不是追加额度。第三层是漏电复核:把实际 Vt 分布喂回功耗签核(见 功耗签核 Voltus 与 RedHawk),确认最热角下漏电仍在预算内——比例达标不代表漏电达标,因为 ULVT 如果集中在高活动率区域,动态功耗也会跟着涨。
超标后的收敛顺序建议反过来走:先在超标模块内做降级 swap(把 slack 富裕路径上的 ULVT 换回 LVT、LVT 换回 SVT),这一步在 Multi-Vt 漏电回收 里有完整流程;不够再申请临时额度;最后才动全局上限。一个配套的好习惯是把额度表和检查结果纳入每周回归,像 ASIC CI/CD 回归 那样自动出趋势图——Vt 占比的缓慢爬升(每次 ECO 加 0.2%)是项目后期漏电失控的最常见前兆,靠单次签核抓不住,靠趋势一眼就能看到。
这一篇在知识体系里的位置
本篇属于 EDA 后端「功耗-时序权衡」主线:上游是 Multi-Vt 漏电回收(已定额度内怎么花得省)和 STA setup 修复之 Vt swap 与 sizing(换档的修复语义),本篇回答的是「额度本身怎么定、怎么管」;下游衔接 功耗签核 Voltus 与 RedHawk(用实际 Vt 分布复核漏电)与 工作条件 PVT 选择(漏电预算按哪个角核算)。时钟网络上的特殊口径见 CTS buffer 与 inverter 选型。
总结
低阈值单元使用管控的本质是「用预算管住指数增长的漏电」:上限从最热角的漏电预算反推,按收益递减规律宁可偏紧,分模块差异化下发额度(常开域从严、可关断域从宽),最后用统计检查、归因检查和漏电复核三层闸门收口,并把 Vt 占比趋势纳入回归防止额度被 ECO 一点点蚕食。