dist 权重验证:卡方检验思想、样本量估算与覆盖率佐证三件事讲透
更新时间:2026-10-01。约束随机验证里,
dist是表达「我希望某些值出现得更频繁」的核心语法——写法本身在 SV constraint inside 与 dist 和 SV 约束完整指南 里已经讲透。但写法对不代表结果对:仿真器求解器有实现差异、约束互相叠加会扭曲权重、soft约束被覆盖后分布悄悄漂移。这一篇专门回答一个收尾问题——怎么验证 dist 权重分布真的按预期落地。这是长尾专题,属于「写了约束之后怎么证明它工作」的方法论,和 随机稳定性与种子管理 一起构成随机验证质量闭环的两端。
本文要回答的问题
- dist 权重验证为什么不能靠「跑几百次看一眼直方图」?
- 卡方检验的思想怎么搬到验证环境里最少的代码落地?
- 权重 1:100 的稀有 bin,跑多少次样本才敢说「分布对」?
- covergroup 的
at_least和统计检验是什么关系,能否互相替代? - 验证结论怎么写进报告,让 review 的人不用重跑也能信服?
一、问题定性:为什么 dist 验证是「统计假设」问题
先明确一个常被混淆的事实:dist {0 := 10, 1 := 90} 写的不是「10% 和 90% 的保证」,而是每次随机化时取到 0 和 1 的概率权重。单次结果没有任何信息量;只有样本足够多时,频率才依大数定律收敛到权重比例。所以 dist 权重验证本质是一个统计问题:给定 N 个观测样本,各取值的实际频次与期望频次的偏差,是「随机涨落」还是「分布真的错了」?
这个问题之所以难,有三个现实原因。
第一,期望不好算。权重写的是 10:90,但如果同一变量还叠了别的约束(x inside {[0:7]}、soft x > 2 被 inline 覆盖、求解器对 solve before 的分桶),真实的边缘分布可能偏离 10:90。验证前必须先回答「理论期望是什么」,而这一步常常要手动推一遍约束叠加后的有效分布。
第二,稀有项代价高。权重 1:1000 的 bin,期望一千次才出现一次。跑三千次样本看到它出现 1 次还是 5 次,频率差五倍,但都在统计涨落范围内——「稀有 bin 没打到」既不能证明对也不能证明错。
第三,相关样本不独立。如果每个样本来自同一次仿真的连续随机化(比如 sequence 里反复 randomize),前一次的解空间状态可能通过 randc 历史、约束模式切换影响后一次,样本独立性打折,统计公式的适用前提就松动了。
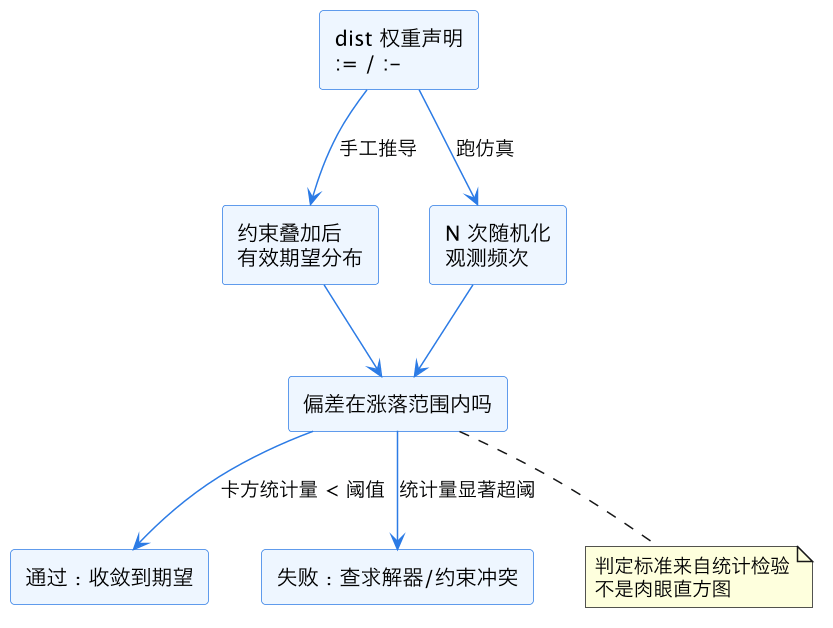
上图是全篇的主线:dist 验证不是「看一眼」,而是「期望推导 → 采样 → 统计判定」三步流水线。下面三节分别展开这三步。
二、卡方检验思想:给「偏差」一个可计算的阈值
卡方检验(chi-square test)回答的问题形式化后很朴素:k 个取值,期望频次 E_i,观测频次 O_i,统计量
χ² = Σ (O_i - E_i)² / E_i衡量的是观测偏离期望的总程度。χ² 越大越可疑;大到超过自由度 k-1 对应的临界值(比如 95% 置信下 df=3 时约 7.81),就有理由说「分布与声明不一致」。公式不需要背,记住三条使用要点就够落地。
第一,每个 bin 的期望频次最好 ≥5。期望太小的稀有 bin 会让 (O-E)²/E 被小分母放大,检验失真。处理方法是把稀有 bin 合并检验,或者干脆对稀有 bin 单独用「N 次内至少出现一次的概率」这种二项分布判据,不塞进卡方。
第二,临界值查表,不要拍脑袋。自由度 = bin 数 - 1。常用一行:df=1 时 3.84,df=2 时 5.99,df=4 时 9.49(均为 95% 置信)。环境里落地时,把这几个数写成查找表即可,不需要引入统计库。
第三,检验失败不等于约束写错,先查期望推导。χ² 超标的最常见根因不是求解器 bug,而是验证者把「声明权重」当「有效期望」——忘了 inline 约束、soft 覆盖、constraint_mode 关掉了某条约束。检验只是把分歧摆出来,分歧在声明还是在推导,要回到第一节那张图的左半边去查。
在验证环境里落地,最小实现是一个 scoreboard 级的计数器加一个函数:
int obs[int];           // value -> count
int N = 0;

function void sample(int v);
  obs[v]++; N++;
endfunction

function real chi2(int expect_pct[int]);
  real s = 0.0;
  foreach (expect_pct[v]) begin
    real e = N * expect_pct[v] / 100.0;
    real o = obs.exists(v) ? obs[v] : 0;
    s += (o - e) ** 2 / e;
  end
  return s;
endfunction
几十行代码,回归跑完调一次 chi2(),超阈值就 uvm_error。这比「人肉翻日志看直方图」可重复得多,而且能进 CI 门禁。日志侧的分级打印可以沿用 UVM report 与 verbosity 控制 的约定,把频次表放在 UVM_HIGH 级,平时不刷屏。
三、样本量:跑多少次才敢说「分布对」
这是 dist 权重验证里被问得最多、也最容易拍脑袋的问题。给一个可操作的估算路径。
对期望占比 p 的 bin,N 次采样中观测占比的标准差约为 sqrt(p(1-p)/N)。想让观测占比以约 95% 概率落在期望值的 ±d 相对误差内,需要 N ≈ 4(1-p) / (p·d²)。几个典型数字感受一下量级:
| 期望占比 p | 相对误差 d | 所需样本量 N(约) |
|---|---|---|
| 50% | 10% | 400 |
| 10% | 20% | 900 |
| 1% | 50% | 1,600 |
| 0.1%(1:1000) | 100% | 40,000 |
| 0.1% | 50% | 160,000 |
表里的规律一目了然:占比越小,想精确验证越贵,而且是按 1/p 线性变贵。权重 1:1000 的 bin 想把频率验证到 ±50% 以内,需要十六万次随机化——单次仿真可能跑不起,要靠多种子回归合起来凑样本(前提是种子间分布一致,见 随机稳定性与种子管理 对求解器稳定性的讨论)。
工程上的妥协策略分三档。主权重 bin(占比 ≥10%):卡方检验全量做,样本几千到一万即可,成本低收益大。中稀有 bin(1%~10%):只查「观测占比落在期望的 2~3 倍涨落带内」,不做精确检验。极稀有 bin(<1%):放弃频率验证,改用「回归全程至少命中一次」的定性判据,配合覆盖率工具确认它确实被采到——这类 bin 的验证目标本来就不是「频率精确」,而是「不是死 bin」。
还有一个常被忽略的预算项:样本量要算进回归时长。十六万次随机化如果每次伴随一笔完整总线事务,可能就是几天的仿真。所以 dist 权重验证通常在单元级环境(只跑激励生成,不带完整 DUT 交互)里做采样——把 driver 摘出去, sequence item 随机化后直接进统计器,一秒钟几万次。这是 dist 验证和标准功能验证最大的工程差异:它要的是统计样本,不是功能场景。
四、覆盖率佐证:covergroup 与统计检验的分工
很多人第一反应是用 covergroup 验 dist——「bins 打到了不就说明权重起作用了吗」。打到了和频率对,是两件事。covergroup 的 bin 命中只证明「该值出现过」,at_least 选项(见 covergroup options goal 与 at_least)能把门槛提到「至少出现 k 次」,但它表达的是下限,不是比例。一个权重 90% 的 bin 和一个权重 10% 的 bin,只要 at_least 设得低,覆盖率报告上长得一模一样。
所以正确的分工是:
- covergroup 负责完备性:每个声明的取值/bins 区间都被采到(覆盖空洞 = 分布验证的前提不成立,可能是约束把某些值彻底排除了)。
- 统计检验负责比例性:在「都被采到」的前提下,各 bin 的频次比例与期望一致。
get_coverage()与 bin 命中计数:很多仿真器的 covergroup API 能读出每个 bin 的 hit count,这正好是卡方检验的输入——如果环境已有 covergroup 在采,验证代码可以直接复用 hit count,不必另起计数器,避免两份统计漂移。
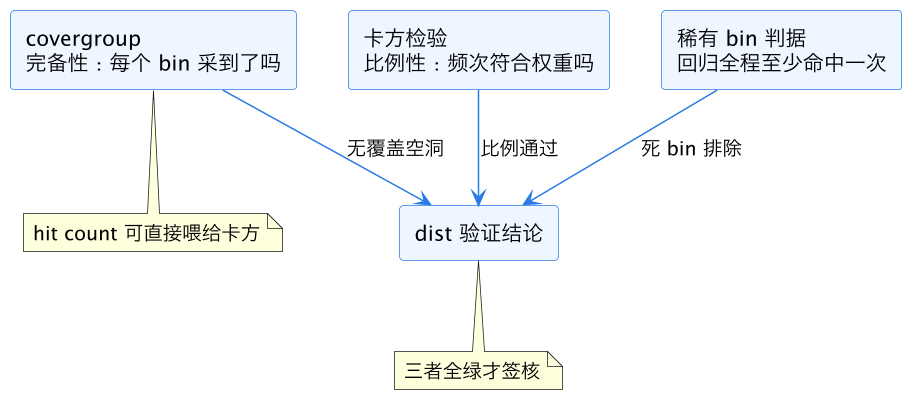
这张三件套图是收尾门禁的完整形态:任何一项红了,结论都不成立。覆盖率 100% 加卡方通过,才算「dist 权重分布验证完成」;只有前者,说明值域覆盖到了但比例没人担保;只有后者,样本可能根本没覆盖全取值空间,检验自由度就不对。
最后说结论怎么写。一条可辩护的 dist 验证报告至少包含:声明的权重、推导后的有效期望分布(含约束叠加说明)、样本量 N 与来源(单跑还是多种子合并)、各 bin 的观测频次与期望频次、卡方统计量与对应自由度的临界值、稀有 bin 的命中证据。review 的人拿着这六样,不用重跑仿真就能判断结论是否可信——这套材料也直接对接 覆盖率收敛签核 里的签核证据清单。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下的长尾方法文。语法层承接 SV constraint inside 与 dist 与 SV 约束完整指南,这两篇讲「权重怎么写」,本篇讲「写完怎么证」。随机性质量侧与 随机稳定性与种子管理 互补:种子稳定性保证「换个 seed 分布不变」,卡方检验保证「分布本身是对的」。覆盖率侧落到 covergroup options goal 与 at_least 的门槛语义和 covergroup coverpoint bins 的分桶方式,签核侧汇入 覆盖率收敛签核。验证加权仲裁这类「分布即功能」的 DUT 时,本篇方法与 加权仲裁器公平性验证 直接配套。
总结
dist 权重验证的核心是把「感觉分布对」升级成三步流水线:先推导约束叠加后的有效期望分布,再用卡方统计量给「偏差」一个可计算的阈值(主权重 bin 几千样本即可、稀有 bin 按 1/p 变贵、极稀有 bin 降级为命中判据),最后用 covergroup 的完备性和 bin 命中计数做佐证——三件套全绿并把期望推导、样本量、统计量写进报告,分布验证才算签核。