FPGA 原型验证专题 26:事务处理器(Transaction Processor)原理与实现——SCE-MI 语义、三类通道与自研接口落地
更新时间:2026-09-13。本文是「ASIC FPGA 原型验证系统」的外围姊妹系列第一篇。原 20 册(06 原型验证系统全景与文档地图~25 真实激励驱动 ASIC 签核 SAIF 反标/边界,系列内自称 06~25)讲的是 Compiler 团队如何把 RTL 变成一台可上板的原型;从本篇开始的新系列讲 Compiler 之外、真实项目里占用人月最多的系统工程:怎么让软件/固件接到原型、怎么连真实接口、怎么规模化调试与采信结果。本篇与 21 激励注入与软硬协同 co-model/transactor 紧密咬合——62 讲激励协同的建模全景,本篇往下落到事务处理器的工程实现与 SCE-MI 通道语义。
这一篇在体系里的位置
21 激励注入与软硬协同 co-model/transactor已经说明:主机与 FPGA 速度相差三到五个数量级,逐周期 @(posedge clk) 喂激励的 testbench 不能直接搬到原型上——主机还没算完下一个激励值,FPGA 已经空跑了上万个周期。解决办法是事务级抽象:把"在某个时钟沿把某根信号驱动成某个值"上提为"发起一次完整的总线事务"。本篇负责把这句话变成可实现的硬件与软件结构:
- 事务在主机侧用什么数据结构描述、怎么编码成一帧;
- 这一帧怎么跨过主机-FPGA 物理链路(PCIe/以太网/专用线缆)进入 FPGA;
- FPGA 里谁负责把这一帧"拆开、按协议时序、一拍一拍"地驱动到 DUT 引脚上;
- DUT 的响应又怎么被"攒起来、合成一帧"传回主机;
- 高速侧时钟自由跑时,主机来不及喂怎么办(背压/credit/缓冲);
- 想要严格可复现的功能验证时,又怎么把自由跑的时钟"刹住"做成锁步。
读完本篇,你应当能为一个自研的、没有商用 transactor 的接口,自己设计并实现一套能用的事务处理器。
本文要回答的问题
- 为什么逐周期 BFM 上了原型必然失败?事务处理器到底"处理"了什么?
- SCE-MI 把跨主机-仿真器的通道分成 input / output / realtime(in/out/trace)三类,各自的时序语义和坑是什么?
- 一个 FPGA transactor 的内部结构长什么样(命令 FIFO、协议状态机、响应聚合、credit 计数)?
- 为什么注入侧的时序必须由 FPGA 自主决定,不能靠主机调用顺序保证跨通道先后?
- 确定性锁步模式和实时自由跑模式分别怎么实现、各自适合什么负载?
- 给一个自研接口写 transactor 的完整步骤、需要向 RTL 团队要什么、怎么复用 UVM 的 sequence/item?
- 多 transactor 之间如何做全局 barrier 和公共时基编排?哪些 bug 只有在实时模式才暴露?
一、从周期级到事务级:为什么必须有这一层
先把矛盾量化。一颗 SoC 原型即便被 TDM 降频到 5 MHz,每秒也有 500 万个时钟沿;主机上跑 C/Python 的激励程序,经过操作系统、PCIe 驱动、用户态缓冲区,一次往返的延迟通常在微秒到几十微秒量级。如果激励程序要在每个时钟沿决定下一拍驱动值,那么 FPGA 每秒钟会有几百万次"想往前走但主机还没给值"的停顿,等效速度从 MHz 一路掉到几十 Hz——比软件仿真快不了多少,原型的速度优势被彻底浪费。
关键的洞察是:**绝大多数接口协议,真正需要逐拍决策的信息只存在于"事务边界",而不存在于每个时钟沿。**一次 AXI 突发,主机软件关心的是"起始地址、长度、写数据数组、突发类型",至于 VALID/READY 握手哪几拍拉起、WSTRB 怎么摆、地址在 AR 通道停留几个周期,都是协议状态机可以根据 DUT 的反压自主决定的细节。一次以太网发送,软件给的是"这一帧的目的 MAC 和 payload",前导码、SFD、CRC、IPG 都应由硬件补全。
于是天然形成了两层职责:
| 层次 | 运行位置 | 时间粒度 | 决定什么 |
|---|---|---|---|
| 事务层(激励/检查程序) | 主机 CPU | 一次调用 = 一个事务 | 发什么内容、发多少、期望什么、按什么场景编排 |
| 引脚层(协议时序) | FPGA | 一个时钟沿 | VALID/READY、片选、时序间隔、CRC、重试 |
夹在两层之间、双向做"事务 ⇄ 引脚时序"转换的那块逻辑,就是事务处理器(transaction processor)。往 DUT 方向,它是一个带协议状态机的主设备/激励 BFM;从 DUT 方向,它是一个监控器/响应收集器。它在 UVM 世界里对应 driver+monitor 的硬件化身,在 SCE-MI 语境里对应 transactor proxy(主机侧)与 transactor shell(硬件侧)这一对。
二、SCE-MI 的三类通道:注入、回收、实时
SCE-MI(Standard Co-Emulation Modeling Interface)虽然最早为仿真加速器定义,但它的通道分类已成为所有协同/原型事务接口事实上的语义框架。理解三类通道比记住 API 更重要,因为它们的时序承诺完全不同,混用是原型协同最常见的错误来源。
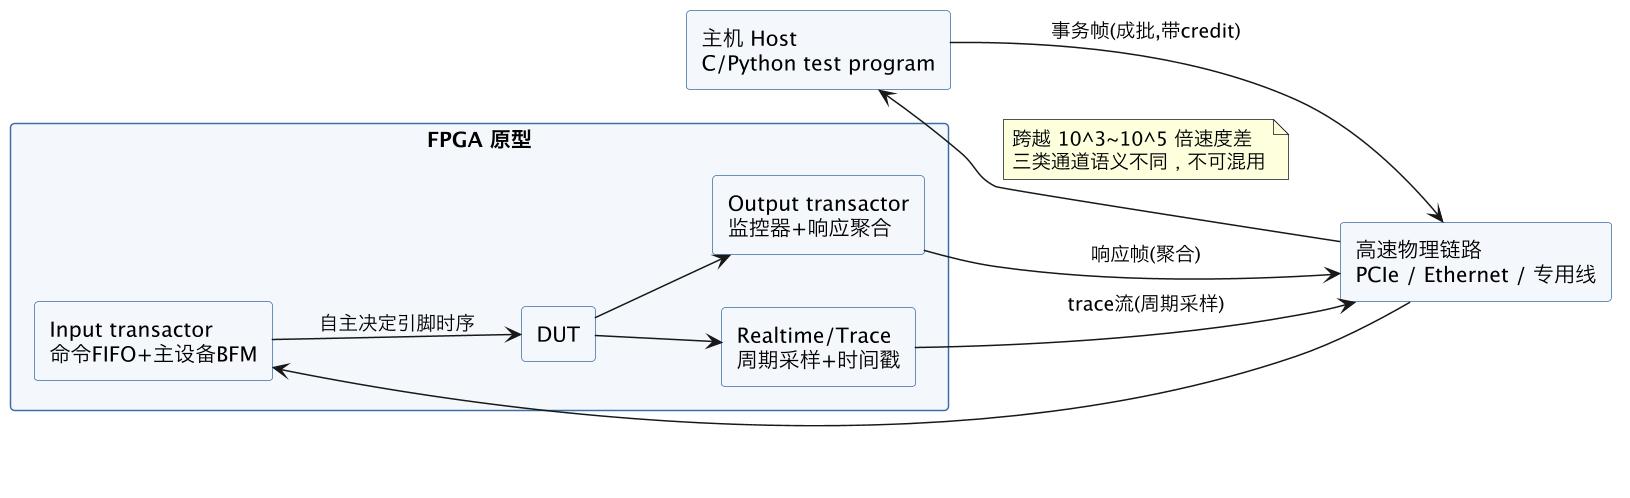
Input(注入/驱动通道):主机 → FPGA,携带要 DUT 接收或执行的事务(要发的包、要写的寄存器、要发起的 DMA)。它最重要的语义是:**主机只保证事务之间的逻辑顺序(FIFO),不保证、也无法保证每个事务在 DUT 时间轴上的精确注入周期。**一个 AXI write 事务到达 input FIFO 后,由 FPGA 里的主设备 BFM 根据 DUT 的 AWREADY/WREADY 反压自主决定何时发起、用多少拍发完。这意味着两件事:第一,凡是依赖"在第 N 拍注入"的测试,不能用 input 通道表达,必须改成 FPGA 侧自驱动(见第五节确定性模式);第二,跨多个 input transactor 的先后(比如"必须先配置再发数据")不能靠主机两次调用的返回顺序保证,因为两次调用可能在各自 FIFO 里排队、注入时刻不可控,需要 FPGA 内的同步原语(barrier/event)。
Output(响应/监控通道):FPGA → 主机,携带 DUT 产生的、需要软件判读的事务(收到的包、读到的数据、状态上报)。它的关键问题是溢出策略必须显式:DUT 在自由跑,主机回收是批量且滞后的,如果回传缓冲满了怎么办?三种策略——反压 DUT(会改变时序、可能制造假死锁)、丢包(必须显式计数并默认报错,否则静默丢响应会让检查器误判 PASS)、加大板载缓冲吸收突发。成熟做法是 output transactor 内部带水位机制,缓冲将满时要么提前通知主机限速,要么对 DUT 施加协议合法的反压(比如拉低某接口的 READY,这在真实世界本就可能发生),而绝不能静默丢弃。
Realtime / trace(实时观测通道):FPGA → 主机,携带周期采样的信号快照和时间戳(不是聚合后的事务,而是逐周期或按事件的原始波形片段)。它与 output 的区别在于保真目标:output 追求"事务正确、可丢中间拍",trace 追求"时间轴真实、带精确周期戳"。trace 数据量巨大,通常配合触发、窗口、qualifier 压缩,只在感兴趣的时间窗回传——这条管线的容量工程是后续 D3 篇的主题。本篇只需记住:判定功能正确性用事务通道,判定时序/性能用 trace 通道,不要拿事务回传的到达时间去推算 DUT 的周期级行为。
三、一个 FPGA transactor 的内部结构
下面是一个典型 input transactor 的可综合结构,几乎所有商用 transactor 和自研 BFM 都是这个骨架的变体。
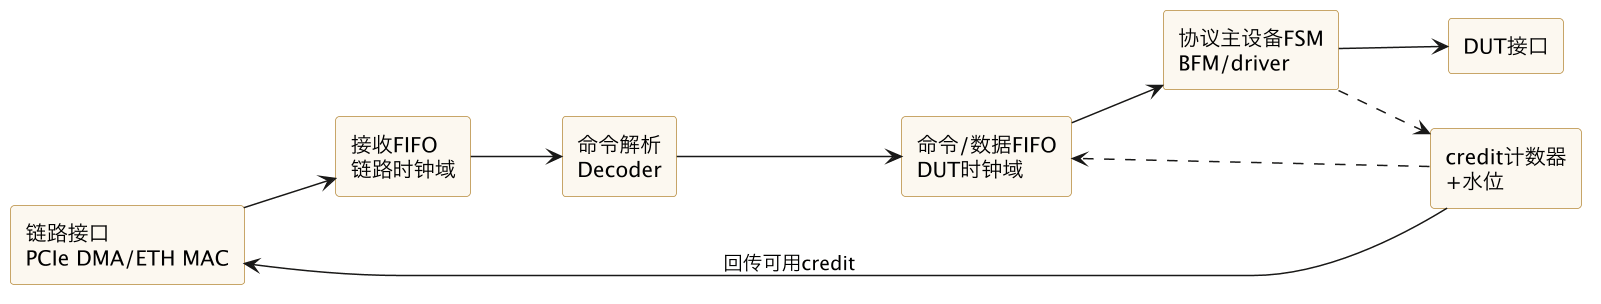
逐块说明:
- 链路接口与 DMA:主机把一批事务帧通过 PCIe(DMA 写入板载内存或 FPGA 内 BRAM)或以太网送入。这一段跑在链路时钟域,与 DUT 时钟无关,所以后面必然跟一个异步 FIFO 做 CDC。
- CDC 与命令解析:跨时钟域 FIFO 之后是 decoder,把变长帧解析成定长的"命令字 + 数据载荷"。命令字编码事务类型、长度、通道、选项;载荷是写数据或期望模式。
- 命令/数据 FIFO(DUT 时钟域):这是速度适配的核心缓冲。主机成批灌入,BFM 逐拍取出。FIFO 深度按"主机一次最长断供时间 × DUT 速率 × 每周期消耗字节"估算,并留足余量。
- 协议主设备 FSM:真正驱动引脚的可综合状态机。它从命令 FIFO 取一条事务,然后按目标协议(AXI/AHB/自定义)自主完成握手,期间响应 DUT 的 READY/反压。它"拥有"引脚时序的全部决策权——这正是 input 通道语义的硬件实现。
- credit / 水位:FIFO 剩余空间通过 credit 反馈给主机,主机据此决定还能发多少而不阻塞或溢出。这等价于把 AXI-Stream 的 TVALID/TREADY 思想搬到主机-FPGA 之间。
- Output 方向对称:DUT 接口 → 监控 FSM(识别事务边界)→ 聚合 FIFO(攒齐一个完整事务再打帧)→ CDC → DMA 回主机。监控器通常是被动的,只采样不驱动。
**为什么一定要 FPGA 侧有自主 FSM,而不能让主机经链路直接控制引脚?**除了速度,还有正确性:真实世界里 DUT 的对端设备本来就是自主的——一个以太网 MAC 不会等你软件发令再拉 TX_EN。让 FSM 在 FPGA 内自主握手,复现的才是"一个真实对端"的行为;主机逐拍遥控,复现的是"一个反应迟钝、抖动巨大的假对端",会把 DUT 里依赖正常握手时序的逻辑测出一堆伪故障,也掩盖真正的故障。
四、跨通道时序:为什么主机调用顺序靠不住
这是从"能跑 demo"到"能做严肃验证"最容易翻车的一点。设想一个常见场景:测试要先通过配置口(transactor A)写一个使能寄存器,再通过数据口(transactor B)灌入数据流。新手写成:
cfg_transactor_write(base + ENABLE, 1);   // 经 A
data_transactor_send(burst);              // 经 B
直觉上"先配置后数据"。但两条调用是两个独立的 input FIFO,主机把两个事务分别推入后立刻返回,FPGA 侧两个 BFM 谁先真正驱动到 DUT 引脚,是不确定的——取决于 FIFO 状态、仲裁、链路分包。可能数据先到、使能后到,测试时好时坏,成为典型的 flaky test。
正确做法是把"先后"这个约束显式下沉到 FPGA:
- Barrier / event 同步原语:在 FPGA 里实现一组可置位/等待的事件标志。配置事务的最后让 transactor A 置位 event;数据 transactor B 在发数据前
wait event。等待发生在硬件里,与主机调用返回时刻解耦,保证 DUT 时间轴上的真实先后。 - 单一编排 transactor:把有严格顺序关系的多个事务打包进一条"脚本",由一个 FPGA 侧编排器按序分发给各 BFM。
- 命令内同步字段:在自定义协议的命令字里带一个"栅栏位",BFM 执行到该命令时阻塞,直到所有指定通道排空。
经验法则:凡是你想在测试里表达的时序关系,都要在 FPGA 时间轴上有对应的硬件同步物;主机程序里语句的先后顺序,在 DUT 看来不构成任何时序承诺。
五、两种速度匹配模式:锁步确定性 vs 实时自由跑
同一个 transactor 基础设施,按"要不要让 DUT 时钟自由跑"可配成两种模式,它们验证的东西不同,必须按负载选择(方法学层面的对比见后续 E2 篇,这里讲实现)。
| 维度 | 锁步/确定性模式(locked) | 实时/自由跑模式(free-running / ICE) |
|---|---|---|
| DUT 时钟 | 受 transactor 控制:需要注入/检查时停或单步 | 板上晶振/MMCM 自由跑,永不停 |
| 注入时序 | 完全确定,可做到精确周期 | 由 BFM 按反压自主,时刻不固定 |
| 可复现性 | 高:同一事务流+同一种子→同一波形 | 需事务流/trace 录制回放+LFSR 种子近似复现 |
| 速度 | 慢(频繁停等握手),接近协同加速 | 快(MHz 级),能跑 OS/真实流量 |
| 适合 | 模块/子系统功能验证、bug 重放、对拍 | 软件/firmware、长时 soak、性能与活动测量 |
| 风险 | 把真实死锁类问题"等没了" | 偶现问题难复现、活动率受非确定调度影响 |
锁步模式的实现要点是时钟门控式握手:BFM 每次需要新事务前,先 gate 住 DUT 时钟(或拉高一个 hold),向主机请求,拿到事务后再放行约定数量的周期。这样注入时刻对主机程序是确定的,代价是吞吐崩塌——因此它只用于小场景、定向用例和对拍。
实时模式让时钟自由跑,靠深 FIFO + credit + BFM 自主握手吃满速度,能跑真实软件和真实外设(ICE,见 68 篇),但确定性要靠另外的工程手段补回来:
- 主机侧用随机数种子初始化 FPGA 内所有 LFSR/激励生成器,种子随 build_id 记录;
- 把事务流和 trace 录制下来,失败时在主机回放(即 62 篇强调的可复现性三件套);
- 多 transactor 用全局 barrier 和公共周期时基编排,让"相对顺序"确定、"绝对周期"放开;
- 跑错时优先在实时模式复现实时模式的 bug——试图用锁步模式重放一个自由跑才出现的死锁,常常因为时序被改变而无法重现。
一条硬纪律:软件验证负载、长稳 soak、功耗/活动采集负载必须实时跑且时钟不能停(停时钟会让活动率失真、让 OS 看门狗超时);轻量检查器和需要精确比对的覆盖率场景可以锁步。成熟团队让仿真、Emulation、原型复用同一套事务级 test program,只在三种引擎上切换速度匹配模式。
六、为自研接口写一个 transactor:落地步骤
当你的 SoC 有一块自定义接口、没有商用 transactor 可用时,按下面顺序做,能避开大多数返工。
- 先冻结事务级契约,再写硬件。和 RTL/验证团队一起定义"一个事务"在主机侧的 C 结构体:类型、地址、长度、数据指针、属性、期望响应、超时。这一步实质是在定义事务消息格式。尽量直接复用 UVM sequence_item 的字段布局,使同一套 item 既能在 UVM/仿真用,也能序列化成原型事务帧。
- **明确引脚时序归 BFM。**列出该接口所有握手信号和合法时序间隔,写成可综合 FSM。所有"可根据对端反压变化"的时序都进 FSM,不暴露给主机。
- **设计帧格式与命令字。**定长命令头 + 成批数据,带上序号(便于回收对账)、栅栏位(跨通道同步)、通道号(多实例复用)。
- 搭 CDC 与缓冲。链路域→DUT 域异步 FIFO;按最坏断供时间估深;加 credit 反馈。output 侧先定好"满了怎么办",默认策略应当是显式丢包计数并报错,绝不静默。
- 实现 barrier/event 同步原语,哪怕第一版用不到也预留寄存器接口,避免后期改帧格式。
- **加 trace 钩子。**在 BFM/monitor 的关键状态和事务边界引出可选的周期 trace 接口(复用后续 D 篇的采集基础设施),调试时救命。
- **写主机侧 API 与自检。**提供
open/send/recv/wait/reset,配一个没有 DUT 也能跑的 loopback(output 回接 input)做 transactor 自测——先证明管道自己是好的,再接 DUT。 - **版本对齐。**transactor RTL、主机驱动、帧格式三者版本号一起纳入 20 比特流烧录与四方版本一致 manifest/门禁 的 manifest,错配直接拒绝运行。
可复用的资产主要是协议无关的那一半:CDC FIFO、credit、DMA、帧解析、barrier、trace 钩子,做成通用库;协议相关的那一半(主设备/监控 FSM)按接口写。商用原型 Compiler 的价值很大程度上就是前者已产品化,你只补后者。
七、典型负载怎么接:真实软件、真实外设与闭环流量
- 真实软件栈:OS/驱动不经过事务通道,它把 DUT 当真实芯片、经真实(或速率适配后的)接口直接交互——这是 ICE 路线,走实时模式(68 篇展开)。事务通道主要服务于"人为构造的定向激励"和"真实软件产生不了的边界场景"。
- 真实外设/仪表:要接真实器件的接口走实时边缘,时钟不能停;接不了真实器件的(超高速、降速后对端不认)才退回事务级用 transactor 建模。
- 自闭环网络流量:DUT 吐出的以太网帧经 output transactor 回收、在主机做轻量协议处理(或直接环回)、再从 input 注回,形成自洽的高带宽背景流量。主机只在事务边界介入,线速由 FPGA 内环回保证,不被主机速度拖累。
- 仪表旁路:逻辑分析仪/真实测试仪作为独立见证者接在物理边上,不参与激励闭环,用来对 transactor 建模的保真度做独立校验——事务模型说"帧长这样",仪表要能独立看到一致的波形。
八、常见翻车点与排查清单
- 用主机调用顺序表达硬件先后 → flaky。改用 FPGA 内 barrier/event(第四节)。
- output 缓冲满了静默丢响应 → 偶发假 PASS。必须显式计数、默认报错。
- 把 input 当周期精确通道用 → 结果随机器负载飘。需要精确周期就上锁步或 FPGA 自驱动。
- CDC 没处理好 → 偶发数据撕裂。命令 FIFO 必须真异步、Gray 指针,不能靠"两边频率差不多"。
- 实时模式跑死锁类用例 → 时好时坏。死锁复现要在实时模式下用录制回放+固定种子,别指望锁步模式重现。
- 软件/活动负载误用锁步或停时钟 → OS 看门狗超时、活动率失真。这类负载必须自由跑。
- transactor 与比特流版本错配 → 帧解析错位、玄学问题。纳入 manifest 强校验。
- BFM 时序不够"像真实对端" → 测出伪故障或漏故障。用真实仪表旁路校准,BFM 必须响应合法反压。
- 缓冲深度拍脑袋 → 长突发中途断流。按主机最坏调度延迟 × 速率算,并留两倍以上余量。
- 多 transactor 无公共时基 → trace 无法跨通道对齐。编排层统一周期计数与时间戳。
与系列及现有篇目的链接
- 激励建模全景:21 激励注入与软硬协同 co-model/transactor
- 三种引擎的连接拓扑:34 FPGA 与仿真器互联 事务级桥接/SCE-MI
- 两种上板模式(本篇的操作姊妹篇):68 在电路仿真 ICE 与协同加速模式
- 比特流/组件版本纪律:20 比特流烧录与四方版本一致 manifest/门禁
- trace 与采集基础设施:22 Gate 域信号采集 ILA/trace/带宽深度权衡、42 片上 trace 系统
- 多 FPGA 分割与跨片(transactor 可能跨片部署):12 多 FPGA 分区算法 割集/容量/图划分、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频
- 体系总入口:06 原型验证系统全景与文档地图
总结
一句话总结:事务处理器是跨在"主机低速、按事务思考"和"FPGA 高速、按周期执行"之间 10³~10⁵ 倍速度鸿沟上的适配器——主机一次调用下发一个完整事务并成批推入高速通道,FPGA 内的 transactor 用"命令 FIFO + 自主协议 FSM + 响应聚合 + credit"把事务自主展开成多周期引脚时序、再把响应聚合回传,双方只在事务边界握手;通道按 SCE-MI 语义分 input(注入时机由 FPGA 自主、不能靠主机调用序保证跨通道先后)、output(响应聚合、溢出策略必须显式、丢包默认报错)和 trace(周期采样、带时基)三类;速度匹配有锁步确定性(BFM 控时钟、严格可复现、适合功能验证与对拍)和实时自由跑(时钟不停、适合真实软件/外设与性能活动测量)两档,选错模式会让死锁不复现或让活动率失真;给自研接口落地时先冻结可与 UVM item 复用的事务契约、再写协议相关 FSM,而 CDC/credit/DMA/barrier/trace 这协议无关的一半尽量复用成熟库,并用 barrier 把跨通道时序下沉到硬件、用种子+录制回放+公共时基补回实时模式的可复现性——这正是后续"接真实接口、做深调试"各篇的共同底座。